El 13 de octubre de 2026, un equipo conjunto de la Universidad de Stanford y Together AI presentó una nueva arquitectura de inferencia denominada HybridAgent (arXiv:2610.18861). En 11 pruebas de referencia multidisciplinares, sus variantes de 8B y 14B parámetros superaron a los agentes basados en LLM más avanzados y a marcos de trabajo especializados; el modelo de 14B rebasó a la mejor línea base en un 17,4 % de media. Al mismo tiempo, el sistema redujo el consumo de tokens de texto a 1/2,7 respecto a las líneas base de texto puro, recortando el uso total de tokens entre un 35,5 % y un 54,7 %.
La mayoría de los agentes autónomos actuales, al resolver tareas complejas con herramientas, articulan cada paso de su razonamiento mediante tokens de texto discreto. Cientos de palabras intermedias saturan la memoria de vídeo (VRAM) de la GPU y disparan la latencia del servicio. Confinar las deliberaciones internas a un espacio latente continuo y decodificar a texto solo en el momento de interactuar con el entorno exterior permite duplicar la velocidad de generación. Los recursos de cómputo ahorrados se traducen de inmediato en un mayor rendimiento para interacciones de largo recorrido.
Razonamiento plegado en espacio latente: reducción de tokens a un tercio
Los marcos tradicionales de tipo ReAct dependen de extensos soliloquios para avanzar en la resolución de problemas. Antes de realizar una búsqueda web o ejecutar código en Python, el agente genera cientos de tokens detallando su plan. Estas reflexiones intermedias no aportan valor a las herramientas externas, pero se ven forzadas a recorrer la proyección Softmax sobre todo el vocabulario. Esta decodificación autorregresiva consume un valioso ancho de banda de memoria en mera introspección.
HybridAgent redefine la frontera entre pensamiento y expresión. El modelo alterna con fluidez entre dos modos de operación dentro de un mismo proceso de generación. El modo latente asume el razonamiento interno recursivo, mientras que el modo texto gestiona las acciones externas. Los investigadores introdujeron las etiquetas <latent> y </latent> como anclas para alternar entre ambos modos. En el espacio latente, la red avanza un estado vectorial latente por cada pasada hacia adelante (forward pass), con presupuestos que oscilan típicamente entre 16 y 256 pasos.
Los datos de eficiencia presentados cubren tres frentes principales. El gasto de tokens de texto en modo híbrido cae a 1/2,7 de la línea base de texto, el total de pasos de generación se reduce hasta en un 54 % y la velocidad de inferencia de extremo a extremo se multiplica por 2,1. Al saltarse la proyección sobre el vocabulario y el re-embebido matricial, los estados latentes alivian drásticamente la saturación del ancho de banda de memoria.
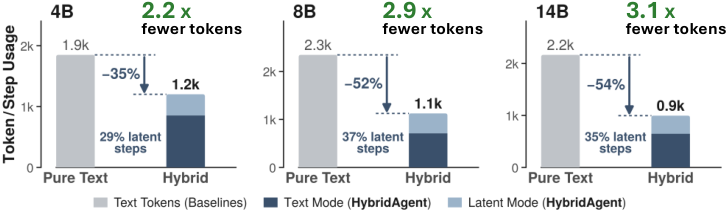 Figura: Evolución del consumo de tokens de texto y del total de pasos de generación de HybridAgent en escalas de 4B, 8B y 14B frente a líneas base de texto puro. Fuente: arXiv 2610.18861
A la aceleración de la velocidad se suma un importante ahorro económico. Calculando un coste de alquiler de 2,50 dólares por hora de GPU NVIDIA H100 y una utilización del 10 % del pico de cómputo en BF16, el coste de responder a un millón de consultas cae de 359 a 98 dólares en el modelo de 4B, de 439 a 121 dólares en el de 8B y de 470 a 176 dólares en el de 14B, lo que representa multiplicadores de ahorro de 3,7x, 3,6x y 2,7x respectivamente. Esta estimación incorpora con rigor la potencia de cálculo consumida por los pasos latentes en la red troncal, sin limitarse a computar los tokens omitidos.
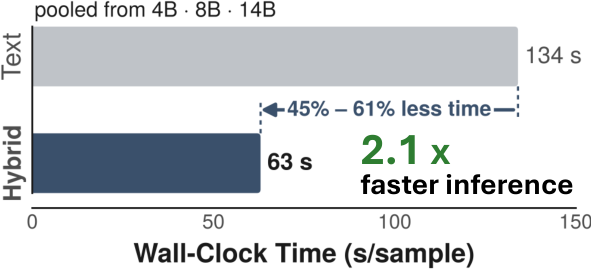 Figura: Factor de aceleración en el tiempo de inferencia de HybridAgent en tres escalas de modelo. Fuente: arXiv 2610.18861
Mapeo residual entre dos contextos: la caché KV evita la recodificación
Hacer que vectores continuos y caracteres discretos convivan en una misma red neuronal exige resolver la transición entre espacios de representación. El equipo diseñó una capa adaptadora residual denominada HybridLink. Este módulo proyecta el estado oculto de la última capa del modelo directamente hacia el espacio de incrustación (embedding) de entrada. De este modo, los estados latentes se reutilizan como vector de entrada para el paso siguiente sin requerir una decodificación inversa a texto.
Este diseño preserva la memoria de trabajo a lo largo de múltiples turnos de conversación. Los prompts iniciales, los vectores de deliberación latente y las observaciones devueltas por las herramientas se almacenan de forma conjunta en una única caché de claves y valores (KV) continua. Cuando el agente concluye la llamada a una herramienta, no es necesario vaciar el contexto ni volver a codificarlo; los cálculos posteriores continúan sobre la caché existente en VRAM, eliminando pasadas hacia adelante redundantes.
El entrenamiento de este sistema híbrido recurre a un flujo de trabajo en dos etapas. La primera fase, HybridSFT, implementa un esquema de dos pasadas autocondicionado. La primera pasada emplea forzado de docente (teacher forcing) para generar las entradas latentes deseadas, mientras que la segunda sustituye los embeddings reales por las predicciones generadas por el propio modelo. Las posiciones de texto se optimizan con pérdida de entropía cruzada y las latentes con pérdida de regresión, actualizando conjuntamente la red troncal y HybridLink. En la segunda fase, HybridRL aplica aprendizaje por refuerzo para perfeccionar la toma de decisiones sobre cuándo deliberar en el espacio latente y cuándo emitir acciones en texto.
La infraestructura se apoya en extensiones de verl y vLLM, y fue entrenada en un clúster de 32 GPUs NVIDIA H100. Al confinar el razonamiento intermedio dentro de los núcleos Tensor Core, los controladores de memoria se liberan de continuas lecturas y escrituras del vocabulario, preservando el ancho de banda para las interacciones externas efectivas.
Vectores latentes interpretables: estados ocultos con claridad semántica
La principal reticencia técnica hacia el razonamiento latente ha sido su condición de caja negra: si las deducciones son secuencias de vectores en coma flotante, la depuración y las auditorías de seguridad se complican. Sin embargo, la vía de reconstrucción propuesta en el artículo prescinde de decodificadores auxiliares. Al calcular la similitud coseno entre el vector latente proyectado por HybridLink y las incrustaciones de tokens del vocabulario, el vecino más próximo revela un pseudotexto legible. La fórmula 5 formaliza esta correspondencia como un argmax sobre el vocabulario, criterio que también determina la etiqueta de salida </latent>.
La legibilidad se evalúa mediante la similitud coseno media entre los vectores latentes y los embeddings de tokens más cercanos; un valor de 1 indica coincidencia exacta con un token del diccionario. El equipo estableció un umbral de ruido mediante 2.000 vectores gaussianos aleatorios y analizó 200 problemas derivados. La especificidad contextual evalúa el solapamiento de palabras entre el pseudotexto y el enunciado original respecto a tareas no relacionadas; si la proporción supera el valor de 1, confirma que el pensamiento latente apunta verdaderamente al problema analizado. Solo aquellos vectores que superan el umbral de ruido y presentan una especificidad superior a 1 constituyen pensamientos latentes aptos para auditoría.
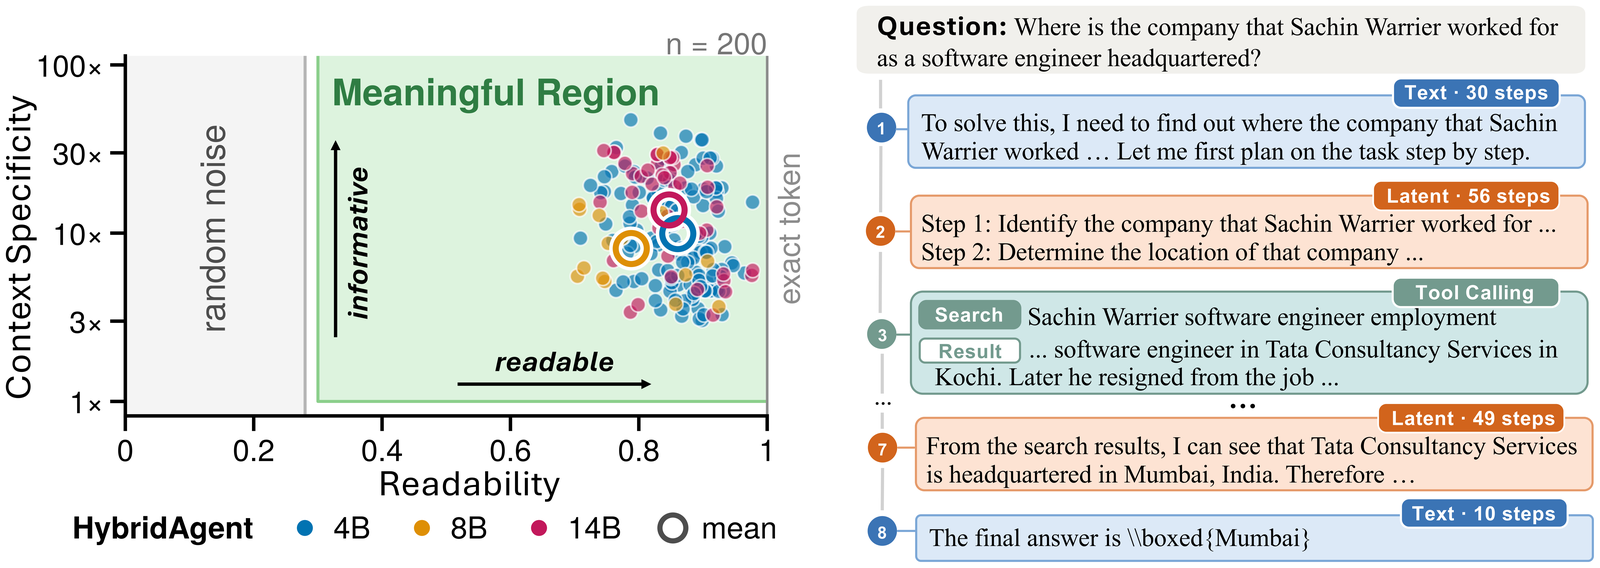 Figura: Distribución de la exploración semántica de vectores latentes y ejemplo de trayectoria con invocación de herramientas en múltiples pasos. Fuente: arXiv 2610.18861
El impacto del entrenamiento autocondicionado resulta especialmente revelador en este aspecto. Empleando la misma base Qwen3-14B-Base, la activación basada únicamente en formato alcanza puntuaciones de 20.6, 19.8 y 62.4 en AIME25, AIME26 y MATH500; al incorporar HybridLink sube a 23.8, 22.5 y 73.8; y con el entrenamiento autocondicionado llega a 32.5, 31.7 y 84.2. La legibilidad de las interpretaciones latentes mejora de manera sincronizada en cada fase de aprendizaje.
El espacio latente preserva vectores con dirección semántica dentro del espacio léxico, no ruido geométrico aleatorio. Los métodos que prescinden del entrenamiento autocondicionado tienden a producir fragmentos ininteligibles. Por tanto, la interpretabilidad de los estados latentes depende del planteamiento del entrenamiento y no constituye una limitación intrínseca de la inferencia latente.
Evaluación en 11 pruebas complejas: costes de interacción reducidos a un tercio
El banco de pruebas reprodujo escenarios de interacción real de alta exigencia, integrando un entorno aislado de ejecución de Python y el motor de búsqueda web Tavily. Cada trayectoria admitió hasta 10 llamadas a herramientas, recuperando los 10 mejores fragmentos web por consulta. GPT-5.6-Luna actuó como evaluador y extractor de resúmenes.
La batería de pruebas comprendió 11 evaluaciones, entre ellas GAIA, WebWalker, HLE, SealQA y competiciones matemáticas de AIME. A lo largo de 5 ejecuciones independientes, la desviación estándar de la precisión fue de ±0,014 y el intervalo de confianza al 95 % de ±0,017 (desglosado en ±0,031 para matemáticas y ±0,018 para recuperación de información). En las escalas de 8B y 14B, la arquitectura superó con holgura a agentes avanzados y marcos dedicados; el modelo de 14B aventajó a la línea base más competitiva en un 17,4 %. Bajo idénticos parámetros y presupuesto de entrenamiento, HybridSFT y HybridRL superaron a las líneas base de texto y espacio latente en un 18,5 % y un 10,4 % respectivamente.
El número de tokens facturables desciende a medida que crece la proporción de razonamiento latente. Dado que los agentes de horizonte largo encadenan decenas de interacciones con herramientas, el ahorro generado en cada paso se acumula a lo largo de la trayectoria, repercutiendo de forma directa en la reducción del coste operativo global.
El razonamiento híbrido redefine la ingeniería: el reto de la adopción práctica
La inferencia en el espacio latente continúa suscitando posturas encontradas. Sus defensores sostienen que los modelos autorregresivos basados exclusivamente en texto están tocando techo a nivel de ingeniería. La coordinación intensiva entre múltiples agentes y la planificación a largo plazo saturan rápidamente las ventanas de contexto en los sistemas tradicionales. Delegar el razonamiento lógico interno en los núcleos Tensor Core para aliviar el consumo de ancho de banda resulta imprescindible para escalar sistemas complejos.
Por su parte, los desarrolladores más cautos advierten del esfuerzo de migración que requiere el ecosistema empresarial. La industria opera actualmente sobre APIs estándar de texto continuo; tanto las herramientas de telemetría y depuración como los cortafuegos de seguridad se fundamentan en el procesamiento de texto. HybridAgent exige un ajuste fino especializado y motores de ejecución propios, por lo que no puede aplicarse de inmediato sobre modelos comerciales propietarios. La inversión asociada a reestructurar la infraestructura base podría mitigar parte de los ahorros conseguidos en el hardware.
Los experimentos sobre escalado de cómputo en inferencia (Test-time compute) aportan nuevos elementos al debate. En una muestra de 100 problemas complejos de matemáticas y ciencias, variando el presupuesto de muestreo k de 4 a 64, la curva pass@k de la arquitectura híbrida mantuvo una trayectoria ascendente continua y aprovechó mejor la potencia de cálculo que los agentes de texto basados únicamente en aprendizaje por refuerzo. Los estados latentes continuos ofrecen suficiente capacidad para exploraciones profundas, ampliando la distancia competitiva a medida que se incrementa el cómputo disponible.
El cuello de botella de los agentes autónomos reside en el soporte utilizado para canalizar sus deducciones. Convertir forzosamente los razonamientos intermedios en caracteres de texto desaprovecha el ancho de banda de memoria. Un espacio latente continuo puede sostener el desarrollo lógico interno conservando a la vez interfaces textuales para actuar con el entorno. Ante tareas prolongadas con restricciones de cómputo, prescindir de los soliloquios superfluos representa la estrategia más directa para disparar el rendimiento global.
Enlaces de referencia:
- Artículo en arXiv: Hybrid Reasoning Agents (2610.18861)
- Proyecto de investigación conjunto de la Universidad de Stanford y Together AI