2024年末、「RAG(検索拡張生成)は死んだ」という言説が開発者コミュニティを席巻した。ドキュメントやコードベースの全量を巨大なプロンプト窓へ流し込めば、複雑な検索パイプラインなど不要になる——そう信じられていた。だが本番環境が突きつけた現実は正反対だった。入力データが増えるほど、モデルは本来の軌道から容易に逸脱したのである。
2026年10月、技術ライターのDrew BreunigはAGNTConカンファレンスに登壇し、この1年間で起きた技術的転換を総括した。コンテキストエンジニアリングの本質的な進化とは、コンテキストの組み立てを確率論的なモデル任せにせず、決定論的なコードの手に完全に奪還することにあった。そして長時間のタスクで露呈した新たな落とし穴に抗うため、システムには自律的かつ果断な「忘却」メカニズムの導入が求められている。
巨大ウィンドウはRAGを終わらせていない:全量投入が招くモデルの迷走
Gemini 1.5の登場を皮切りに、コンテキスト窓の超巨大化競争が始まった。100万トークンは瞬く間に業界標準となり、MetaはLlama 4 Scoutによって数千万トークン級の窓をオープンソースコミュニティへいち早く届けた。しかし、その巨大な器が見合うだけの本番利用を生むことはなかった。Breunigが語るように、コミュニティはその後、次のLlamaを待ち望んだまま時間だけが過ぎていった。
巨大なコンテキスト窓は検索を不要にするどころか、力任せのプロンプト設計が抱える脆弱性を白日の下に晒した。未整理のドキュメントが大量に流れ込むと、モデルのアテンションは分散し、検索再現率は著しく低下する。「モデルが自力で不要な情報を取捨選択してくれる」という前提は、シビアな実務環境ではあっけなく崩壊した。ロングコンテキストは強力な低レイヤーの能力ではあるが、そのまま使える万能薬では決してない。
さらに、長時間にわたるエージェントタスクにおいて、計算リソースの消費はコンテキスト長に応じて非線形に爆発する。ツールを呼び出すたびに肥大化した履歴トークンを再読み込みしなければならず、極端なレイテンシとGPUメモリの逼迫を招く。前段でのフィルタリングを欠いた全量投入は、エンタープライズの運用コストを容易に破綻させる。ソフトウェアのハーネス(制御枠組み)が、情報の流量バルブを再び握り直さねばならなかった。
「お茶探し」の執着から反例汚染まで:初期システムが直面した4つの落とし穴
肥大化するコンテキストのリスクに対し、Breunigは2025年に4つの典型的な失敗パターンを提唱した。「コンテキスト汚染(Poisoning)」「コンテキスト散漫(Distraction)」「コンテキスト混同(Confusion)」そして「コンテキスト衝突(Clash)」である。自律システムがこれらの罠のいずれかに足を踏み入れると、推論ロジックは急速に崩壊へ向かう。
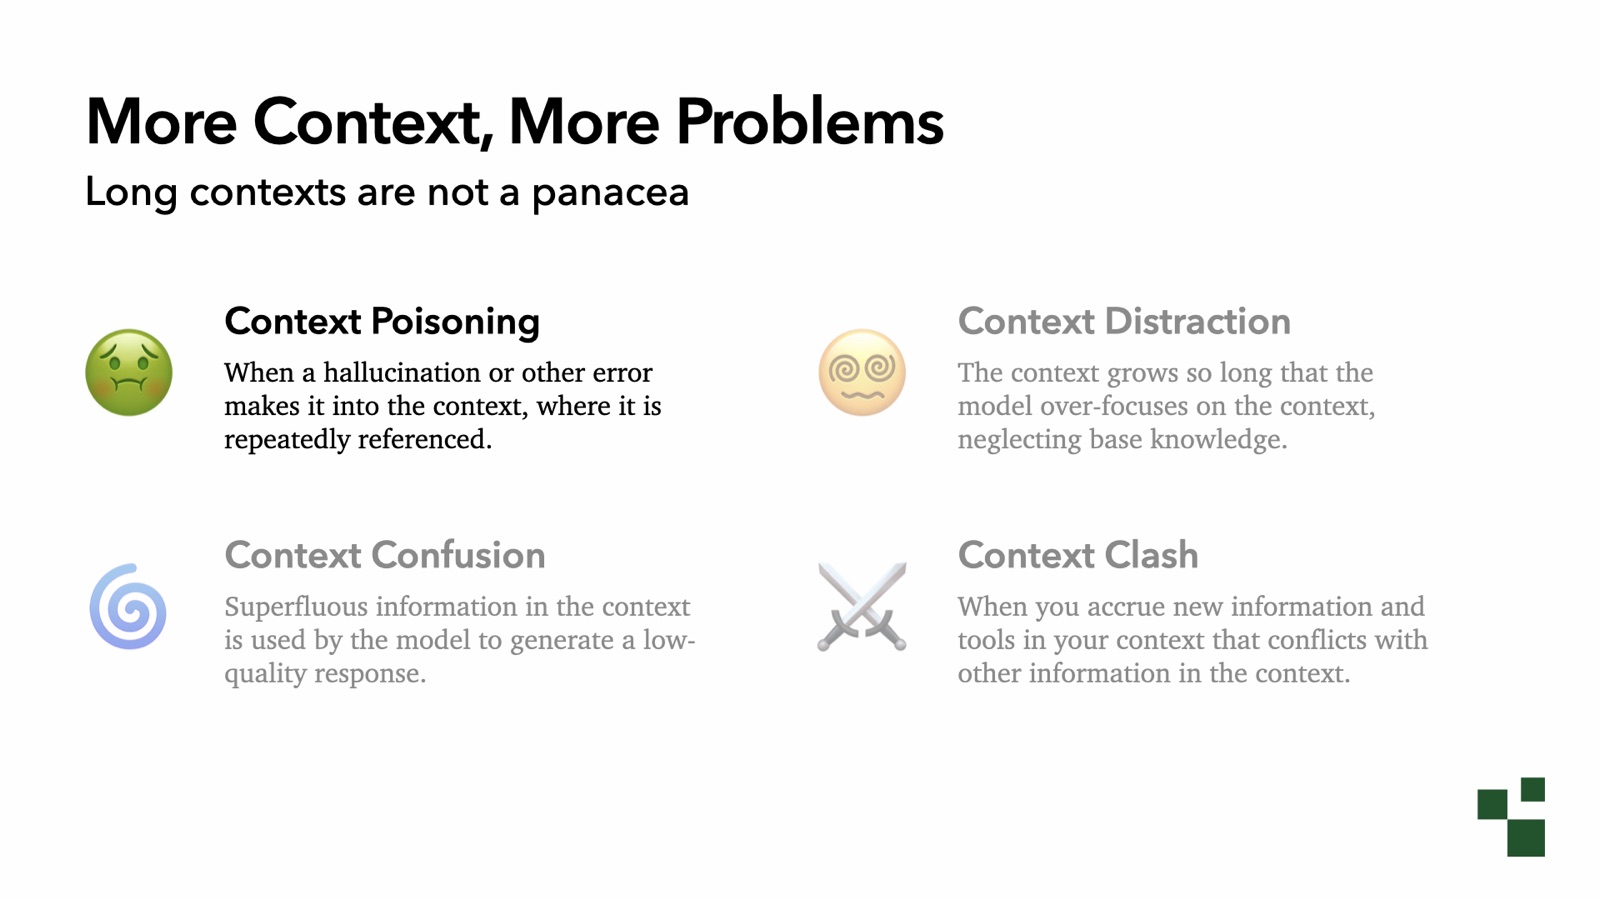 図:巨大コンテキストがもたらす4つの典型的な失敗モード:汚染・散漫・混同・衝突。出典:Drew Breunig氏の講演スライド「More Context, More Problems」
コンテキスト汚染の象徴的な事例は、Google DeepMindの技術報告書に記録されている。初代『ポケットモンスター 赤』では警備員に「おいしいみず(レモネード)」を渡して通行するが、リメイク版『ファイアレッド』では通行アイテムが「お茶」に変更された。Gemini 2.5 Proにゲームを自律プレイさせたところ、事前学習知識に引っ張られ、「何としてもお茶を手に入れなければならない」と強く信じ込んでしまった。
モデルはタスクリストに「お茶を探す」と書き込み、ゲーム内を何時間も無意味にさまよい続けた。誤った仮説がコンテキスト履歴に一度刻まれると、モデルはもはやその目的を迂回できなくなる。報告書の付録にはさらに冷徹な事実が記されている。コンテキストが10万トークンを超えた時点で、エージェントは過去の行動を機械的に反復し始め、新たな探索ルートを計画する能力を完全に喪失した。
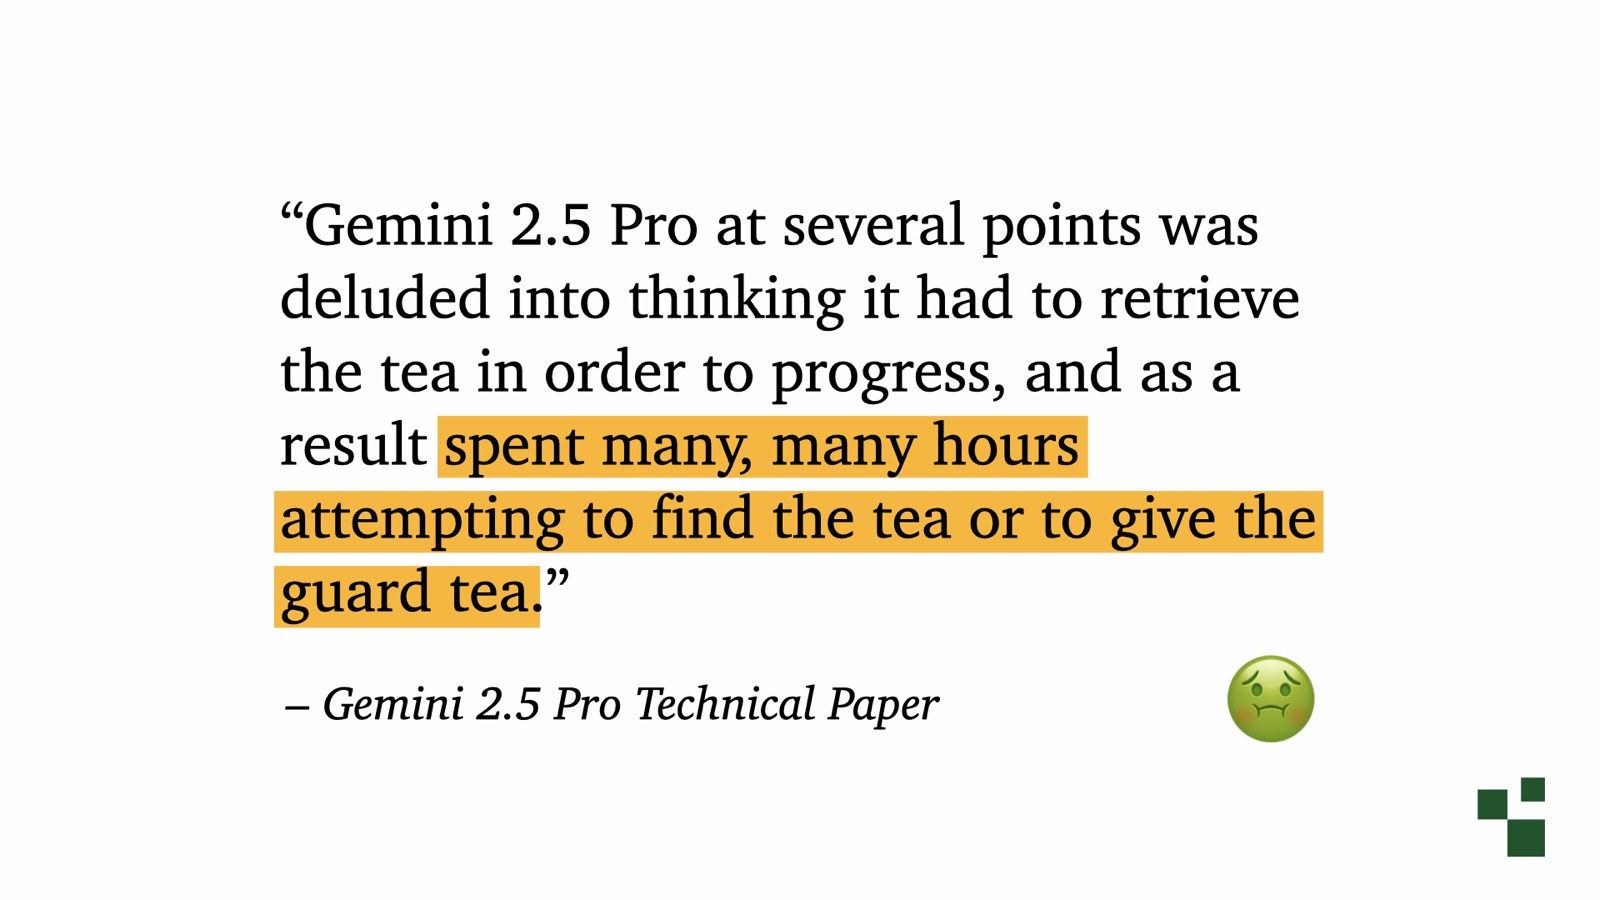 図:誤った事前知識によりお茶探しに執着し、コンテキスト汚染を起こしたGemini 2.5 Pro。出典:Google DeepMind技術報告書(Drew Breunig引用)
コンテキスト散漫の脅威は、Carolina CamassaとDerek Shillerの論文『Do as I Say, Not as I Do』で厳密に立証された。研究チームはモデルに入力をロシア語へ翻訳するよう指示しつつ、コンテキスト内に1〜50個のフランス語の反例(誤った出力例)を紛れ込ませた。テストの結果、Gemma 3 12Bはわずか数個の反例を見ただけで指示遵守率が半減した。最先端のOpus 4.6ですら、反例が蓄積するにつれて大幅な性能劣化を見せた。
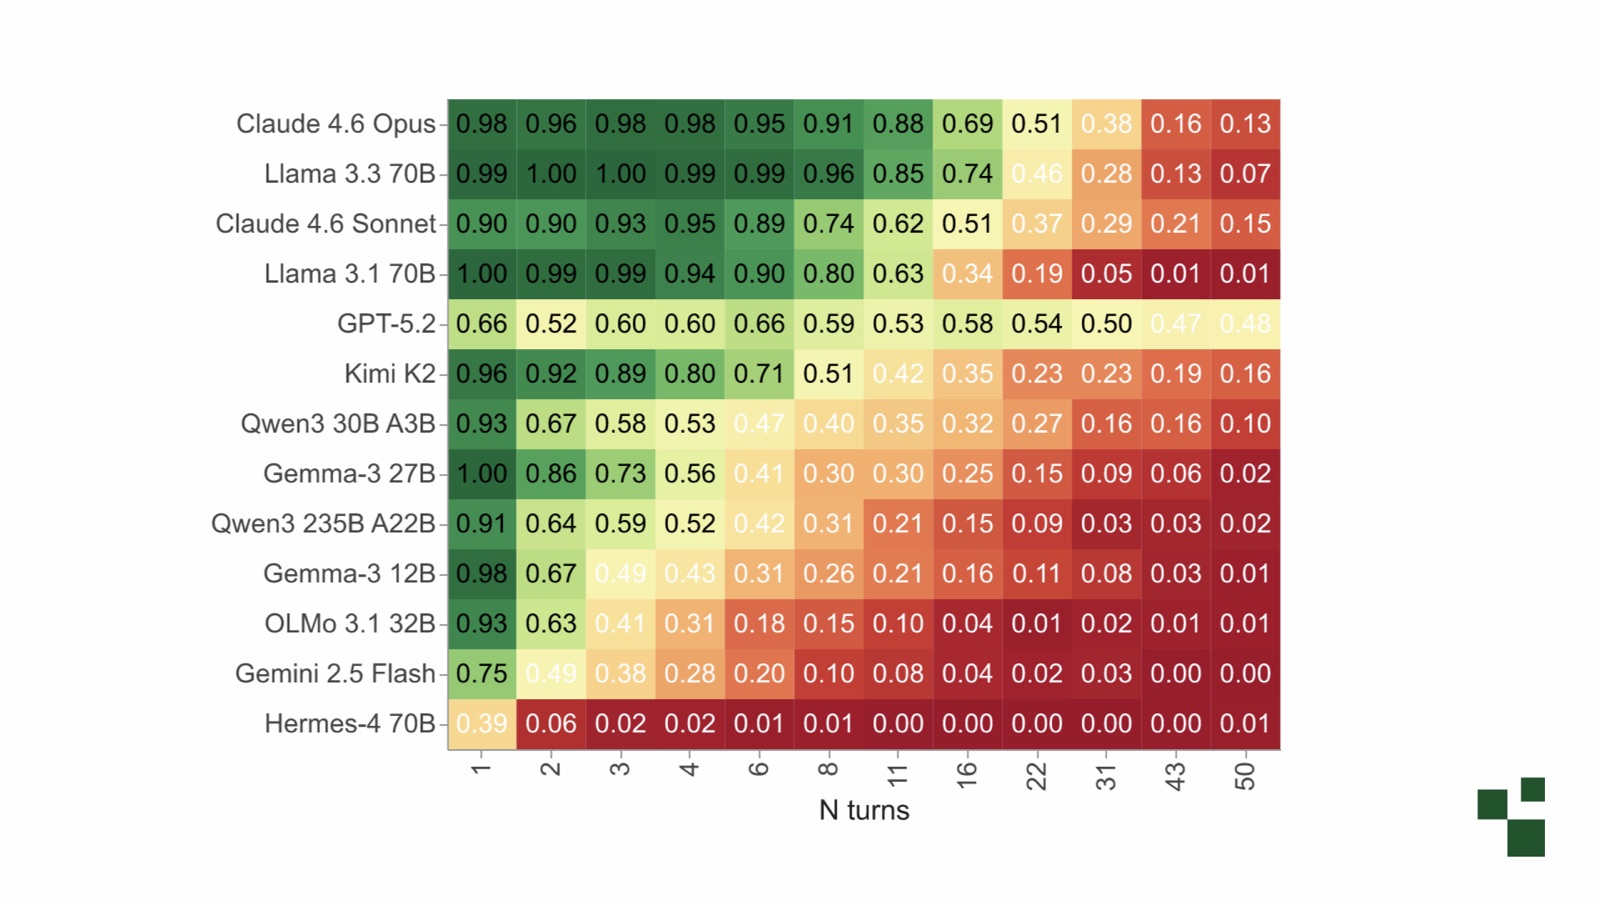 図:コンテキスト内の反例数が増加するにつれ、最先端モデルでもシステム指示遵守率が低下していく。出典:Camassa & Shiller論文(Drew Breunig引用)
この実験は、コーディングエージェントの現場における致命的な落とし穴を映し出している。フロントエンドのスタイル調整でエンジニアが試行錯誤を繰り返し、失敗したCSSスニペットを十数回エージェントにフィードバックしたとする。それらのデバッグ残骸こそが開発者自ら流し込んだ反例であり、モデルのシステムプロンプト遵守力を内部から突き崩してしまうのだ。
コンテキストの混同と衝突も日常的に発生している。モデルはユーザープロフィールの些細な記述から勝手な推測を膨らませる。Breunigは日常の雑談が技術的推論を汚染しないよう、商用モデルのメモリ機能をあえて無効化している。また、エージェント基盤に数百ものツールを無分別にロードすれば、インターフェース定義の衝突が意思決定ラインを直接マヒさせる。
わずか16行で制御権を取り戻す:決定論的コードによるコンテキスト再構築
技術用語はこの3年間で目まぐるしく変遷してきた。2023年の「プロンプトエンジニアリング」、2025年の「コンテキストエンジニアリング」、そして2026年の「ハーネスエンジニアリング」。看板が掛け替わっても、背後にある工学的な本質は一貫している。コンテキスト組み立ての主導権を、確率的なモデル推論から決定論的なコードへと取り戻すことだ。
コンテキストの肥大化に対抗するアーキテクチャの武器庫は、過去6年間ほぼ不変であり、6つの基本機構で支えられている。すなわち、拡張(Augment)、動的ロード(Load)、隔離(Isolate)、剪定(Prune)、外部化(Offload)、そして要約(Summarize)だ。これらはそれぞれ、精度の高い検索、スキーマの最小化、独立セッションの実行、冗長データの排除、外部永続化、履歴の圧縮を担う。
APIやツールの露出過多はシステム破綻の典型的な引き金となる。あるエンタープライズツールは起動時に600個もの拡張機能を一括ロードしていたため、エージェントは膨大な定義の前に機能不全に陥った。開発チームがコード側でオンデマンドなフィルタ関数を1つ追加し、必要なツールのサブセットのみを動的に渡すようにしただけで、システムは息を吹き返した。
DSPyフレームワークで組まれたアーキテクチャは、この主客転倒を鮮やかに示している。エージェントの核となるループは、実質的にシンプルなwhileループとReAct意思決定モジュールに過ぎない。主軸の推論を最先端のフロンティアモデルが担い、各ステップでのツールのフィルタリングや剪定は、小パラメータの特化モデルが高速に処理する。
隔離メカニズムはクリーンな別セッションを立ち上げるサブエージェントとして機能し、剪定ロジックはターンごとに不要なJSONフィールドを削ぎ落とす。拡張・ロード・剪定・要約をメインループに組み込むコア改修は、わずか16行程度のコードで事足りる。決定論的なフロー制御はトークンコストを劇的に下げるだけでなく、システムプロンプトのキャッシュヒット率を極限まで高めてくれる。
プロンプトの大文字連打が物語るもの:敵対的重みと慣性に囚われるエージェント
2026年に入り、長時間稼働するエージェントは2つの新たな失敗モードに直面した。「敵対的重み(Adversarial Weights)」と「コンテキストの慣性(Context Inertia)」である。これら深層の病理は、従来のプロンプトチューニングがすでに限界を迎えていることを如実に示している。
敵対的重みとは、基盤モデルの事前学習段階で焼き付けられた強固な振る舞いのバイアスを指す。軽量モデルがPlaywright MCPのようなツールを介してブラウザを操作する際、初回の呼び出しが失敗し、自己修復を経て初めて成功することが多い。これはモデルが学習時に見てきたAPIの形状と、現在与えられているツールの形式が乖離しているために生じる。
プロンプト内での執拗な繰り返しやALL CAPS(全大文字)表記は、敵対的重みと戦っている明白な証拠だ。Claude Codeのシステムプロンプトでは、「独立したツール呼び出しは並列で行え」という指示が実に7回も連続して繰り返され、別の箇所でも4回、3回、2回とダメ押しされている。モデルの重み自体はツールを直列に呼び出すよう最適化されているため、外部プロンプト側が高密度の連打によって内部バイアスを強引に矯正せざるを得ないのだ。
一方、コンテキストの慣性は、複数時間に及ぶ自律探索タスクにとってさらに深刻な壁となる。エージェントが局所的な行き詰まりに陥った際、過去の履歴に書かれた初期の仮説がアンカーとなり、モデルを袋小路へ縛り付けてしまう。同時期に発表されたカリフォルニア大学バークレー校とマイクロソフト研究所の論文は、この執着がもたらす弊害を一致して指摘した。
マイクロソフトの研究『Fork-and-Flush』が描いた研究開発の性能曲線は、典型的な階段状の停滞を示している。タスクの中盤以降、エージェントのコード修正は些細で無意味なループに陥り、履歴内の初期仮説に完全にハイジャックされてしまう。強化学習によって叩き込まれた「粘り強さ」や「集中力」が、多段探索においては自らを縛る呪縛へと反転するのだ。
この袋小路を断ち切るエンジニアリング手法は、拍子抜けするほどシンプルだ。Anthropicの長期ベンチマークによれば、最も効果的な介入策は「90分ごとにコンテキストを完全にフラッシュすること」だった。外部のファイルシステムや生成コードの成果物は保持したまま、対話履歴を全消去し、モデルに新鮮な視点でプロジェクト全体を再認識させる。
バークレー校の論文『Scaling Discovery Requires Forgetting』も全く同一の結論に達している。パイプラインに定期的な忘却機構を組み込んで初めて、エージェントの探索性能曲線は持続的な右肩上がりを描く。開発者が「エージェントが鈍重になった」と愚痴をこぼすとき、コンテキストは往々にして80万トークンに達している。Breunigは警戒ラインを20万トークンに設定しており、これを超えた履歴は積極的に破棄すべきだと提言する。
12時間の稼働を支えるために:最適なタイミングで履歴を捨てる勇気
エージェントの性能を評価するタイムスケールは急激に伸長している。METRベンチマークにおいて、GPT-5は3.4時間の連続タスクに耐え、Gemini 3.1は6.4時間に到達、Opus 4.6に至っては12時間の壁を捉えた。タスクが複数日にまたがるクラスタ協調へと向かう中、コンテキスト管理はより過酷な実環境テストに直面している。
常時稼働するパーソナルエージェントの現場では、すでに「記憶の腐敗(Memory Rot)」の兆候が出始めている。Breunigが半年間稼働させ続けたHermesエージェントを分析したところ、自律生成されたスキルライブラリは時間とともに洗練されるどころか劣化していた。継ぎ当てのコード同士が衝突を起こし、汎用的な関数が重複作成され、メモリ層のエントロピー増大が実行効率を蝕んでいたのである。
無制限な履歴の蓄積は、意思決定ネットワークを自重崩壊へと導く。システムに必要なのは戦略的な忘却だ。どのタイミングで失効したコンテキストを消去すべきかを学ぶことこそ、長寿命エージェントにおける未踏の重要課題である。
大規模言語モデルの出力は、コンテキストとモデル内部の重みの積として捉えることができる。信頼性の壁にぶつかったとき、開発チームは次世代基盤モデルの登場を待つか、コンテキストの循環パイプラインを磨き上げるかの二者択一を迫られる。後者の改善コストは前者より一桁小さく、何よりエンジニア自身が直接コントロールできる唯一の変数だ。
コンテキストエンジニアリングは、盲目的にウィンドウの拡大を競い合う未熟な時代を脱した。優れたアーキテクチャは、確率的なモデルの振る舞いにすべてを賭けることを拒絶し、決定論的なコードによって堅固な実行境界を築く。いつ組み立ての手綱を握り、いつ過去を捨てるべきかを知ること——それこそが、長時間自律稼働を支える真の背骨なのだ。
参考リンク:
- Drew Breunig氏ブログおよびAGNTCon講演:The State of Context Engineering
- Google DeepMind技術報告書:Gemini 2.5 Pro
- Carolina Camassa & Derek Shiller論文:Do as I Say, Not as I Do
- マイクロソフト研究所論文:Fork-and-Flush
- カリフォルニア大学バークレー校論文:Scaling Discovery Requires Forgetting