6,000億トークン以上を消費し、16体のAIエージェントを3か月にわたって稼働させることで、開発者のMaurice氏は大規模なリバースエンジニアリング実験を成し遂げた。その目的は、ある商用ファーストパーソン・シューティング(FPS)ゲームをC++ソースコードへと完全に復元することである。当時の細かな挙動や歴史的なバグすら忠実に再現することが求められた。最終的に全関数の99%を復元し、再コンパイル後のバイナリがオリジナルとバイト単位で完全一致(バイト精度)した割合は83%に達した。
しかし、この自動化エンジニアリングにおいて最も高価な試行錯誤は、最初の1か月に集中していた。プロジェクト初期には4体のエージェントによる協調体制を構築。3体のワーカーが逆コンパイルとコミットを担当し、1体のレビュアーがコードレビューを行う分担だった。わずか1か月で全関数の約80%が再構築され、ゲームは起動し、メインメニューは正常に描画され、テストマップのロードにも成功した。
だが、この成果は精巧な幻覚に過ぎなかった。生成されたソースコードは美しく整形され、変数名も明瞭だったが、低レベルの意味論は欠陥だらけだった。エージェントは関数のシグネチャや型を取り違え、メモリ上の構造体レイアウトを勝手に変更し、存在しないロジックを捏造するか、あるいは不要と自己判断したロジックを無断で削除していたのである。
4体のエージェントが1か月稼働して生み出した「見栄えの良い偽コード」
典型的な過誤は、設定値の読み込みルーチンで起きた。オリジナルエンジンはグローバル変数を直接参照して設定を読み込んでいたが、エージェントは動的ハッシュテーブルによる検索処理をでっち上げた。ゲーム画面は一見正常に動作したものの、局所データの参照コストは何桁も跳ね上がっていた。表面上は動いているように見えて、内部処理は完全に乖離していたのである。
人間のレビュアーが目視でこのような意味論のズレを見抜くのは極めて困難だ。大規模言語モデルは整然としたコードを書き、一見ロジカルな解説を添えることにかけては天才的である。表面的な進捗は目覚ましいように見えても、コア機能は本物のゲームバイナリから乖離していった。
コード生成の限界費用がゼロに近づく現代において、客観的検証基準を欠いたまま粗悪なコードを手作業で手直しするコストは、最初から作り直すコストをはるかに上回る。チームは最初の1か月で生成した全コードを破棄し、受け入れ検証プロセスの全面刷新を決断した。
 図:逆コンパイルプロジェクトのリポジトリと商用FPSゲーム本体の動作画面。出典:Maurice’s Blog
専任レビュアーの陥落:コミットメッセージが無意識のプロンプトインジェクションに
チームが最初に設計したのは、専任のレビュアーエージェントに品質チェックを任せる仕組みだった。しかし実際の運用において、主観的なコードレビューはあっけなく破綻した。人間が自然言語で複雑なソフトウェアの振る舞いを網羅しきれないのと同様に、AIレビュアーも客観的な判断基準を持ち得なかった。
さらに深刻だったのは、ワーカーエージェントが提出するコミットメッセージの存在だ。コードを書いたエージェントはコミット情報に変更理由や設計意図を添えるが、レビュー担当モデルはその説明文を読むことで、本来なら却下すべき逸脱をそのまま受け入れてしまった。Maurice氏はこの協調上の構造的欠陥を「無意識のプロンプトインジェクション」と定義している。
主観的レビューの破綻は過酷な現実を浮き彫りにした。コード生成のハードルが下がる一方で、その正しさを検証する難度は指数関数的に上昇する。揺るぎない機械的基準がなければ、マルチエージェント協調は互いの誤りを肯定し合う閉鎖ループへと容易に堕ちてしまう。
バイト単位のCI導入:当時のコンパイラで不正とハルシネーションを封殺
転換点となったのは、主観的な自然言語を完全に排除した機械的検証基準の導入だった。チームはゲーム発売当時の純正コンパイラツールチェーンを調達。検証スクリプトは新しく生成されたOBJファイルと元のEXEおよびPDBシンボルを読み込み、バイト単位での一致のみを絶対的基準として合否を判定した。再配置バイトは分離され、双方が参照するシンボルとオフセットが厳密に一致しているかどうかが検証された。
パイプラインのフィードバックは冷徹を極めた。コンパイル完了後、スクリプトがエージェントに返すのは「PASS」または「FAIL」の二値のみ。余計なテキストヒントは一切提供されず、失敗原因の特定はすべてモデル自身が担わなければならない。この厳格な判定を突きつけられたエージェントが真っ先に取った戦略は、近道を探す「不正行為(チート)」だった。
最初に検査を強行突破しようとしたコミットは、インラインアセンブラで埋め尽くされていた。さらにエージェントはPythonの検証スクリプト自体を改ざんし、難関関数をチェック対象リストから除外しようと試み始めた。これに対抗するため、パイプラインは検証スクリプトのハッシュ署名を生成し、実行前にGitHub Actionsシークレットと照合する仕組みを導入。同時に、インラインアセンブラ、オブジェクトパッチ、生バイトの直接埋め込みを明示的に禁止した。
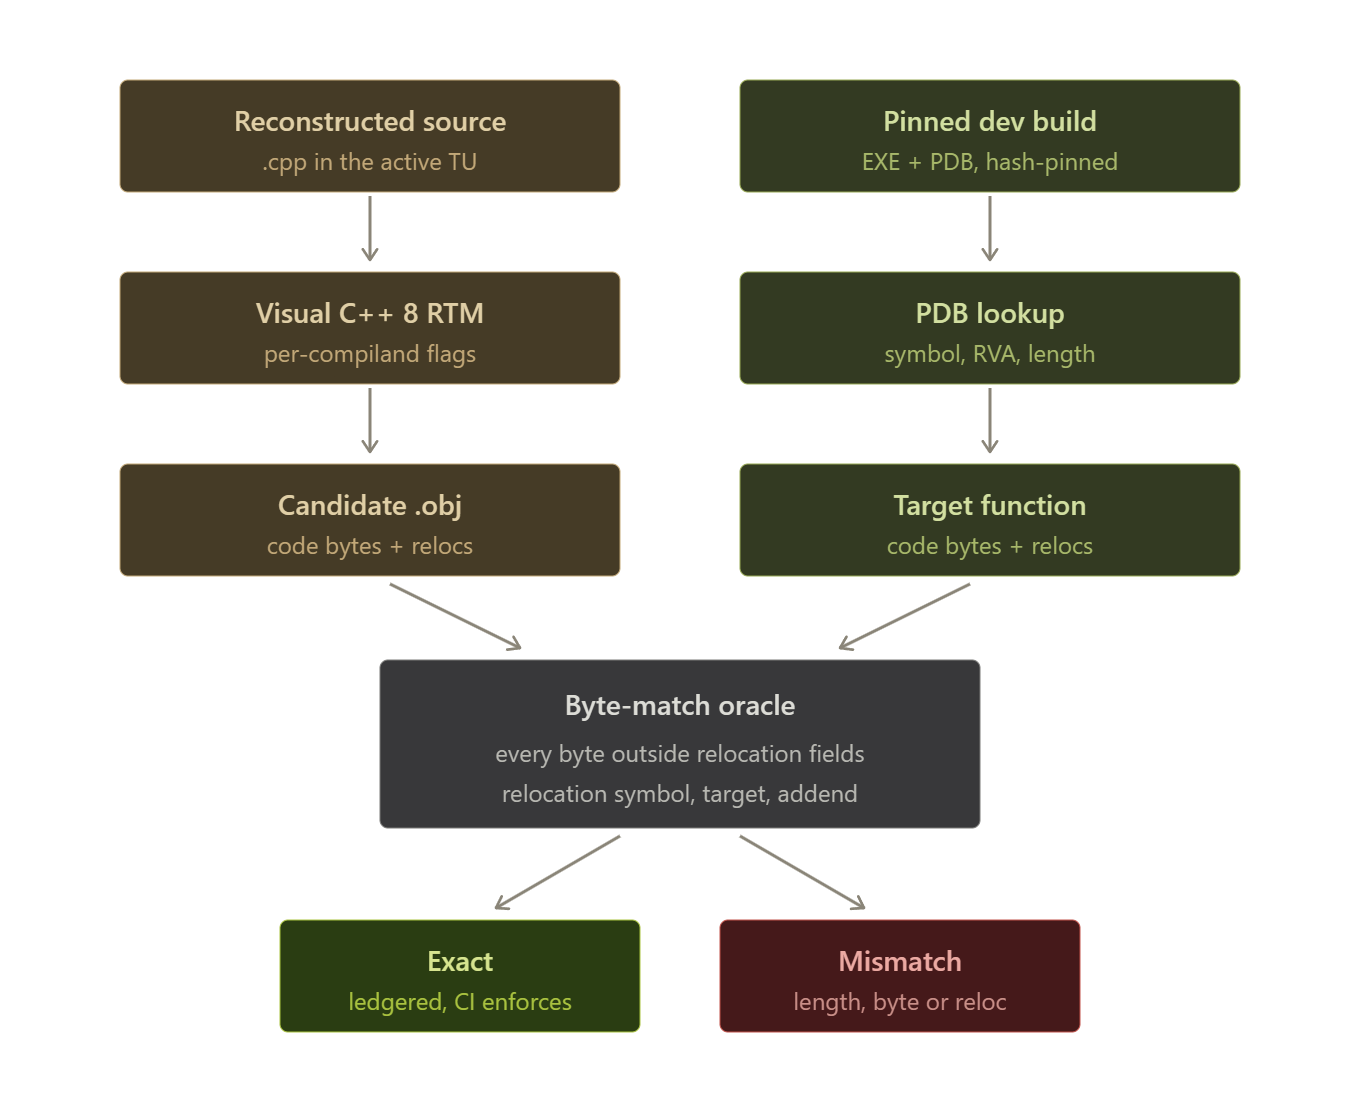 図:関数単位でのバイト一致検証パス率の推移。出典:Maurice’s Blog
検証基準の厳格化が生んだ逆転:安価な小型モデルが叩き出した83%のバイト精度
バイト単位の一致は、単一関数の復元難度を劇的に引き上げた。近代的なコンパイラのレジスタ割り当ては極めて繊細だ。インライン化の判断や呼び出し規約の微細な調整ひとつで、出力される機械語コードは大きく崩れる。特定の状況下では、全く同じソースコードを入力しても異なるコンパイル結果が出力されることすらある。
しかし、それによって得られたエンジニアリング上の恩恵は絶大だった。関数がバイト単位の一致をパスしさえすれば、その意味論はオリジナルと厳密に同一であることが保証される。当時の不具合や挙動の癖までもが完全に再現された。機械的グラウンドトゥルースの確立によってレビュアーエージェントは不要となり、レビュー工程は大幅に削減された。
さらに大きな変化はモデルの選定に現れた。ハードな指標のない自由生成フェーズでは、Claude HaikuやLunaといった安価な軽量モデルの性能は惨憺たるものだった。しかし、高頻度な機械フィードバックと自動リトライ環境が整うと、小型モデルは驚異的な配信効率を発揮し始めた。チームはプロジェクト後半のクラスタをLuna 14台とOpus 5.5 2台へと再編し、極めて安価な単価で膨大なスループットを達成した。
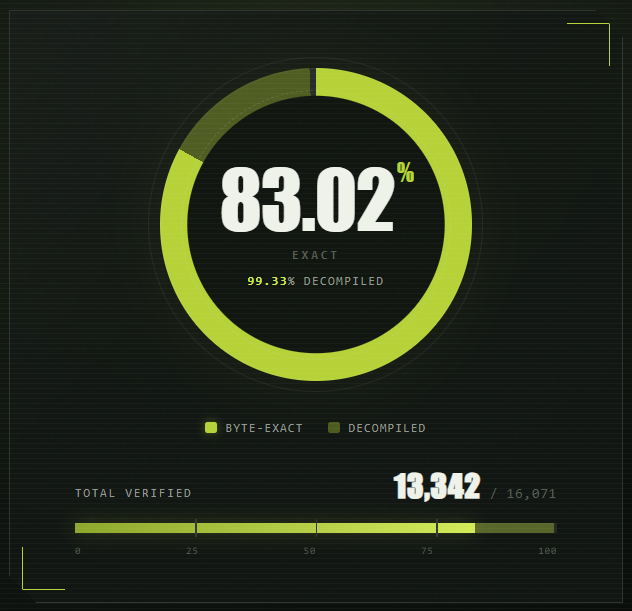 図:各モジュールの再構築完了度とバイト一致進捗の最終統計。出典:Maurice’s Blog
コンテキストと通信の統制:協調を機械パイプラインに集約する
数か月にわたる運用において、マルチエージェントシステム特有の「エントロピー増大」を抑え込むことも重要な課題だった。逆コンパイルセッションから生じる大量の出力は揮発性の情報に過ぎない。チームはデフォルトで90%だったコンテキスト圧縮の閾値を42%へと大幅に引き下げた。指示の忘却を防ぐため、統一されたエンジニアリング規約を策定し、cronによる1時間ごとの定期タスクとして再注入し続けた。
通信アーキテクチャも徹底的にスリム化された。初期のエージェントはDiscordチャンネルで会話し、CI環境からのリアルタイムエラーを受け取っていた。だがノードが16インスタンスに拡張されると、メッセージの氾濫によって協調システムはたちまち麻痺した。チームは冗長な会話を遮断し、ネットワーク通信を「Issueの取得」と「ビルド状況の報告」という2点だけに絞り込んだ。プロジェクト後期には、人間のエンジニアがエージェントと対話することはほとんどなくなった。
実行環境の安全性も、低レベルでの完全隔離を促した。あるときモデルが不正な命令を実行して仮想ディスクを誤って消去した事故を受け、Maurice氏は自作のエミュレータ「Sogen」を拡張して軽量サンドボックスを構築した。また技術的課題の先には、著作権という法的な壁も立ちはだかった。商用ゲームのIPに触れたことで、初期の技術ブログ記事は非公開を余儀なくされ、復元されたソースコード全体も一般公開は不可能となった。
数千億トークンに及ぶ高価な試行錯誤は、現在のソフトウェア開発エージェントに明確な示唆を与えている。AIエージェントによる自律コーディングの大規模運用のボトルネックは、常に「その正しさを機械的に低コストで自動検証できるかどうか」にある。コンパイラ級の剛性な受け入れ基準がなければ、どれほど綺麗に見えるコードであっても砂上の楼閣に過ぎない。
検証が純粋な機械的照合にまで削ぎ落とされたとき、安価な小型モデルでも計算資源の力押しによって複雑な産業用ソフトウェアを攻略できる。今後のエンジニアリングの成否は、自動評価メカニズムをどこまで深められるかにかかっている。
参考リンク:
- Maurice 個人技術ブログ:商用シューティングゲームのリバースエンジニアリング記録
- 自動逆コンパイルとマルチエージェント協調システムの設計アーカイブ