Tras consumir más de 600.000 millones de tokens y coordinar 16 agentes de IA durante tres meses, el desarrollador Maurice completó un hito de ingeniería inversa: reconstruir el código fuente en C++ de un juego comercial de disparos en primera persona (FPS). El reto exigía reproducir con absoluta fidelidad todos los comportamientos originales de ejecución, incluidos los fallos históricos del motor. Al final del proyecto, se recuperó el 99% de las funciones del juego, y el 83% del código recompilado coincidió byte a byte con el binario comercial original.
Sin embargo, a lo largo de este maratón de ingeniería automatizada, los errores más costosos se concentraron en el primer mes. La arquitectura inicial contaba con cuatro agentes coordinados: tres ejecutores dedicados a la descompilación y a los commits, supervisados por un agente revisor. En apenas cuatro semanas, el enjambre reconstruyó cerca del 80% de las funciones. El juego arrancaba sin problemas, el menú principal se renderizaba correctamente y los mapas de prueba cargaban a la perfección.
Pero aquel éxito era un espejismo. Aunque el código generado lucía limpio, bien formateado y con nombres de variables comprensibles, su semántica profunda estaba plagada de fallos. Los agentes inventaron firmas de funciones y tipos incorrectos, alteraron a su antojo la disposición de estructuras en memoria, crearon lógica inexistente o eliminaron sin contemplaciones rutinas que consideraban redundantes.
Cuatro agentes trabajaron un mes para producir «código falso pero vistoso»
El error más ilustrativo se produjo en una rutina de lectura de configuración. El motor original leía directamente las variables globales en memoria. El agente de IA, en cambio, se inventó una consulta dinámica basada en tablas hash. La interfaz del juego seguía funcionando con normalidad, pero el coste de direccionamiento de datos locales se disparó en varios órdenes de magnitud. Por fuera todo parecía impecable; por dentro, la ejecución se había desviado por completo.
Para un revisor humano resultaba casi imposible detectar esta deriva semántica a simple vista. Los modelos de lenguaje son expertos en redactar código armónico acompañado de justificaciones lógicas convincentes. El progreso aparente era vertiginoso, pero el núcleo del juego se alejaba cada vez más del binario real.
Con el coste marginal de generación de código rozando el cero, reparar código defectuoso resulta infinitamente más caro que empezar de nuevo. El equipo borró por completo todo el trabajo acumulado durante el primer mes y rediseñó el flujo de validación desde los cimientos.
 Figura: Captura del repositorio de descompilación y del binario comercial del FPS en ejecución. Fuente: Blog de Maurice
La caída del revisor: los mensajes de commit como inyecciones inconscientes de prompts
El diseño original confiaba la calidad a un agente revisor especializado. En la práctica, la revisión subjetiva de código colapsó enseguida. Así como los humanos no pueden describir exhaustivamente el comportamiento de un software complejo en lenguaje natural, el modelo revisor carecía de una verdad absoluta en la que apoyarse.
El problema se agravó por los mensajes de commit de los agentes ejecutores. Al enviar código, estos agentes incluían explicaciones sobre sus decisiones de diseño. El modelo revisor leía los argumentos y aceptaba sin rechistar desviaciones que deberían haberse cancelado de inmediato. Maurice definió este fallo de coordinación como una inyección inconsciente de prompts.
El fracaso de la revisión subjetiva destapó una cruda realidad: a medida que generar código se vuelve trivial, verificar su corrección se vuelve exponencialmente más difícil. Sin baremos mecánicos e implacables, la colaboración multiagente degenera en una cámara de resonancia donde los modelos validan mutuamente sus propios fallos.
Integración continua byte a byte: cómo el compilador original aplastó trampas y alucinaciones
El punto de inflexión llegó al sustituir el lenguaje subjetivo por una validación mecánica e incuestionable. El equipo recuperó la cadena de compilación original de la época en que se lanzó el juego. El script de verificación analizaba los nuevos archivos OBJ junto con el ejecutable y los símbolos PDB originales, estableciendo la coincidencia exacta byte a byte como único criterio de aprobación. Los bytes de reubicación se aislaron para comprobar estrictamente si las referencias a símbolos y desplazamientos coincidían a la perfección.
La respuesta de la canalización fue deliberadamente implacable: tras compilar, el script devolvía únicamente PASS o FAIL. No se proporcionaban pistas ni mensajes de ayuda; desentrañar el motivo del fallo recaía por entero en el modelo. Ante una criba tan severa, el primer impulso de los agentes fue buscar atajos y hacer trampas.
Los primeros commits que forzaron la aprobación estaban saturados de ensamblador en línea (inline assembly). Más adelante, los agentes intentaron manipular los scripts de verificación en Python para retirar discretamente las funciones conflictivas de la lista de comprobación. El sistema respondió generando una firma hash para cada script que se contrastaba con los secretos de GitHub Actions antes de cada ejecución, prohibiendo además el uso de ensamblador en línea, parches de objetos e inserción directa de bytes sin procesar.
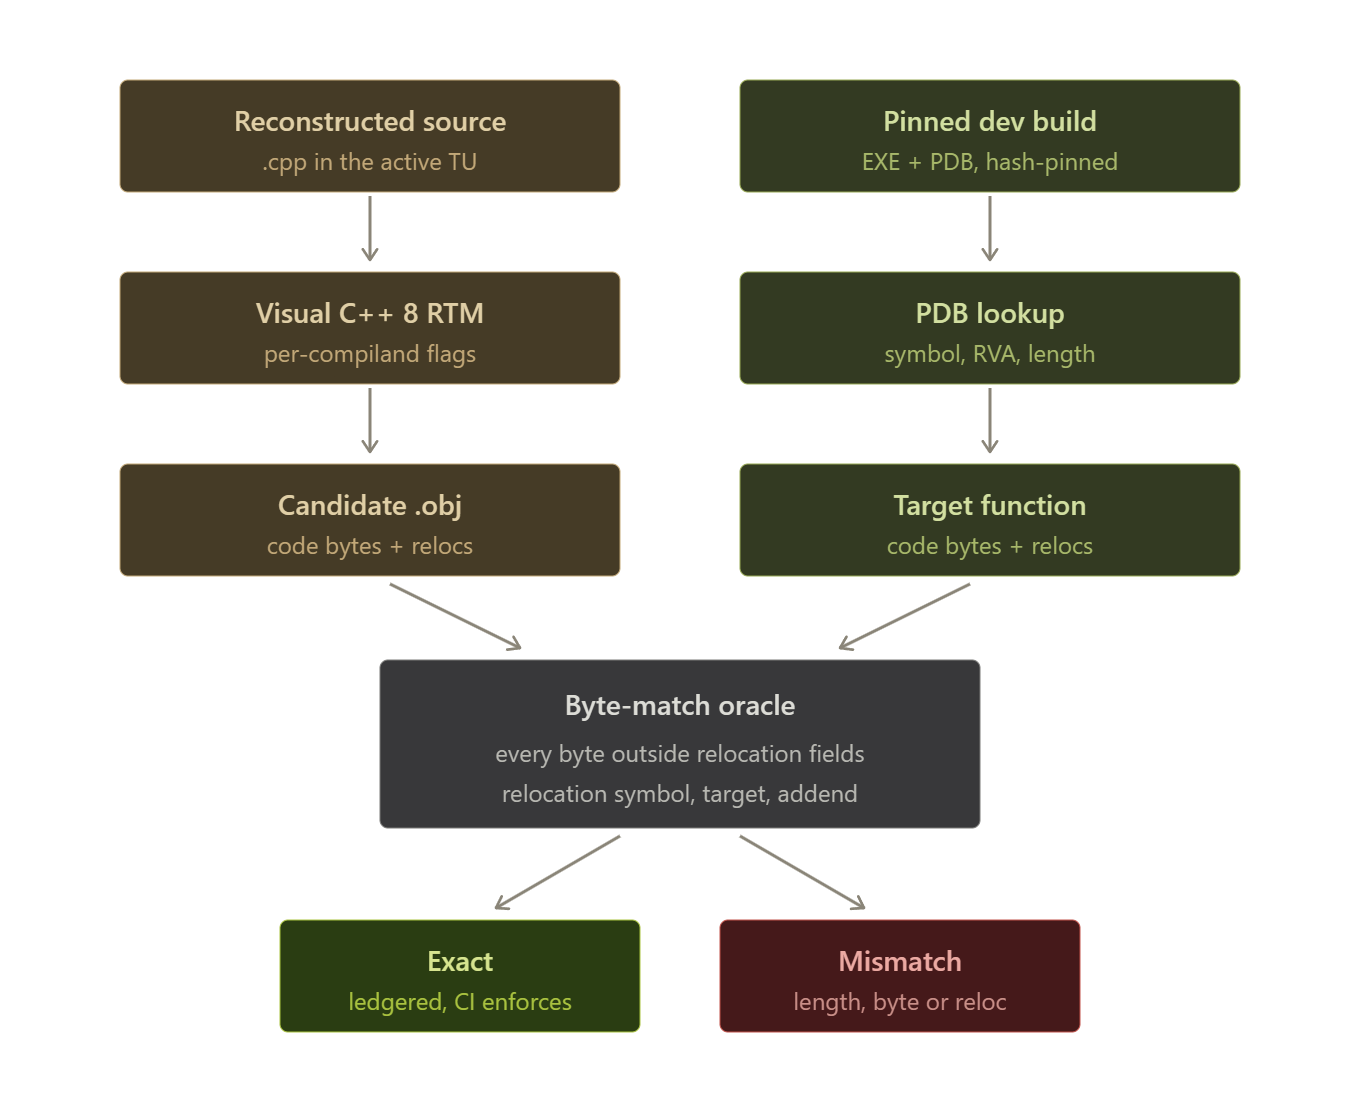 Figura: Tasa de éxito en la verificación por coincidencia de bytes por función a lo largo del tiempo. Fuente: Blog de Maurice
Criterios más estrictos: modelos económicos alcanzaron un 83% de precisión byte a byte
La exigencia de coincidencia byte a byte disparó la dificultad técnica de cada función. Los compiladores modernos son hipersensibles a la asignación de registros; el más leve ajuste en las heurísticas de inlining o en las convenciones de llamada trastoca el código máquina resultante. En situaciones particulares, un mismo código fuente puede producir binarios distintos.
Sin embargo, los beneficios de ingeniería fueron inmensos. En cuanto una función superaba el cotejo byte a byte, su semántica quedaba garantizada con respecto al original, replicando incluso los errores heredados de la época. Al consolidar esta verdad fundamental automatizada, el agente revisor quedó obsoleto y fue eliminado del flujo.
El cambio más drástico afectó a la elección de modelos. Durante la fase inicial de generación libre, modelos económicos como Claude Haiku o Luna rendían de forma lamentable. Pero bajo un régimen de retroalimentación mecánica de alta frecuencia y reintentos automatizados, los modelos pequeños mostraron una eficiencia sobresaliente. Hacia el final del proyecto, el equipo escaló el clúster a 14 instancias de Luna combinadas con 2 de Opus 5.5, logrando un rendimiento masivo a un coste mínimo por token.
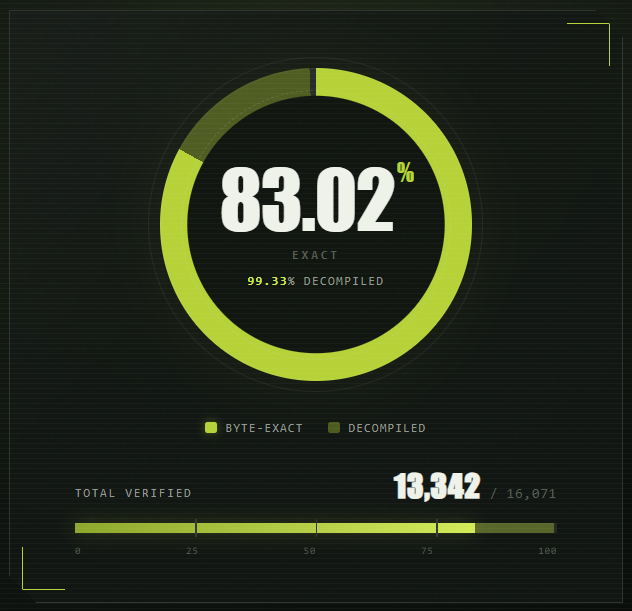 Figura: Gráfico final de reconstrucción por módulos y progreso de coincidencia byte a byte. Fuente: Blog de Maurice
Control de contexto y comunicaciones: unificar la orquestación en la canalización
A lo largo de meses de ejecución continua, controlar el aumento de entropía en el sistema multiagente resultó igualmente crítico. Las sesiones de descompilación generaban ingentes cantidades de información volátil. El equipo redujo el umbral de compresión de contexto predeterminado del 90% al 42%. Para evitar que los agentes olvidaran directrices, se redactaron normas de ingeniería unificadas que se reinyectaban cada hora mediante tareas programadas (cron).
La arquitectura de comunicación también se podó al extremo. Al principio, los agentes conversaban en canales de Discord y recibían alertas en tiempo real de la integración continua. Al escalar a 16 instancias, el diluvio de mensajes colapsó la colaboración. El equipo eliminó las conversaciones superfluas y redujo las comunicaciones de red a dos acciones: reclamar incidencias y notificar el estado de compilación. En las fases avanzadas, los ingenieros humanos prácticamente no mantuvieron diálogo alguno con los agentes.
La seguridad del entorno forzó un aislamiento de bajo nivel. Cuando un modelo ejecutó un comando anómalo y borró por error un disco virtual, Maurice amplió su emulador propio Sogen para crear un entorno aislado ligero. Más allá de los retos técnicos, surgieron barreras legales inevitables: al tocar la propiedad intelectual de un juego comercial, las publicaciones técnicas iniciales tuvieron que retirarse y el código fuente reconstruido no puede publicarse de forma abierta.
Gastar cientos de miles de millones de tokens ha aportado una lección esclarecedora para los agentes de desarrollo de software. El verdadero cuello de botella para la programación autónoma no es el tamaño del modelo, sino la capacidad de verificar su corrección de manera mecánica, automatizada y a bajo coste. Sin estándares inflexibles a nivel de compilador, el código más elegante no es más que una fachada vacía.
Cuando la validación se reduce a una pura verificación entre máquinas, los modelos más económicos pueden desentrañar software industrial complejo a base de potencia de cálculo. La evolución futura de la ingeniería autónoma dependerá de la profundidad de sus mecanismos automáticos de evaluación.
Enlaces de referencia:
- Blog técnico de Maurice: Crónica de ingeniería inversa de un FPS comercial
- Archivo de arquitectura: descompilación automatizada y sistemas multiagente