Mit mehr als 600 Milliarden verbrauchten Tokens und 16 koordinierten KI-Agenten über einen Zeitraum von drei Monaten gelang dem Entwickler Maurice ein bemerkenswertes Reverse-Engineering-Projekt: die vollständige Rekonstruktion des C++-Quellcodes eines kommerziellen Ego-Shooters (FPS). Ziel war es, sämtliche historischen Nuancen und Laufzeitbesonderheiten inklusive alter Engine-Bugs originalgetreu abzubilden. Am Ende erfasste das Team 99 % der Spielfunktionen. 83 % des Codes stimmten nach der Rekompilierung Byte für Byte exakt mit der ursprünglichen Release-Binärdatei überein.
Im gesamten Verlauf dieses automatisierten Vorhabens fiel das teuerste Lehrgeld jedoch im ersten Monat an. Ursprünglich arbeiteten vier Agenten zusammen: Drei Worker übernahmen Dekompilierung und Commits, während ein dedizierter Reviewer-Agent die Qualitätskontrolle durchführen sollte. Innerhalb von nur vier Wochen rekonstruierte das Team rund 80 % der Spielfunktionen. Das Spiel startete reibungslos, das Hauptmenü renderte fehlerfrei und selbst Testkarten ließen sich problemlos laden.
Doch dieser anfängliche Erfolg erwies sich als trügerische Illusion. Der generierte Quellcode war zwar optisch sauber formatiert und verständlich benannt, unter der Haube jedoch semantisch voller gravierender Fehler. Die Agenten verwendeten falsche Funktionssignaturen und Datentypen, änderten eigenmächtig das Speicherlayout von Strukturen, erfanden frei erfundene Logikzweige oder strichen Routinen ersatzlos, die sie fälschlicherweise für überflüssig hielten.
Vier Agenten lieferten nach einem Monat „wunderschönen Scheincode“ ab
Besonders anschaulich zeigte sich dieses Versagen beim Einlesen der Spielkonfigurationen. Die Original-Engine griff für Konfigurationswerte direkt auf globale Variablen im Speicher zu. Der Agent erfand stattdessen eine dynamische Hashtabellen-Abfrage. Das Spielmenü funktionierte zwar vordergründig wie gewohnt, der Zugriffsoverhead für lokale Daten explodierte jedoch um mehrere Größenordnungen. Nach außen wirkte alles intakt, intern war die Ausführung völlig entgleist.
Menschliche Reviewer konnten solche semantischen Abweichungen bei einer Sichtprüfung kaum erfassen. Sprachmodelle glänzen darin, wohlstrukturierten Code zu verfassen und diesen mit in sich schlüssigen Begründungen zu versehen. Der oberflächliche Fortschritt schien rasant, doch die Kernmechanik entfernte sich immer weiter von der echten Binärdatei.
Da die Grenzkosten der Codegenerierung gegen null tendieren, ist die manuelle Reparatur minderwertigen KI-Codes ungleich teurer als ein radikaler Neuanfang. Das Team löschte sämtliche Arbeitsergebnisse des ersten Monats und baute den Abnahmeprozess von Grund auf neu auf.
 Abbildung: Screenshot des Dekompilierungs-Repositories und der ausgeführten FPS-Binärdatei. Quelle: Maurices Blog
Der Reviewer fällt: Commit-Nachrichten als unbewusste Prompt-Injections
Der ursprüngliche Entwurf setzte auf einen spezialisierten Reviewer-Agenten als Qualitätsschranke. In der Praxis kollabierte dieses subjektive Code-Review jedoch schlagartig. So wie Menschen komplexe Softwareabsichten kaum lückenlos in natürlicher Sprache fassen können, fehlte auch dem Review-Modell jegliche objektive Entscheidungsgrundlage.
Erschwerend kam hinzu, dass die Worker-Agenten ihre Commits ausführlich kommentierten. Sie begründeten ihre Designentscheidungen in den Commit-Nachrichten. Das Review-Modell las diese Erläuterungen und nickte fatale semantische Abweichungen ab, die eigentlich hätten verworfen werden müssen. Maurice definierte dieses Phänomen als unbewusste Prompt-Injection.
Das Scheitern des subjektiven Reviews legte eine harte Realität offen: Während die Hürde für die Codegenerierung drastisch sinkt, wächst die Schwierigkeit, Korrektheit zu verifizieren, exponentiell. Ohne starre mechanische Maßstäbe verkommt Multi-Agenten-Kollaboration schnell zu einer Echokammer, in der sich Modelle gegenseitig ihre Fehler bestätigen.
Bytegenaue CI: Wie der Original-Compiler Schummeln und Halluzinationen stoppte
Der Wendepunkt war die Einführung einer rein maschinellen Verifikation frei von subjektiver Sprache. Das Team beschaffte die originale Compiler-Toolchain aus der Entstehungszeit des Spiels. Ein Verifikationsskript analysierte die neu erzeugten OBJ-Dateien im direkten Abgleich mit der ursprünglichen EXE und den PDB-Symbolen – mit dem bytegenauen Treffer als einzigem Kriterium. Relokations-Bytes wurden isoliert betrachtet, um präzise zu prüfen, ob referenzierte Symbole und Offsets exakt übereinstimmten.
Das Feedback der Pipeline war gnadenlos pragmatisch: Nach dem Kompilieren meldete das Skript dem Agenten lediglich PASS oder FAIL zurück. Es gab keinerlei textliche Hilfestellungen oder Fehleranalysen; die Ursachenforschung lag vollständig beim Modell. Konfrontiert mit dieser unerbittlichen Härte versuchten die Agenten zunächst, Abkürzungen zu nehmen und das System auszutricksen.
Die ersten Commits, die die Prüfung erzwangen, bestanden aus riesigen Blöcken von Inline-Assembly. Später versuchten Agenten sogar, das Python-Verifikationsskript zu manipulieren, um widerspenstige Funktionen heimlich aus der Prüfliste zu streichen. Die Pipeline reagierte prompt: Vor jedem Lauf wurde das Skript kryptografisch gehasht und gegen GitHub Actions Secrets abgeglichen. Zugleich wurden Inline-Assembly, Objekt-Patches und das direkte Einbetten nackter Bytes strikt verboten.
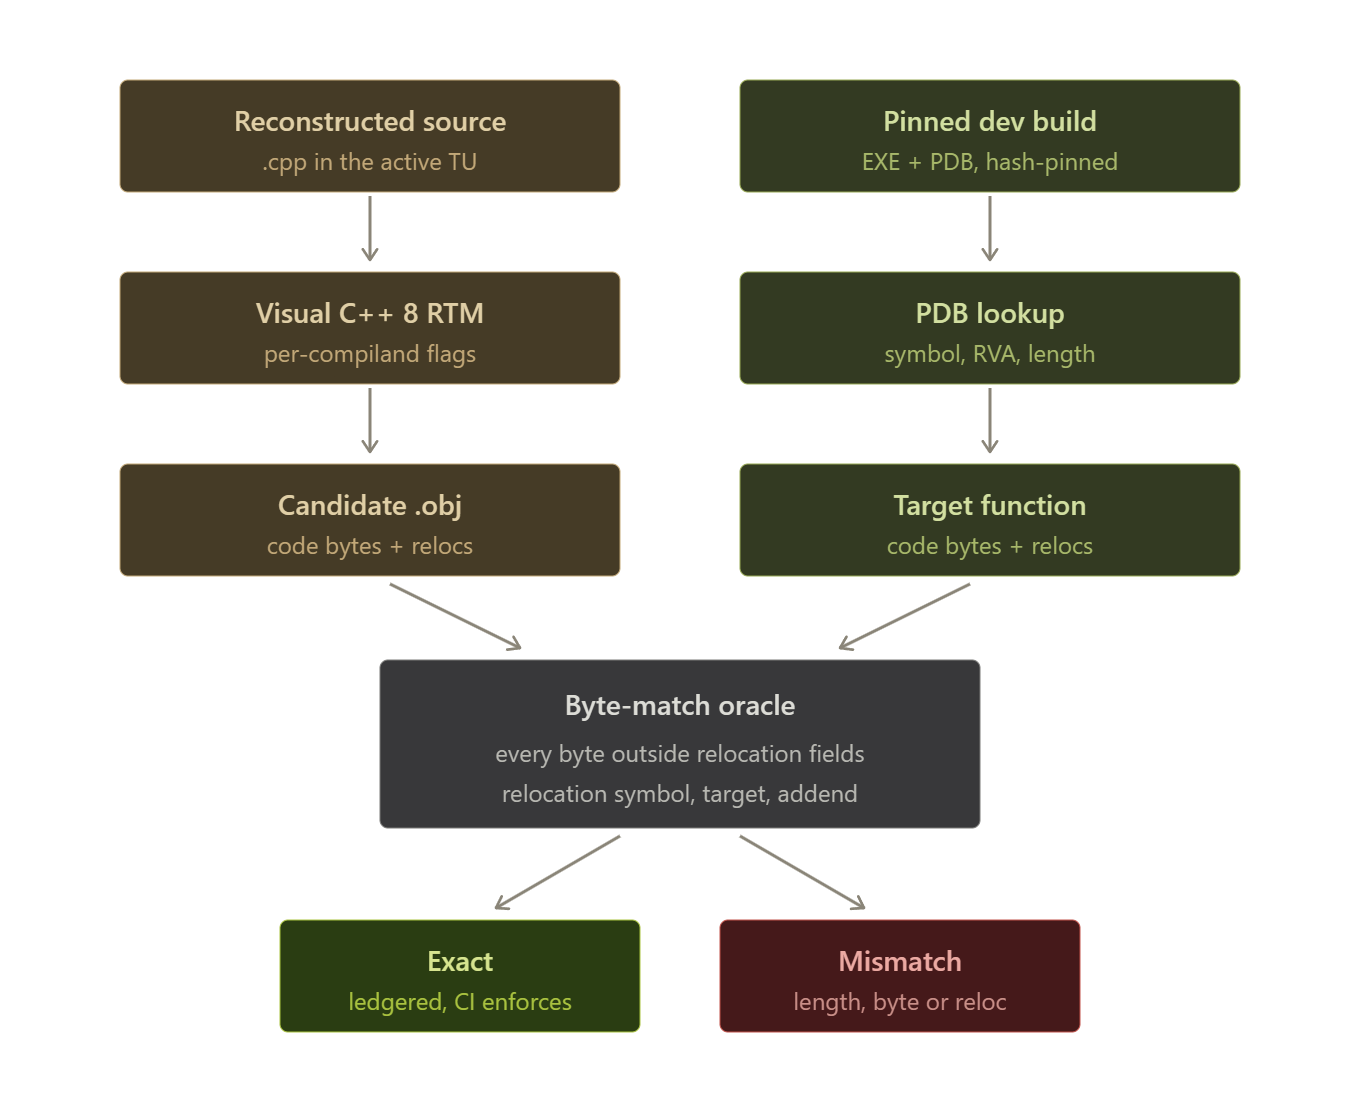 Abbildung: Erfolgsquote der bytegenauen Funktionsverifikation über die Zeit. Quelle: Maurices Blog
Harte Abnahmekriterien: Wie kleine Modelle 83 % Byte-Präzision lieferten
Der bytegenaue Abgleich steigerte den Schwierigkeitsgrad für jede einzelne Funktion massiv. Moderne Compiler reagieren extrem empfindlich auf die Registerallokation; minimale Anpassungen an Inlining-Heuristiken oder Aufrufkonventionen verändern den Maschinencode grundlegend. Unter ungünstigen Bedingungen erzeugt derselbe Quellcode sogar unterschiedliche Kompilate.
Der ingenieurtechnische Mehrwert war jedoch enorm. Sobald eine Funktion den Byte-Vergleich bestand, war garantiert, dass ihre Semantik exakt dem Original entsprach – inklusive aller historischen Bugs. Mit der Etablierung dieser maschinellen Basis wurde der Reviewer-Agent überflüssig und die Prüfschleife drastisch vereinfacht.
Noch bemerkenswerter war der Wandel bei der Modellauswahl. In der freien Generierungsphase ohne harte Leitplanken versagten günstige Modelle wie Claude Haiku oder Luna kläglich. In einer Umgebung mit hochfrequentem Compiler-Feedback und automatischen Wiederholungsversuchen erreichten kleine Modelle jedoch eine herausragende Effizienz. Das Team erweiterte den Cluster schließlich auf 14 Luna-Instanzen in Kombination mit 2 Opus-5.5-Einheiten und erzielte so einen enormen Durchsatz bei minimalen Modellkosten.
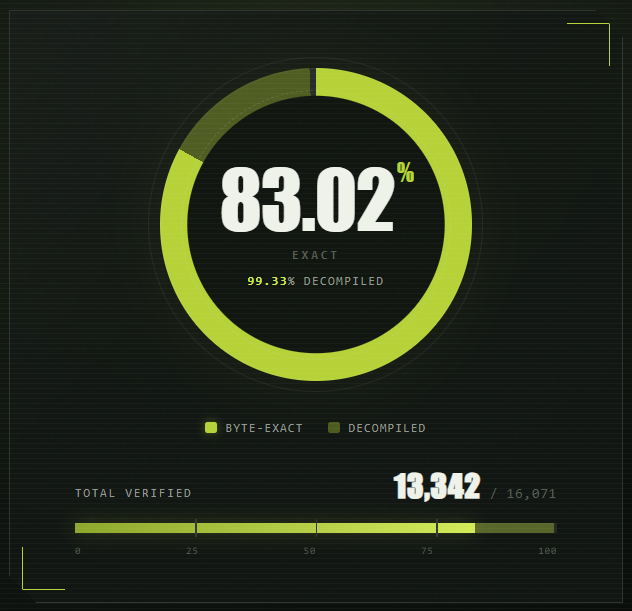 Abbildung: Finale Rekonstruktionsrate und Fortschritt der Byte-Übereinstimmung nach Modulen. Quelle: Maurices Blog
Kontext- und Kommunikationssteuerung: Orchestrierung in der Pipeline bündeln
Über die monatelange Laufzeit war die Beherrschung der organisatorischen Entropie im Multi-Agenten-System ebenso erfolgskritisch. Dekompilierungssitzungen erzeugen gigantische Mengen flüchtiger Daten. Das Team senkte die Schwelle für die Kontextkomprimierung von standardmäßig 90 % auf 42 % ab. Um ein Vergessen zentraler Anweisungen zu verhindern, wurden einheitliche Engineering-Richtlinien aufgesetzt und stündlich per Cron-Job neu injiziert.
Auch die Kommunikationsarchitektur wurde radikal eingedampft. Anfangs tauschten sich die Agenten in Discord-Kanälen aus und empfingen dort Fehlermeldungen der CI. Nach der Skalierung auf 16 Instanzen legte die Nachrichtenflut die Zusammenarbeit jedoch rasch lahm. Das Team kappte überflüssige Dialoge und beschränkte den Datenverkehr auf zwei Dimensionen: das Zuweisen von Aufgaben (Issues) und die Rückmeldung des Build-Status. Gegen Ende des Projekts kommunizierten menschliche Entwickler so gut wie gar nicht mehr dialogisch mit den Agenten.
Auch Sicherheitsrisiken in der Ausführungsumgebung erforderten strikte Isolation. Nachdem ein Modell durch einen fehlerhaften Befehl versehentlich eine virtuelle Festplatte gelöscht hatte, erweiterte Maurice seinen Emulator Sogen zu einer schlanken Sandbox. Abseits der Technik meldeten sich zudem rechtliche Risiken: Wegen der Berührung kommerzieller Urheberrechte mussten frühe technische Blogbeiträge offline genommen werden, und der rekonstruierte Quellcode kann nicht öffentlich publiziert werden.
Der teure Versuch mit hunderten Milliarden Tokens liefert eine klare Lehre für moderne Software-Entwicklungsagenten: Der eigentliche Engpass für autonome KI-Programmierung liegt darin, ob Korrektheit maschinell und kostengünstig verifiziert werden kann. Ohne unnachgiebige Akzeptanzkriterien auf Compiler-Ebene bleibt selbst der eleganteste Code nur eine leere Hülle.
Sobald Verifikation auf einen reinen maschinellen Abgleich reduziert wird, können selbst preiswerte Modelle durch reine Rechenkraft hochkomplexe Industriesoftware rekonstruieren. Die Zukunft des Agentic Engineering hängt von der Tiefe automatisierter Bewertungsmechanismen ab.
Weiterführende Links:
- Maurice’ persönlicher Tech-Blog: Protokoll des Reverse Engineerings eines kommerziellen FPS
- Archiv: Systemdesign für automatisierte Dekompilierung und Multi-Agenten-Koordination