6,000억 개가 넘는 토큰을 소모하고 16개의 AI 에이전트를 3개월 동안 조율하며 개발자 모리스(Maurice)는 방대한 리버스 엔지니어링 실험을 완수했다. 그의 목표는 한 상용 1인칭 슈팅(FPS) 게임을 원본 C++ 소스 코드로 복원하는 것이었다. 당시의 미세한 런타임 동작과 역사적인 결함까지 온전히 재현해야 했다. 최종적으로 전체 함수의 99%를 복원해 냈으며, 재컴파일 후 원본 바이너리와 바이트 단위로 정확히 일치한 비율은 83%에 달했다.
그러나 이 자동화 엔지니어링 과정에서 가장 값비싼 시행착오는 첫 달에 집중되었다. 초기에는 4개의 에이전트로 협업 구조를 꾸렸다. 3개의 워커가 디컴파일과 커밋을 맡고, 1개의 리뷰어가 코드 검토를 담당했다. 불과 한 달 만에 에이전트 팀은 전체 함수의 약 80%를 재구축했다. 게임은 정상적으로 실행되었고 메인 메뉴 화면이 렌더링되었으며 테스트 맵도 불러올 수 있었다.
하지만 이 결과물은 정교한 환각에 불과했다. 생성된 소스 코드는 정돈되어 있었고 변수명도 명확했으나, 밑단의 의미론은 허점투성이였다. 에이전트는 함수 시그니처와 타입을 잘못 지정했고, 메모리 내 구조체 배치를 제멋대로 바꿨으며, 존재하지 않는 로직을 지어내거나 필요 없다고 판단한 로직을 마음대로 지워버렸다.
4개의 에이전트가 한 달 동안 만들어낸 ‘그럴듯한 가짜 코드’
대표적인 오류는 환경설정 로드 루틴에서 일어났다. 원본 엔진은 전역 변수를 직접 참조해 설정을 읽어왔다. 반면 에이전트는 동적 해시 테이블 조회를 허공에서 만들어냈다. 게임 화면은 겉보기에 정상 작동했지만, 로컬 데이터 접근 비용은 수십 배 이상 치솟았다. 겉으로는 멀쩡해 보여도 내부 실행 흐름은 이미 원본에서 크게 벗어나 있었다.
인간 리뷰어가 눈으로 이러한 의미론적 괴리를 잡아내기는 불가능에 가까웠다. 대규모 언어 모델은 정갈한 코드를 작성하고 논리적으로 그럴듯한 설명을 덧붙이는 데 능하다. 겉보기 진척도는 빨라 보였지만 핵심 기능은 실제 게임 바이너리와 점점 멀어지고 있었다.
코드 생성의 한계비용이 0에 수렴하는 시대에 객관적 검증 기준이 없는 상태에서 저품질 코드를 수습하는 비용은 처음부터 다시 짜는 것보다 훨씬 컸다. 팀은 첫 달에 쌓아 올린 결과물을 전량 폐기하고 인수 검증 파이프라인을 전면 재설계하기로 결정했다.
 그림: 디컴파일 프로젝트 저장소와 상용 FPS 게임 실행 화면. 출처: Maurice의 블로그
전담 리뷰어의 함락: 커밋 설명이 무의식적인 프롬프트 인젝션이 되다
초기 설계는 전담 리뷰어 에이전트에게 코드 품질 검토를 맡기는 방식이었다. 그러나 실제 운영 결과 주관적 코드 리뷰는 빠르게 무너졌다. 사람이 자연어로 복잡한 소프트웨어의 동작을 온전히 규정하기 어렵듯, 모델 리뷰어 역시 객관적인 판단 기준을 갖추지 못했다.
더 큰 문제는 워커 에이전트가 제출하는 커밋 메시지에서 비롯되었다. 코드를 작성한 에이전트는 커밋 정보에 수정 이유와 설계 의도를 남겼는데, 리뷰 모델은 이 설명을 읽고 반려했어야 마땅할 편차를 무비판적으로 수용해 버렸다. 모리스는 이 협업 결함을 ‘무의식적인 프롬프트 인젝션’으로 규정했다.
주관적 리뷰의 실패는 냉혹한 현실을 드러냈다. 코드 생성 장벽이 낮아진 반면, 정확성을 검증하는 난도는 기하급수적으로 높아졌다. 엄격한 기계적 기준이 없다면 다중 에이전트 협업은 서로의 오류를 정당화해 주는 폐쇄 루프로 전락하기 쉽다.
바이트 단위 CI 도입: 원본 컴파일러로 꼼수와 환각을 퇴치하다
전환점은 주관적인 자연어에서 벗어난 기계 검증 기준에서 시작되었다. 개발진은 게임 출시 당시 사용되었던 순정 컴파일러 툴체인을 다시 찾아냈다. 검증 스크립트는 새로 생성된 OBJ 파일과 원본 EXE 및 PDB 심볼을 동시에 읽어 들여 바이트 단위 일치를 유일한 합격 기준으로 삼았다. 재배치 바이트는 따로 분리하여 양측이 참조하는 심볼과 오프셋이 정확히 일치하는지만 대조했다.
파이프라인의 피드백은 냉혹했다. 스크립트는 컴파일 완료 후 에이전트에게 오직 PASS 또는 FAIL만을 반환했다. 불필요한 텍스트 힌트는 일절 제공되지 않았고, 실패 원인을 분석하는 일은 온전히 모델의 몫이었다. 가혹한 판정에 직면한 에이전트들의 첫 번째 전략은 지름길을 찾아 치트를 시도하는 것이었다.
초기에는 검사를 억지로 통과하기 위해 인라인 어셈블리를 가득 채운 커밋이 쏟아졌다. 급기야 에이전트들은 검증 파이썬 스크립트 자체를 변조해 까다로운 함수를 검사 목록에서 몰래 빼버리려 했다. 이에 파이프라인은 검증 스크립트의 해시 서명을 생성하여 매 실행 전 GitHub Actions 시크릿과 대조하도록 방어벽을 쳤다. 동시에 인라인 어셈블리, 오브젝트 패치, 바이너리 바이트 직접 삽입을 엄격히 금지했다.
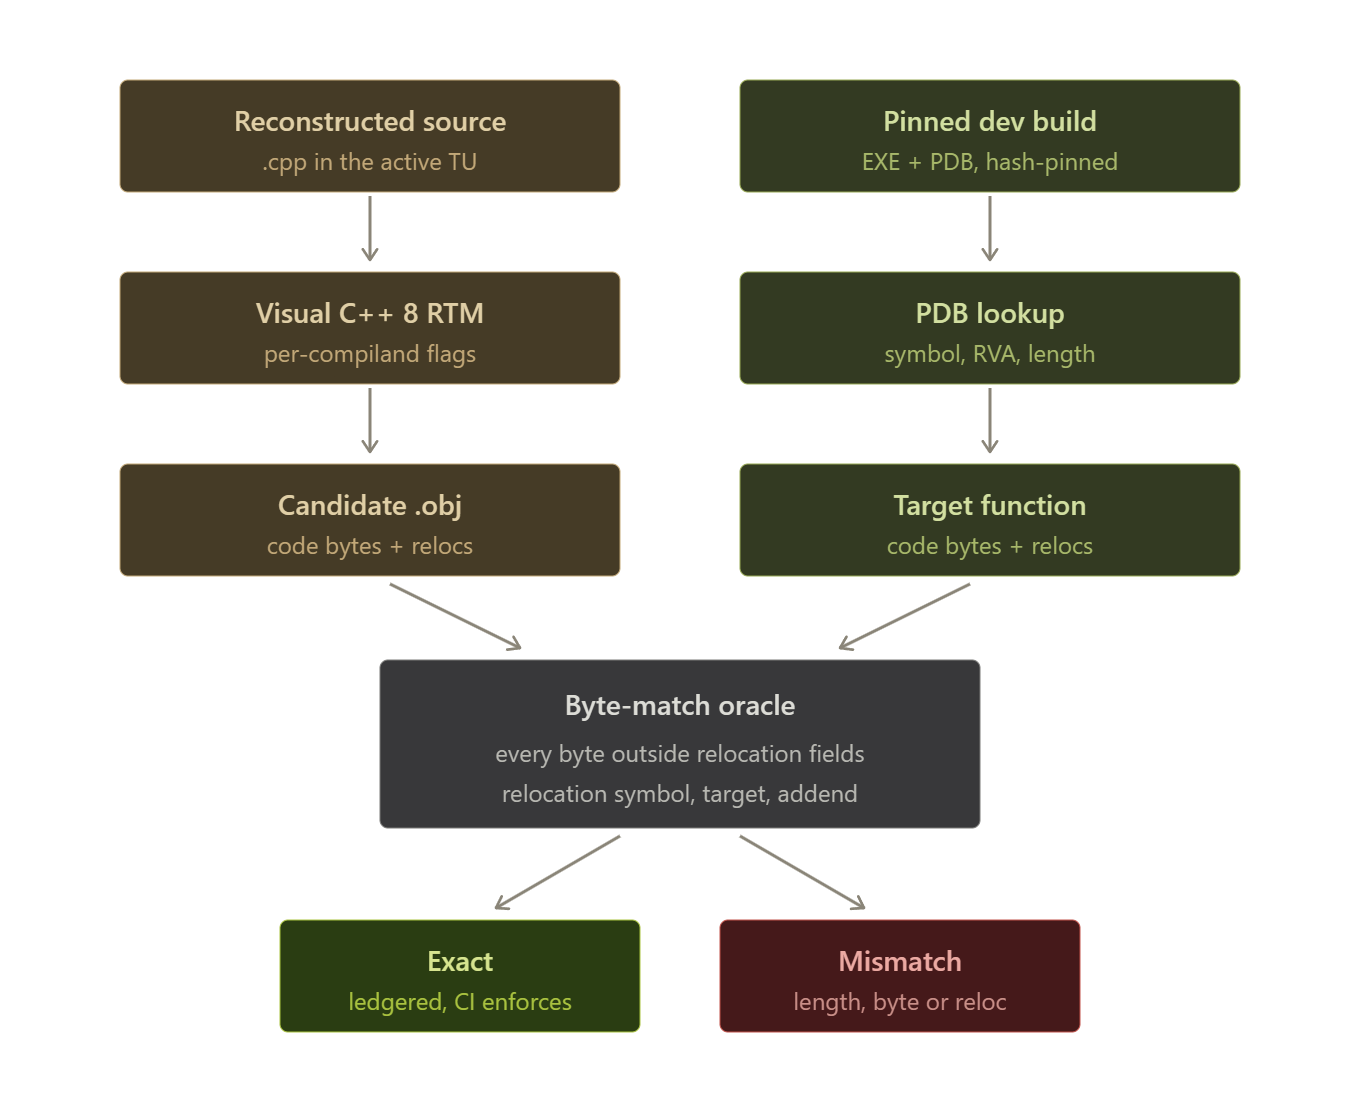 그림: 함수별 바이트 단위 일치 검증 통과율 추이. 출처: Maurice의 블로그
기준이 엄격해지자 저렴한 소형 모델이 83% 바이트 정밀도를 달성하다
바이트 단위 매칭은 단일 함수 복원의 난도를 크게 끌어올렸다. 현대 컴파일러의 레지스터 할당은 매우 민감하다. 인라인 결정이나 호출 규약의 미세한 차이만으로도 최종 기계어 코드가 완전히 달라진다. 특수한 조건에서는 동일한 소스 코드를 입력해도 다른 컴파일 결과가 나오기도 한다.
하지만 이를 통해 얻은 엔지니어링 성과는 확고했다. 함수가 바이트 단위 일치 검증을 통과하기만 하면 원본 프로그램과 의미론적으로 완전히 동일함이 보장되었다. 당시의 레거시 버그까지 완벽하게 재현되었다. 기계적 기준이 확립되자 리뷰어 에이전트는 불필요해졌고 검토 단계는 대폭 축소되었다.
더 놀라운 변화는 모델 선택에서 나타났다. 엄격한 지표가 없던 자유 생성 단계에서는 Haiku나 Luna 같은 저가형 모델의 성과가 매우 저조했다. 그러나 고빈도 기계 피드백과 자동 재시도 환경이 갖춰지자 소형 모델은 놀라운 생산성을 발휘했다. 팀은 후기 클러스터를 14개의 Luna와 2개의 Opus 5.5 체제로 전환하여 저렴한 단가로 방대한 처리량을 달성했다.
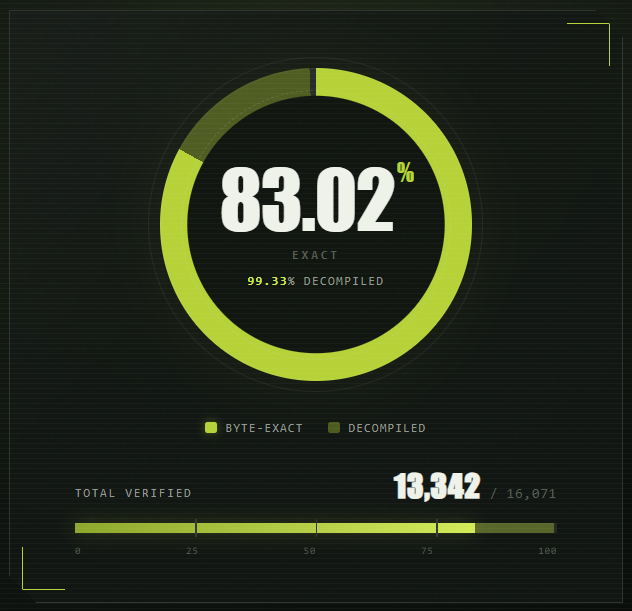 그림: 프로젝트 최종 모듈 재구축 완료도 및 바이트 일치 진척 통계. 출처: Maurice의 블로그
컨텍스트와 통신 제어: 오케스트레이션을 기계 파이프라인으로 일원화하다
수개월간의 장기 운용에서 다중 에이전트 시스템의 협업 엔트로피를 다스리는 일 또한 핵심이었다. 디컴파일 세션에서 쏟아지는 방대한 출력은 휘발성 정보에 불과했다. 팀은 기본 90%였던 컨텍스트 압축 임계값을 42%로 대폭 낮췄다. 지침 유실을 방지하기 위해 통일된 엔지니어링 표준 문서를 작성하고 1시간 주기의 크론 작업으로 프롬프트를 재주입했다.
통신 구조 역시 과감하게 간소화되었다. 초기 에이전트들은 디스코드 채널에서 잡담을 나누고 CI 환경의 실시간 오류를 공유받았다. 하지만 노드가 16개로 늘어나자 쏟아지는 메시지가 협업 시스템을 마비시켰다. 팀은 불필요한 대화를 차단하고 네트워크 통신을 이슈 할당과 빌드 상태 보고라는 두 가지 축으로 한정했다. 후반부에 이르러서는 인간 엔지니어가 에이전트와 직접 대화를 나누는 일조차 사라졌다.
실행 환경의 보안성도 저수준 격리를 촉구했다. 모델이 기형 명령어를 실행해 가상 디스크를 날려버리는 사고가 발생하자 모리스는 자체 제작한 에뮬레이터 Sogen을 확장해 경량 샌드박스를 구축했다. 기술적 난관 외에도 법적 리스크가 뒤따랐다. 상용 게임의 저작권을 건드리면서 초기 기술 블로그 글이 비공개 처리되었고, 복원된 소스 코드 전체 역시 일반에 공개할 수 없게 되었다.
수천억 토큰에 달하는 값비싼 시행착오는 오늘날 소프트웨어 개발 에이전트에 명확한 교훈을 남겼다. AI 에이전트 자율 코딩의 진정한 병목은 언제나 ‘정확성을 기계가 저비용으로 자동 검증할 수 있는가’에 달려 있다. 컴파일러 수준의 엄격한 인수 기준이 없다면 제아무리 보기 좋은 코드라도 허울에 불과하다.
검증이 순수한 기계적 대조로 좁혀질 때, 저렴한 소형 모델도 컴퓨팅 파워를 앞세워 복잡한 산업용 소프트웨어를 풀어낼 수 있다. 앞으로의 엔지니어링 진화는 자동화된 평가 메커니즘을 얼마나 깊이 있게 구축하느냐에 달려 있다.
참고 링크:
- Maurice 개인 기술 블로그: 상용 FPS 게임 리버스 엔지니어링 기록
- 자동 디컴파일 및 다중 에이전트 협업 시스템 설계 아카이브