2024년 말, 개발자 커뮤니티에서는 “RAG(검색 증강 생성)의 시대는 끝났다”는 주장이 힘을 얻었다. 방대한 문서와 코드베이스를 프롬프트 창에 통째로 밀어 넣으면 복잡한 검색 아키텍처를 걷어낼 수 있을 것처럼 보였다. 그러나 실제 프로덕션 환경이 보여준 현실은 정반대였다. 입력 데이터가 늘어날수록 모델은 정해진 궤도에서 더 쉽게 벗어났다.
2026년 10월, 기술 저술가 드루 브로이닉(Drew Breunig)은 AGNTCon 콘퍼런스에서 지난 1년간의 기술적 전환을 되짚었다. 컨텍스트 엔지니어링의 본질적인 진화는 용량 확장이 아니라, 컨텍스트 조립의 주도권을 결정론적 코드로 완전히 되찾아오는 데 있었다. 장기 실행 작업에서 드러난 새로운 함정에 맞서기 위해, 시스템은 과감한 망각 메커니즘을 코드 수준에서 구축해야 한다.
100만 윈도우도 RAG를 끝내지 못했다: 무차별 데이터 주입이 부른 모델의 방황
Gemini 1.5가 거대 컨텍스트 경쟁의 포문을 열면서 100만 토큰은 빠르게 업계 표준으로 자리 잡았다. 뒤이어 메타(Meta)가 Llama 4 Scout을 통해 수천만 토큰에 달하는 윈도우를 오픈소스 생태계에 내놓았지만, 이 거대한 용량이 실제 프로덕션 도입으로 이어지지는 않았다. 브로이닉의 표현을 빌리자면, 커뮤니티는 그 후 다음 세대의 Llama를 기약 없이 기다려야 했다.
거대한 컨텍스트 윈도우는 검색을 없애지 못했고, 오히려 무차별 프롬프트 주입의 취약성을 여실히 드러냈다. 정리되지 않은 문서가 대량으로 밀려들면 어텐션 메커니즘이 분산되고 검색 재현율(Recall)이 급격히 떨어진다. 모델이 스스로 노이즈를 걸러내고 핵심을 파악할 것이라는 가정은 까다로운 실무 환경에서 힘없이 무너졌다. 롱 컨텍스트는 강력한 저수준 역량이지만, 결코 그대로 쓸 수 있는 만병통치약이 아니다.
게다가 장기 실행 에이전트 작업에서 컴퓨팅 자원 소모는 컨텍스트 길이에 따라 비선형적으로 폭증한다. 도구를 호출할 때마다 비대해진 이전 토큰을 매번 다시 읽어야 하므로 심각한 지연 시간과 GPU 메모리 병목이 발생한다. 전처리 필터링이 없는 무차별 주입은 엔터프라이즈 인프라 비용을 통제 불능 상태로 몰고 갔다. 결국 소프트웨어 하네스가 정보 유입의 밸브를 다시 쥐어야 했다.
차를 찾아 헤매는 집착부터 반례 오염까지: 초기 시스템의 4가지 함정
통제 불능으로 치닫는 컨텍스트 위험에 맞서, 브로이닉은 2025년 네 가지 전형적인 실패 모드를 정리했다. 바로 컨텍스트 중독(Poisoning), 컨텍스트 산만(Distraction), 컨텍스트 혼동(Confusion), 그리고 컨텍스트 충돌(Clash)이다. 시스템이 이 중 어느 하나라도 밟는 순간 출력 추론은 순식간에 망가진다.
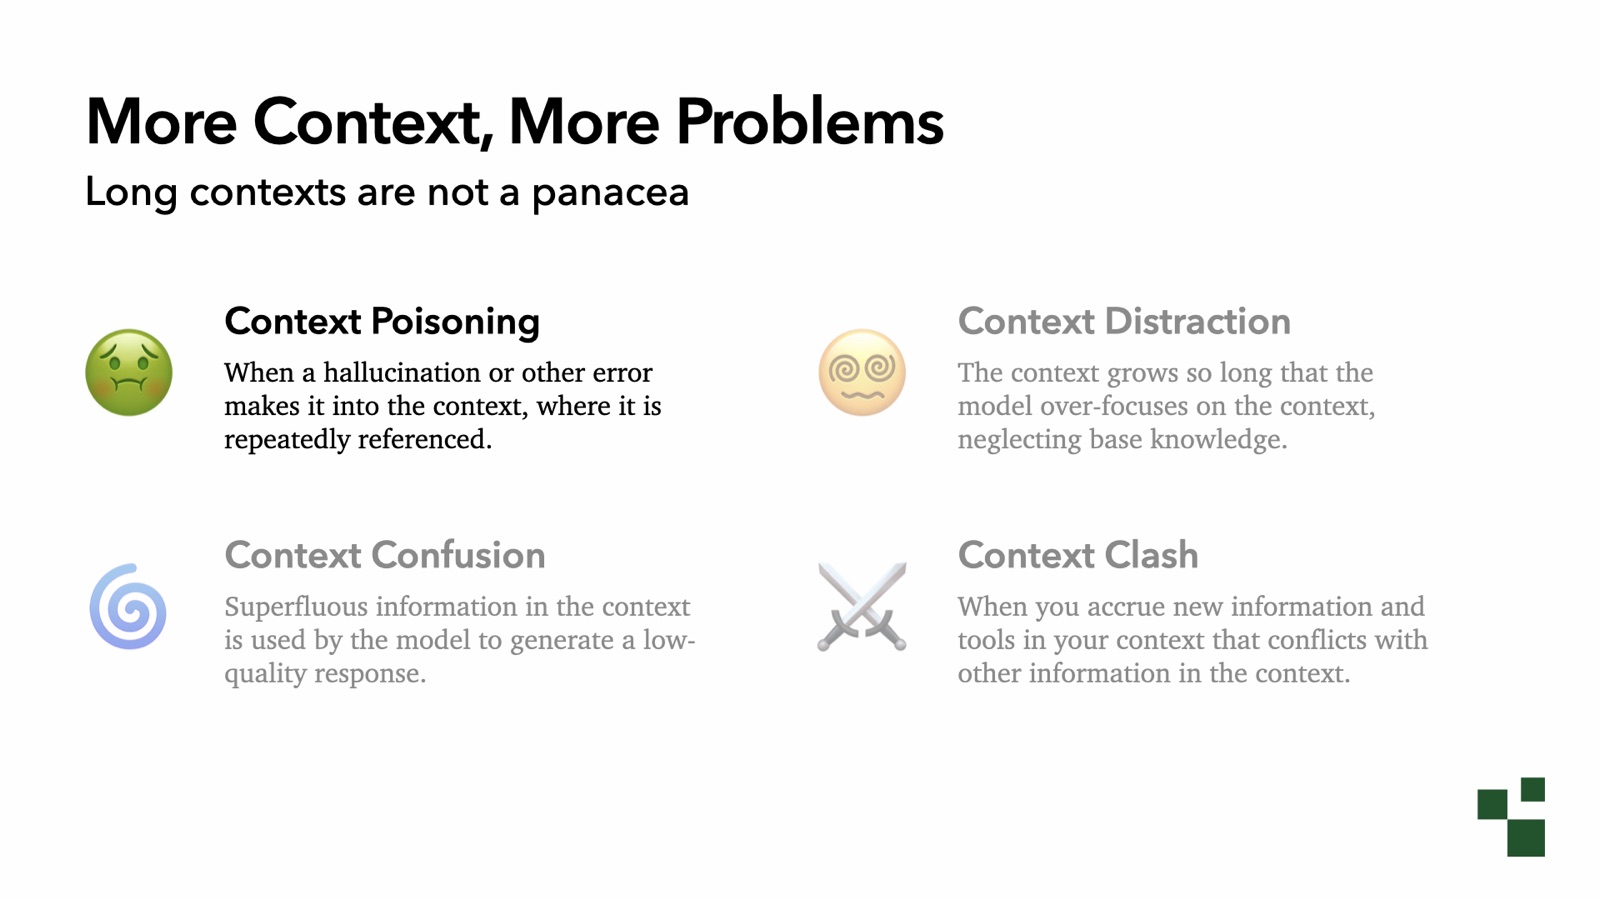 그림: 롱 컨텍스트가 초래하는 4대 실패 모드: 중독, 산만, 혼동, 충돌. 출처: Drew Breunig 발표 자료 ‘More Context, More Problems’
컨텍스트 중독의 대표적인 사례는 구글 딥마인드(Google DeepMind)의 기술 보고서에 잘 기록되어 있다. 초대 《포켓몬스터 레드》에서는 경비원에게 음료수(레모네이드)를 건네 통과하지만, 리메이크판인 《파이어레드》에서는 통과 아이템이 차(Tea)로 바뀌었다. Gemini 2.5 Pro가 게임을 자율 플레이할 때, 사전 학습 지식이 잘못 활성화되면서 반드시 차를 구해야 한다는 집착에 사로잡혔다.
모델은 작업 목록에 “차 찾기”를 등록한 뒤 게임 속을 몇 시간 동안 무의미하게 헤맸다. 잘못된 가설이 대화 기록에 한 번 기록되면 모델은 그 목표를 스스로 우회하지 못한다. 보고서 부록은 더 냉혹한 현실을 보여준다. 컨텍스트가 10만 토큰을 넘어서자 에이전트는 과거 행동을 기계적으로 반복하기 시작했고, 새로운 경로를 탐색하고 계획하는 능력을 완전히 잃어버렸다.
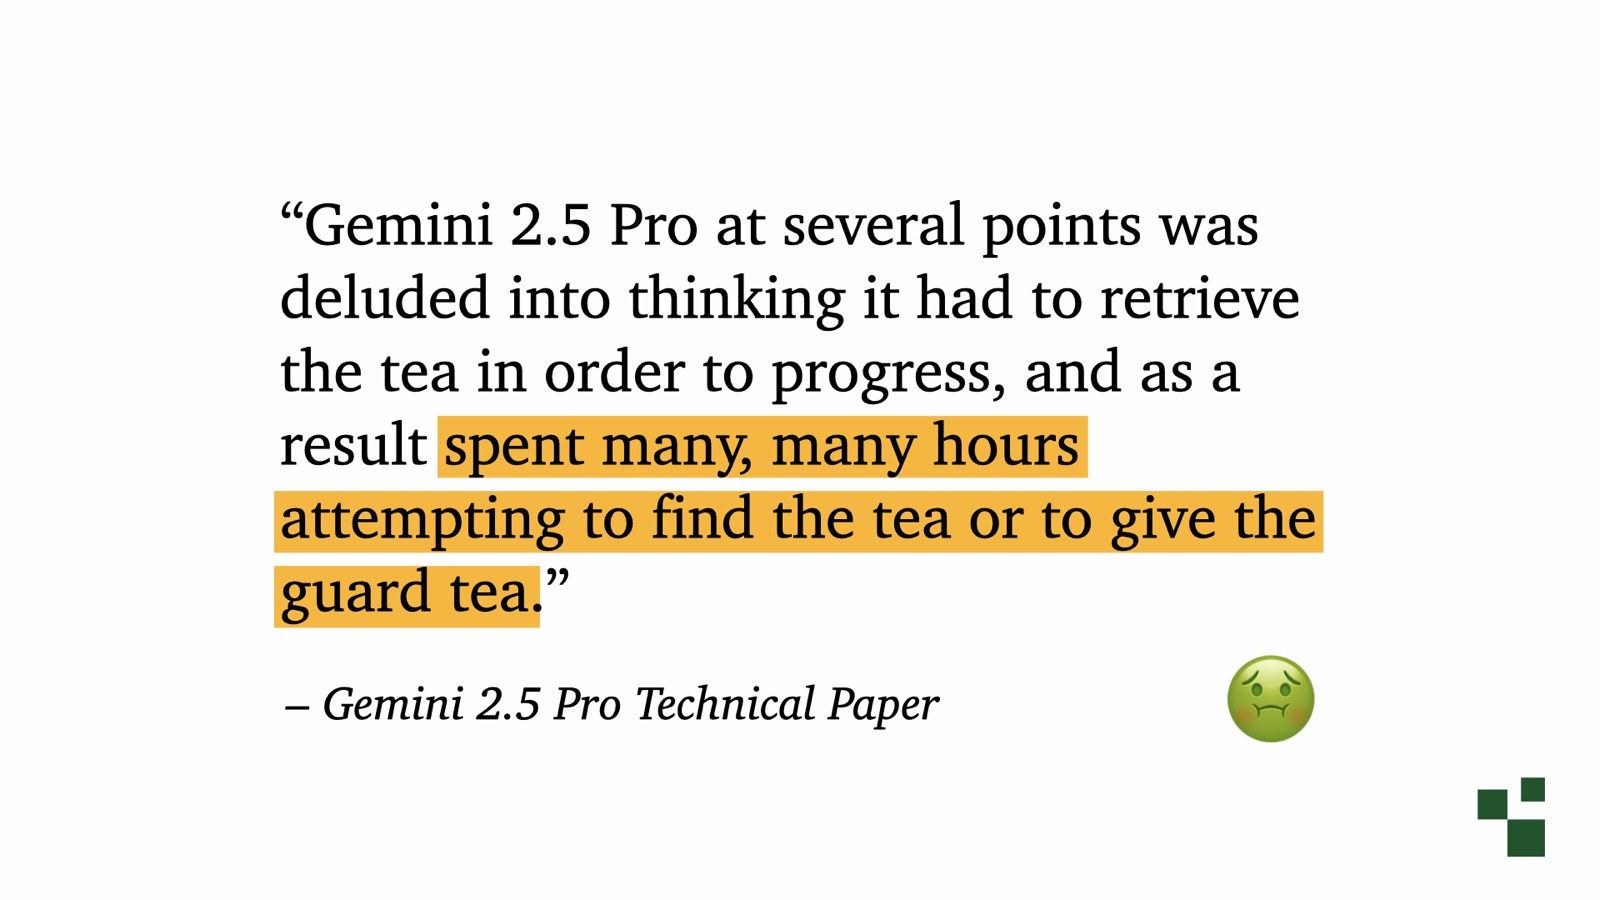 그림: 잘못된 사전 지식으로 인해 차 찾기에 집착하며 컨텍스트 중독 증상을 드러낸 Gemini 2.5 Pro. 출처: Google DeepMind 기술 보고서 (Drew Breunig 인용)
컨텍스트 산만의 위험성은 카롤리나 카마사(Carolina Camassa)와 데릭 쉴러(Derek Shiller)의 논문 《Do as I Say, Not as I Do》에서 엄밀하게 입증되었다. 연구진은 모델에 사용자 입력을 러시아어로 번역하도록 지시하면서, 컨텍스트 내에 1개에서 50개의 프랑스어 반례(오답 예시)를 섞어 넣었다. 실험 결과 Gemma 3 12B는 불과 몇 개의 반례만으로도 지시 준수율이 절반 이하로 떨어졌다. 최첨단 모델인 Opus 4.6 역시 반례가 누적되자 성능이 가파르게 저하되었다.
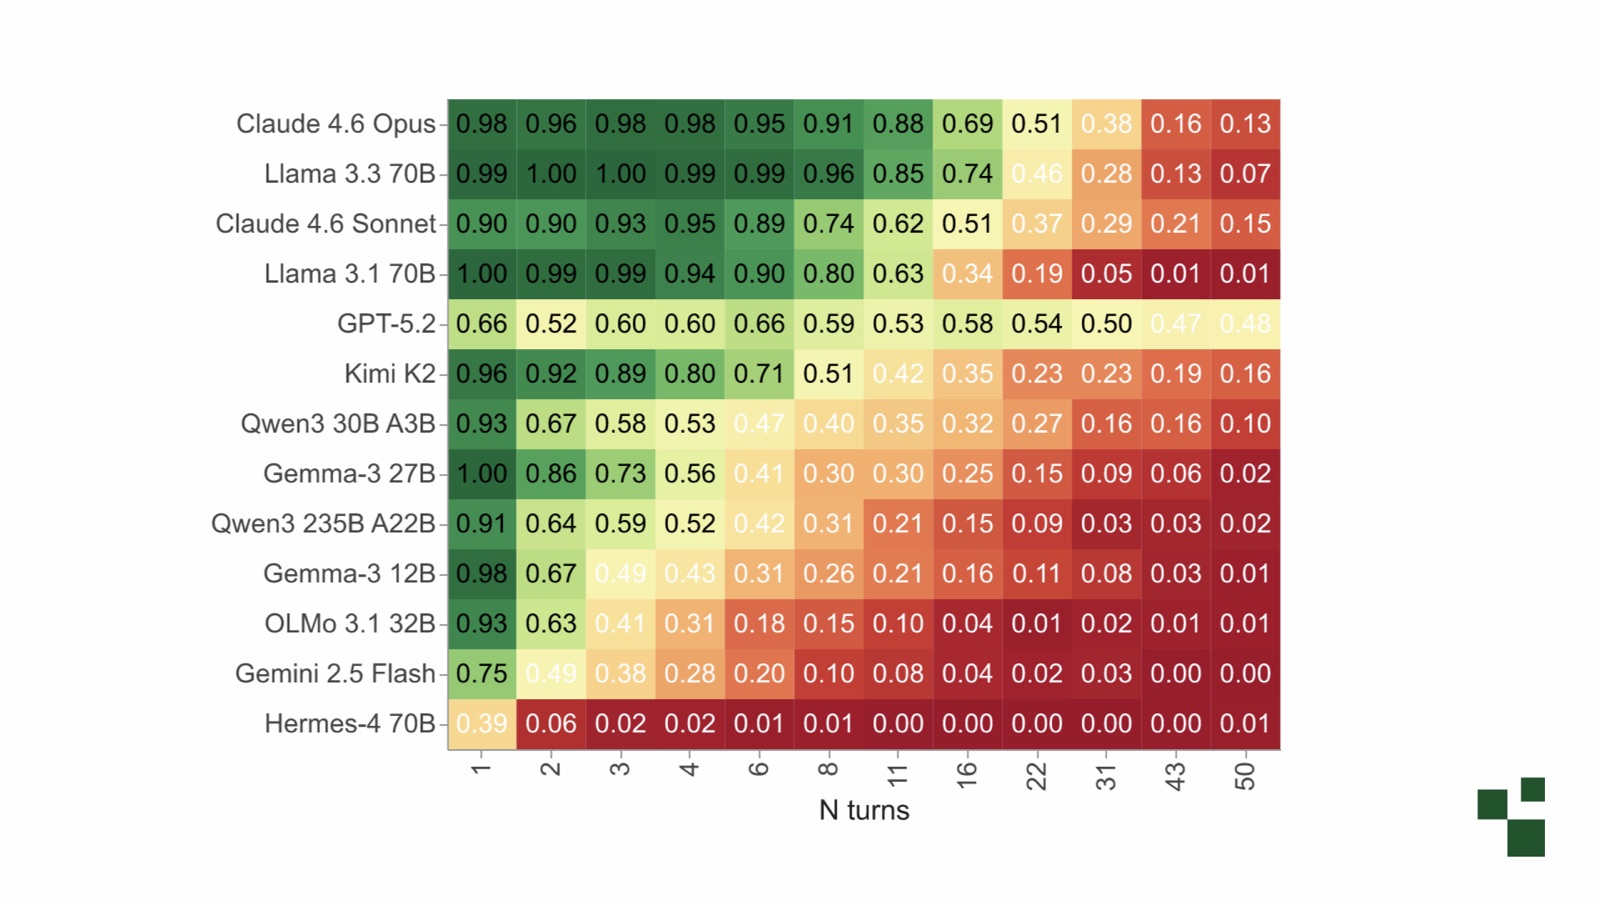 그림: 컨텍스트 내 반례 수가 증가함에 따라 최첨단 모델의 시스템 지시 준수율이 지속적으로 하락하는 모습. 출처: Camassa & Shiller 논문 (Drew Breunig 인용)
이 실험은 코딩 에이전트 개발 환경에서 벌어지는 치명적인 문제를 적나라하게 보여준다. 프론트엔드 스타일을 잡기 위해 엔지니어가 여러 번 시도하며 실패한 CSS 코드 조각을 에이전트에 반복해서 전달했다고 치자. 이 디버깅 찌꺼기들이 바로 개발자가 직접 주입한 반례가 되어 모델의 시스템 프롬프트 준수 능력을 안쪽에서 무너뜨리는 것이다.
컨텍스트 혼동과 충돌도 빈번하게 일어난다. 모델은 프로필의 단편적인 내용을 바탕으로 섣부른 추측을 내린다. 브로이닉은 일상 대화가 기술 분석을 오염시키지 않도록 상용 모델의 메모리 기능을 아예 비활성화했다. 또한 에이전트 플랫폼에 수백 개의 도구를 무분별하게 적재하면 인터페이스 정의 충돌로 인해 의사결정 파이프라인 전체가 마비된다.
단 16줄의 코드로 되찾은 제어권: 결정론적 함수로 컨텍스트 재구축하기
업계 용어는 지난 3년간 빠르게 변했다. 2023년의 프롬프트 엔지니어링에서 2025년 컨텍스트 엔지니어링으로, 2026년에는 하네스(Harness) 엔지니어링으로 무게중심이 이동했다. 간판은 바뀌었지만 공학적 본질은 한결같다. 컨텍스트를 구성하는 권한을 확률적인 모델 추론에서 결정론적인 코드로 되찾아오는 일이다.
컨텍스트 팽창에 대응하는 아키텍처 도구는 지난 6년간 기본 뼈대를 유지해 왔다. 바로 보강(Augment), 적재(Load), 격리(Isolate), 가지치기(Prune), 외부화(Offload), 요약(Summarize)이라는 6가지 메커니즘이다. 각각 정밀한 검색, 스키마 축소, 독립 세션 실행, 불필요한 데이터 제거, 외부 영속화, 대화 압축을 담당한다.
과도한 도구 노출은 시스템 마비의 주된 원인이다. 어떤 엔터프라이즈 솔루션은 시작 시 600개의 확장 도구를 한꺼번에 불러와 에이전트를 혼란에 빠뜨렸다. 개발팀이 코드에 온디맨드 필터링 함수를 추가해 필요한 도구만 골라 전달하자 시스템은 즉시 정상을 되찾았다.
DSPy 프레임워크 기반 아키텍처는 이러한 주도권 전환을 명확히 보여준다. 에이전트의 핵심 루프는 사실 ReAct 의사결정 모듈이 결합된 평범한 while 문에 불과하다. 주된 추론은 최첨단 파운데이션 모델이 이끌고, 각 단계의 도구 선별과 가지치기는 경량화된 특화 모델이 신속하게 처리한다.
격리 메커니즘은 깨끗한 새 세션을 여는 하위 에이전트로 동작하며, 가지치기 로직은 턴마다 불필요한 JSON 필드를 깎아낸다. 보강, 동적 적재, 가지치기, 요약을 메인 루프에 결합하는 핵심 로직은 단 16줄 안팎의 코드면 충분하다. 결정론적 제어 흐름은 토큰 비용을 대폭 낮출 뿐 아니라 시스템 프롬프트 캐시 적중률을 극대화한다.
프롬프트 대문자 연타의 이면: 적대적 가중치와 관성에 갇힌 에이전트
2026년에 접어들며 장시간 자율 실행 에이전트는 두 가지 새로운 난관에 부딪혔다. 바로 적대적 가중치(Adversarial Weights)와 컨텍스트 관성(Context Inertia)이다. 이 깊은 구조적 결함은 기존의 프롬프트 튜닝이 한계에 다다랐음을 방증한다.
적대적 가중치는 파운데이션 모델의 사전 학습 과정에서 굳어진 강력한 행동 편향에서 비롯된다. 경량 모델이 Playwright MCP 같은 도구를 통해 브라우저를 제어할 때, 학습 데이터에서 접했던 API 형태와 달라 첫 번째 호출이 번번이 실패하고 자가 교정을 거쳐야만 동작한다.
프롬프트에서 흔히 보이는 집요한 반복과 대문자(ALL CAPS) 강조는 적대적 가중치와 사투를 벌이고 있다는 증거다. Claude Code의 시스템 프롬프트에서는 “독립적인 도구 호출은 반드시 병렬로 실행하라”는 지침이 무려 7번 연속 반복되며, 다른 위치에서도 4번, 3번, 2번씩 거듭 강조된다. 모델 가중치 자체가 도구를 직렬로 호출하도록 굳어 있어, 외부 프롬프트가 고밀도의 반복 주입으로 내부 편향을 억지로 꺾어야 하기 때문이다.
컨텍스트 관성은 수 시간 동안 이어지는 자율 탐색 작업에 더 치명적인 걸림돌이 된다. 에이전트가 국소적인 난관에 봉착했을 때, 과거 기록에 남은 초기 가설이 닻 역할을 하며 모델을 막다른 골목에 묶어버린다. 버클리대와 마이크로소프트 연구소의 동시기 논문들은 이러한 집착이 낳는 부작용을 일제히 지적했다.
마이크로소프트의 《Fork-and-Flush》 연구에 나타난 성능 곡선은 전형적인 계단식 정체를 보인다. 작업 중후반에 이르면 에이전트의 수정 작업은 무의미한 겉핥기로 전락하며, 초기 가설에 완전히 발목을 잡힌다. 강화학습을 통해 심어준 끈기와 집착이라는 미덕이 다단계 탐색 작업에서는 오히려 스스로를 옭아매는 족쇄로 변질되는 것이다.
이 난제를 푸는 엔지니어링 해법은 놀라울 만큼 명쾌하다. 앤트로픽(Anthropic)은 장기 벤치마크를 통해 가장 효과적인 개입법이 90분마다 컨텍스트를 완전히 비우는(Flush) 것임을 발견했다. 파일 시스템과 생성된 코드 결과물은 보존하되 대화 기록을 완전히 지워, 모델이 전체 프로젝트 환경을 백지상태에서 다시 조망하도록 강제하는 것이다.
버클리대의 논문 《Scaling Discovery Requires Forgetting》 역시 똑같은 결론에 도달했다. 파이프라인에 주기적인 망각 메커니즘을 도입해야만 모델의 탐색 성능 곡선이 지속적인 우상향을 그린다. 개발자들이 에이전트가 둔해졌다고 느낄 때 컨텍스트는 대개 80만 토큰에 달해 있다. 브로이닉은 경계선을 20만 토큰으로 제시하며, 이 수치를 넘어서면 과거 기록을 과감히 덜어내야 한다고 강조한다.
12시간 연속 주행을 위하여: 제때 과거를 지우는 용기
에이전트 역량을 평가하는 시간 단위는 유례없이 길어지고 있다. METR 벤치마크 기준 GPT-5는 3.4시간 연속 작업을 견뎠고, Gemini 3.1은 6.4시간, Opus 4.6은 12시간 고지를 밟았다. 자율 작업이 며칠에 걸친 다중 에이전트 클러스터 협업으로 나아가면서 컨텍스트 관리는 한층 가혹한 현실 검증대에 서게 되었다.
상시 구동되는 개인용 에이전트에서는 이미 ‘기억의 부패(Memory Rot)’ 조짐이 나타나고 있다. 브로이닉이 6개월간 구동한 Hermes 에이전트를 추적 분석한 결과, 자율 생성된 스킬 라이브러리는 시간이 지날수록 정교해지기는커녕 조잡해졌다. 땜질식 코드가 서로 충돌하고, 범용 함수가 중복 생성되면서 메모리 계층의 엔트로피 증가가 실행 효율을 갉아먹었다.
끝없이 쌓이는 기록은 결국 의사결정 네트워크의 자중 붕괴를 부른다. 시스템에는 전략적 망각 메커니즘이 필요하다. 유효기간이 지난 정보를 과감히 지워내는 기술이야말로 장기 자율 에이전트가 풀어야 할 가장 시급한 엔지니어링 과제다.
거대언어모델의 출력 결과는 컨텍스트와 내부 가중치의 곱으로 요약할 수 있다. 엔지니어링 과제 앞에서 팀은 차세대 기반 모델이 나오기를 마냥 기다릴 수도 있고, 컨텍스트 파이프라인을 정교하게 깎아낼 수도 있다. 후자의 개선 비용은 전자의 10분의 1 수준에 불과하며, 엔지니어가 직접 쥐고 흔들 수 있는 유일한 변수다.
컨텍스트 엔지니어링은 무작정 창을 넓히던 초창기의 미숙함을 벗어던졌다. 단단한 아키텍처는 모델의 확률적 추론에 모든 것을 걸지 않으며, 결정론적 코드로 명확한 실행 경계를 세운다. 언제 조립의 키를 잡아야 하는지, 그리고 언제 과거를 과감히 지워야 하는지 아는 것이야말로 장기 자율 작업을 떠받치는 든든한 버팀목이다.
참고 링크:
- Drew Breunig 블로그 및 AGNTCon 발표: The State of Context Engineering
- Google DeepMind 기술 보고서: Gemini 2.5 Pro
- Carolina Camassa & Derek Shiller 논문: Do as I Say, Not as I Do
- Microsoft Research 논문: Fork-and-Flush
- UC 버클리 논문: Scaling Discovery Requires Forgetting