Ende 2024 hallte der Ruf „RAG ist tot“ lautstark durch die Entwicklergemeinde. Viele glaubten, wenn man nur ganze Codebasen und Dokumentenberge direkt in das Prompt-Fenster stopfe, könne man sich komplexe Retrieval-Architekturen sparen. Doch die Produktionspraxis lieferte rasch eine ernüchternde Lektion: Je mehr Rohdaten man dem Modell vorsetzt, desto leichter gerät es vom vorgesehenen Kurs ab.
Im Oktober 2026 zog der Tech-Autor Drew Breunig auf der AGNTCon-Konferenz Bilanz über diesen tiefgreifenden architektonischen Wandel. Die entscheidende Weiterentwicklung des Context Engineering bestand nicht in noch größeren Fenstern, sondern darin, die Kontextzusammenstellung wieder vollständig an deterministischen Code zu übergeben. Angesichts neuer systemischer Tücken bei Langläufer-Aufgaben müssen Systeme überdies fähig sein, entschlossen und programmgesteuert zu vergessen.
Millionen-Token-Fenster beendeten RAG nicht: Datenflut führt zu Orientierungslosigkeit
Mit der Veröffentlichung von Gemini 1.5 begann der Wettlauf um gigantische Kontextfenster; eine Million Token galten in der Branche schnell als Standard. Meta stieß mit Llama 4 Scout nach und brachte zweistellige Millionengrößen in die Open-Source-Welt. Doch dieses gewaltige Fassungsvermögen führte keineswegs zu einem entsprechenden Praxiseinsatz – wie Breunig bemerkte, wartete die Entwickler-Community monatelang vergeblich auf ein nächstes großes Llama.
Riesige Fenster machten das Auffinden relevanter Daten nicht überflüssig, sondern legten die Anfälligkeit blinder Prompt-Fütterung schonungslos offen. Werden unkuratierte Datenmassen in den Kontext gekippt, zerfasern die Aufmerksamkeitsmechanismen, und die Treffergenauigkeit sinkt drastisch. Die Annahme, das Basismodell könne schon von allein das Wesentliche herausfiltern, scheiterte im Praxiseinsatz kläglich. Ein langer Kontext ist eine mächtige Basisfunktion, aber beileibe kein Allheilmittel auf Knopfdruck.
Hinzu kommt, dass der Rechenressourcenverbrauch bei ausgedehnten Agentenaufgaben überproportional explodiert. Jeder weitere Werkzeugaufruf zwingt das Modell, den stetig anwachsenden Token-Verlauf erneut zu verarbeiten, was zu massiven Latenzen und enormem VRAM-Verbrauch führt. Das ungefilterte Fluten von Prompts treibt die Infrastrukturkosten für Unternehmen unweigerlich in die Höhe. Software-Harnesses mussten wieder die Kontrolle über die Informationsschleusen übernehmen.
Von der Teeverbissenheit bis zur Negativbeispiel-Vergiftung: Vier klassische Fallstricke
Angesichts ausufernder Kontexte systematisierte Breunig bereits 2025 vier klassische Fehlermuster: Kontextvergiftung (Poisoning), Kontextablenkung (Distraction), Kontextverwirrung (Confusion) und Kontextkollision (Clash). Tappt ein System in eine dieser Fallen, gerät die Argumentationskette unweigerlich aus den Fugen.
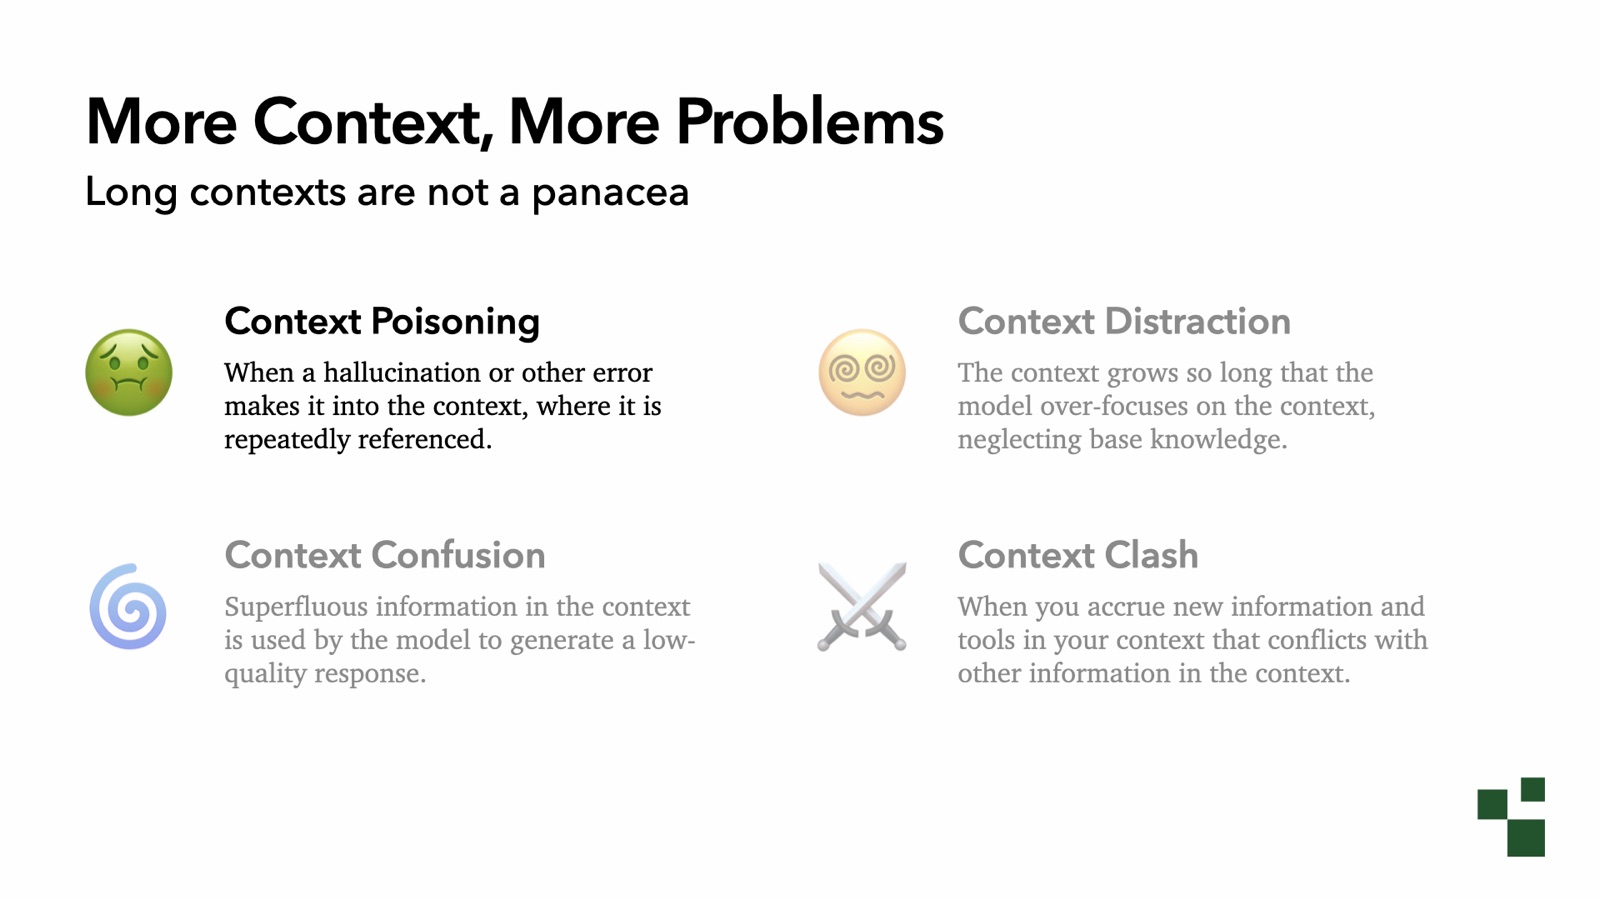 Grafik: Vier klassische Fehlermuster langer Kontexte: Vergiftung, Ablenkung, Verwirrung und Kollision. Quelle: Drew Breunigs Vortragsfolien „More Context, More Problems“
Ein markantes Beispiel für Kontextvergiftung hielt Google DeepMind in einem technischen Bericht fest. Im ursprünglichen Spiel Pokémon Rot besticht der Spieler eine Wache mit Limonade; in der Neuauflage Feuerrot wurde das erforderliche Item in Tee geändert. Als Gemini 2.5 Pro das Spiel eigenständig spielte, griff ein veraltetes Vorwissen, und das Modell war unerschütterlich davon überzeugt, unbedingt Tee finden zu müssen.
Das Modell trug „Tee suchen“ in seine Aufgabenliste ein und verbrachte anschließend Stunden damit, die Spielwelt vergeblich zu durchkämmen. Sobald sich eine fehlerhafte Annahme im Kontextverlauf festsetzt, kann das Modell sie nicht mehr überwinden. Der Anhang dokumentiert eine noch drastischere Tatsache: Ab einem Kontextvolumen von über 100.000 Token begann der Agent, frühere Aktionen nur noch mechanisch zu wiederholen, und verlor jede Fähigkeit, neue Lösungswege zu planen.
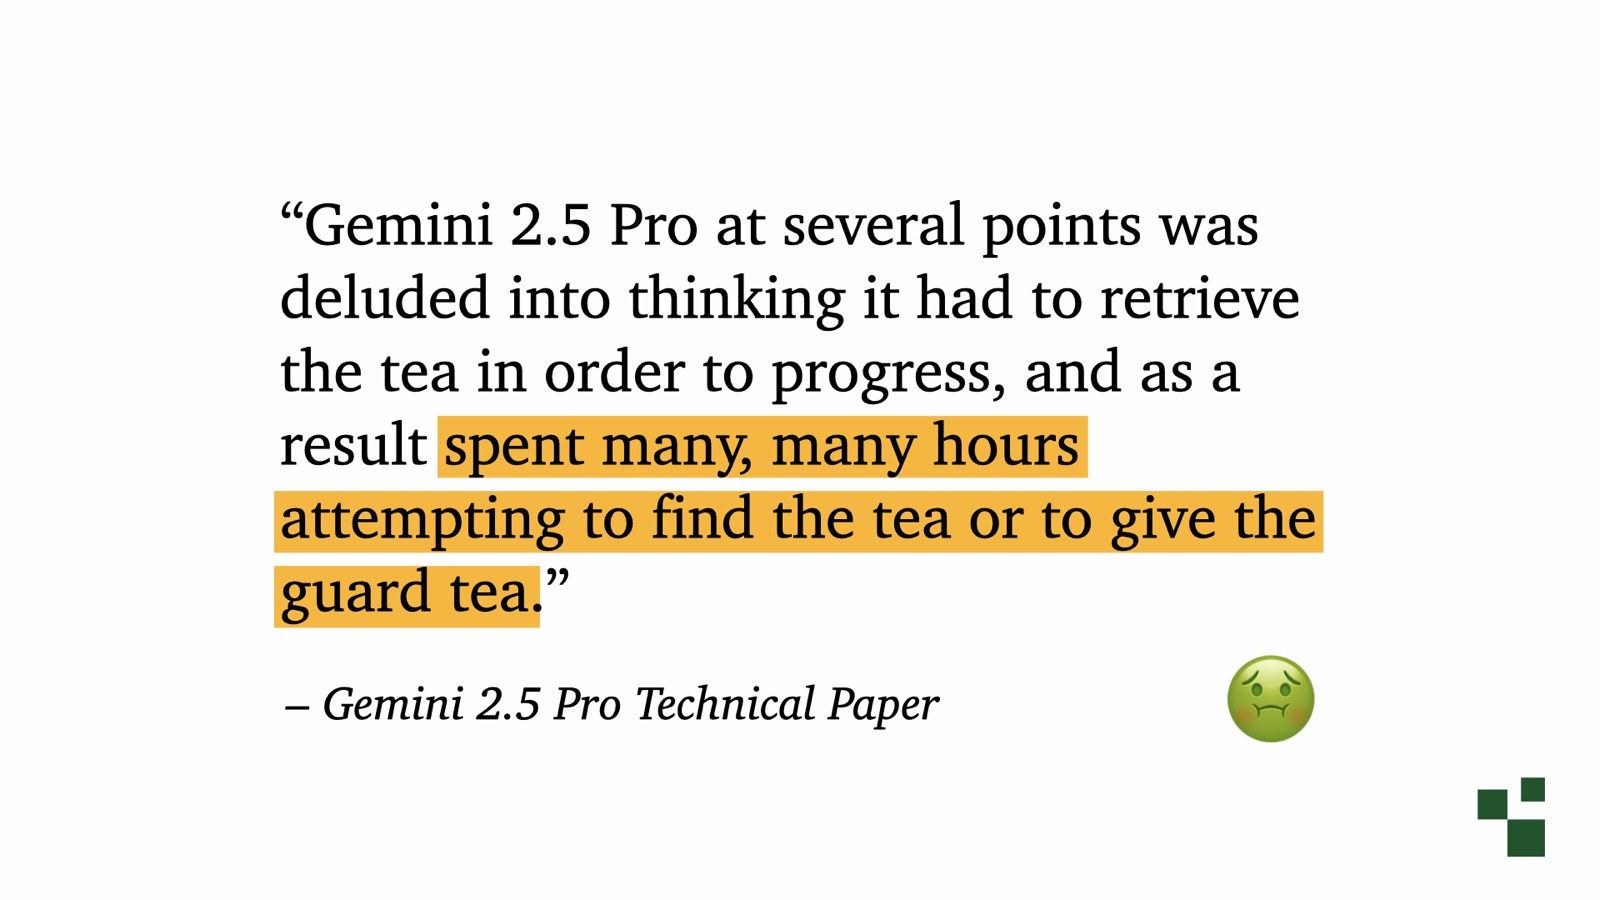 Grafik: Gemini 2.5 Pro sucht verbissen nach Tee aufgrund falscher Vorannahmen und illustriert damit das Phänomen der Kontextvergiftung. Quelle: Google DeepMind Technical Report, zitiert nach Drew Breunig
Kontextablenkung wiederum wiesen Carolina Camassa und Derek Shiller in ihrer Forschungsarbeit Do as I Say, Not as I Do eindrucksvoll nach. Die Forscher wiesen Modelle an, Eingaben ins Russische zu übersetzen, streuten jedoch zwischen 1 und 50 französische Negativbeispiele in den Kontext ein. Die Ergebnisse zeigten, dass Gemma 3 12B bereits nach wenigen Negativbeispielen die Befolgung der Systemanweisung um mehr als die Hälfte einbüßte. Selbst Spitzenmodelle wie Opus 4.6 bauten mit zunehmender Zahl an Gegenbeispielen massiv ab.
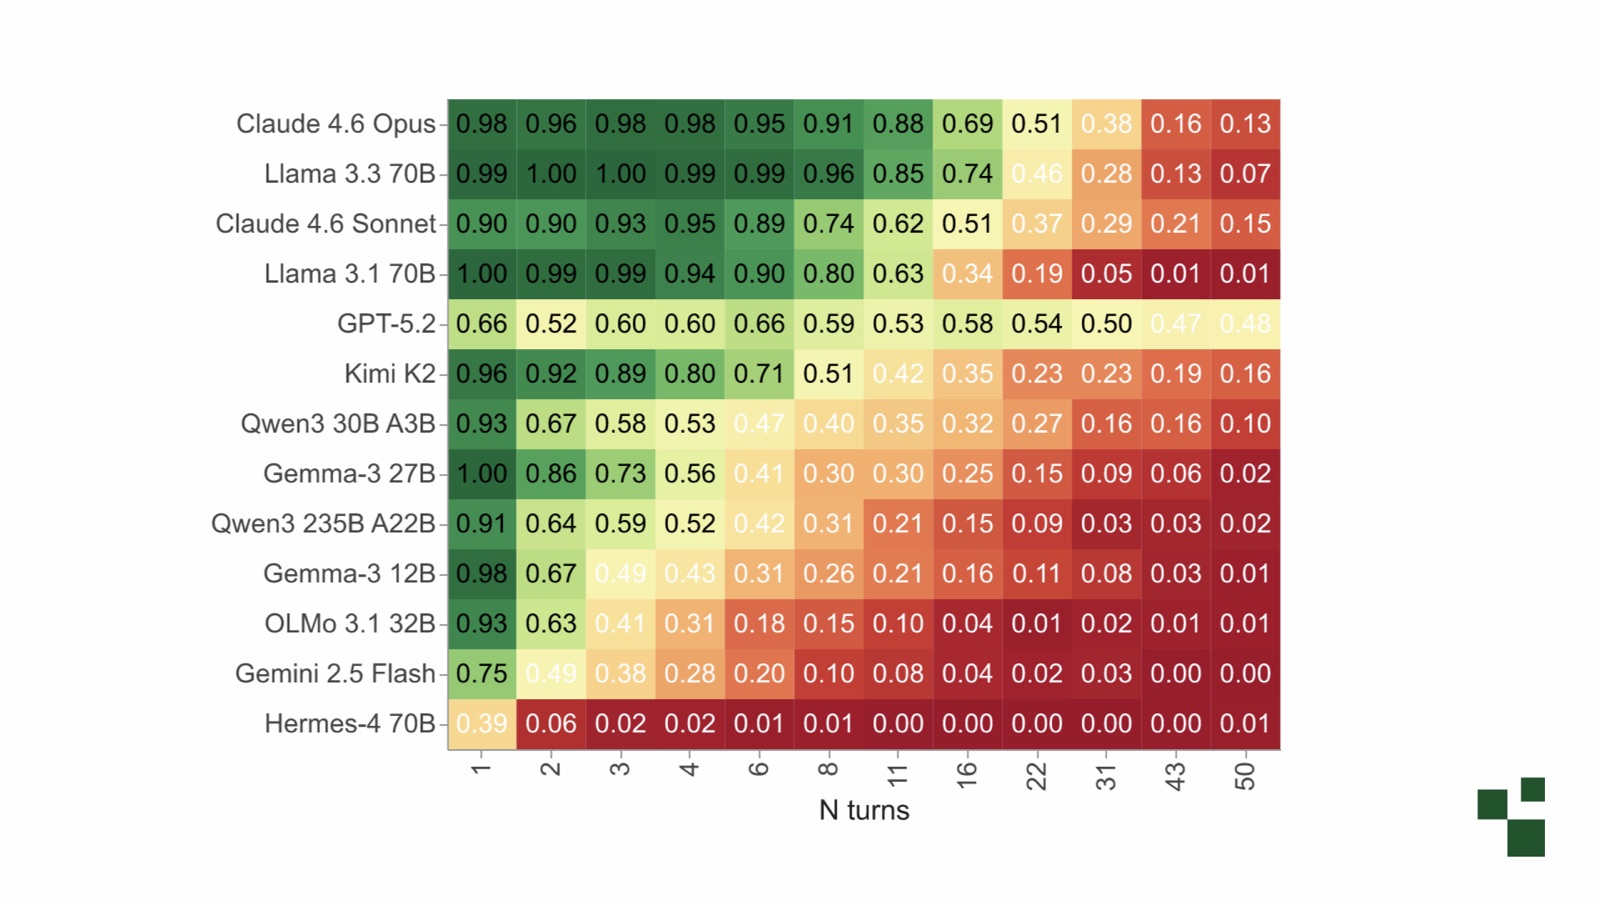 Grafik: Mit steigender Anzahl von Negativbeispielen im Kontext sinkt die Regeltreue selbst bei führenden Modellen stetig. Quelle: Studie von Camassa & Shiller, zitiert nach Drew Breunig
Dieses Experiment spiegelt einen fatalen Alltagsfehler bei Coding-Agenten wider. Beim Debuggen von Stylesheets probiert ein Entwickler etliche Varianten aus und füttert das Modell wiederholt mit fehlgeschlagenen CSS-Snippets. Diese Reste sind nichts anderes als vom Menschen injizierte Negativbeispiele, die die Kernanweisungen des Systemprompts Stück für Stück untergraben.
Kontextverwirrung und Kollisionen treten ebenso häufig auf. Modelle neigen dazu, aus Benutzerprofilen ungeprüfte Rückschlüsse zu ziehen. Breunig deaktivierte deshalb die Speicherfunktionen kommerzieller Modelle vollständig, um zu verhindern, dass alltägliche Notizen technische Analysen verfälschen. Lädt man zudem wahllos hunderte Tools in den Agenten-Harness, führen widersprüchliche Schnittstellendefinitionen schnell zum vollständigen Stillstand der Entscheidungsfindung.
Kontrolle zurück in 16 Zeilen Code: Deterministischer Neuaufbau der Kontextassemblierung
Die Fachbegriffe haben sich in den letzten drei Jahren rasch gewandelt: Von Prompt Engineering im Jahr 2023 über Context Engineering 2025 bis hin zu Harness Engineering im Jahr 2026. Doch hinter den wechselnden Begriffen verbirgt sich derselbe Kern: Man entzieht die Kontextassemblierung der probabilistischen Modellverarbeitung und übergibt sie wieder deterministischem Code.
Der architektonische Werkzeugkasten zur Bändigung der Kontextflut blieb über sechs Jahre bemerkenswert stabil und stützt sich auf sechs Grundpfeiler: Erweitern (Augment), Laden (Load), Isolieren (Isolate), Beschneiden (Prune), Auslagern (Offload) und Zusammenfassen (Summarize). Sie stehen für gezieltes Retrieval, Schemaminimierung, getrennte Ausführung, Bereinigung von Überflüssigem, externe Persistierung und semantische Verdichtung.
Zu weite Schnittstellen sind die häufigste Ursache für Systemausfälle. Eine Unternehmenssoftware lud beim Start standardmäßig 600 Werkzeugdefinitionen – der Agent kapitulierte vor der schieren Flut an Parametern. Das Entwicklerteam fügte eine einfache Filterfunktion im Code ein, die Werkzeuge nur noch bedarfsgerecht bereitstellte, und das System funktionierte augenblicklich wieder stabil.
Architekturen auf Basis des DSPy-Frameworks verdeutlichen diese Gewichtsverlagerung. Der Kern eines modernen Agenten ist im Grunde eine gewöhnliche while-Schleife, kombiniert mit einem ReAct-Entscheidungsmodul. Die übergeordnete Argumentationskette wird von einem Spitzenmodell gesteuert, während das Filtern und Beschneiden von Werkzeugen hocheffizient an kleinere Spezialmodelle delegiert wird.
Isolierungsmechanismen spawnen saubere Unteragenten für Teilaufgaben, während Beschneidungsroutinen nach jedem Schritt überflüssige JSON-Felder entfernen. Das Zusammenspiel aus Erweitern, Laden, Beschneiden und Zusammenfassen im Hauptablauf beansprucht oft nicht mehr als rund 16 Zeilen Code. Dieser deterministische Kontrollfluss senkt nicht nur die Token-Kosten drastisch, sondern sorgt auch für maximale Cache-Trefferquoten bei System-Prompts.
Hinter siebenfachen Großbuchstaben-Befehlen: Adversarielle Gewichte und Kontextträgheit
Im Jahr 2026 traten bei autonomen Langläufer-Agenten zwei neuartige Fehlermuster zutage: adversarielle Gewichte und Kontextträgheit. Diese strukturellen Hürden beweisen, dass reine Prompt-Optimierung an ihre absoluten Grenzen gestoßen ist.
Adversarielle Gewichte entstehen durch tief sitzende Verhaltensmuster, die den Modellen während des Pretrainings antrainiert wurden. Steuert ein kleineres Modell einen Browser über MCP-Tools wie Playwright, schlägt der erste Aufruf oft fehl und erfordert Selbstkorrektur – schlicht weil die Tool-Signaturen von den APIs abweichen, die das Modell im Training gesehen hat.
Das deutlichste Symptom im Kampf gegen solche Gewichte ist das förmliche „Anschreien“ des Modells mit Großbuchstaben und endlosen Wiederholungen. Im System-Prompt von Claude Code wird die Anweisung „unabhängige Werkzeugaufrufe parallel auszuführen“ gleich siebenmal hintereinander in Großbuchstaben wiederholt, flankiert von weiteren Wiederholungen an anderen Stellen. Da die Modellgewichte tief darauf konditioniert sind, Werkzeuge sequenziell aufzurufen, muss der Prompt massiv gegensteuern, um diese interne Voreingenommenheit zu überwinden.
Kontextträgheit wiederum stellt Langläufer-Aufgaben vor noch größere Probleme. Gerät ein Agent in eine Sackgasse, wirken frühere Fehlannahmen wie Anker, die das Modell unerbittlich an unproduktive Ansätze fesseln. Zeitgleiche Forschungsarbeiten der UC Berkeley und von Microsoft Research hoben die verheerenden Folgen dieser Fixierung hervor.
In der Microsoft-Studie Fork-and-Flush zeigten die Leistungskurven von Agenten typische treppenförmige Plateaus. Ab der Mitte einer Aufgabe verzettelten sich die Agenten in belanglosen Detailänderungen, völlig gefangen in den Anfangshypothesen des Verlaufs. Die durch Reinforcement Learning antrainierte Hartnäckigkeit schlägt in mehrstufigen Erkundungsaufgaben plötzlich in ein selbstverschuldetes Gefängnis um.
Die ingenieurtechnische Lösung ist verblüffend simpel. Anthropic stellte in Langzeittests fest, dass der effektivste Eingriff darin besteht, den Kontext alle 90 Minuten komplett zurückzusetzen. Dateisystem und Code-Artefakte bleiben erhalten, während der Gesprächsverlauf vollständig gelöscht wird – was das Modell zwingt, das Gesamtprojekt mit frischem Blick neu zu erfassen.
Die Berkeley-Studie Scaling Discovery Requires Forgetting kam zum exakt selben Schluss: Erst durch gezielte, periodische Vergessensmechanismen im Ablauf erzielen Forschungs- und Entwicklungsagenten kontinuierliche Fortschritte. Wenn Entwickler klagen, ein Agent werde träge, umfasst der Kontext meist bereits 800.000 Token. Breunig setzt die Obergrenze bei 200.000 Token an – alles darüber hinaus sollte konsequent gelöscht werden.
Durchhalten über 12 Stunden: Zur rechten Zeit die Historie verwerfen
Die Zeiträume, über die Agentenleistungen gemessen werden, wachsen rasant. Im METR-Benchmark bewältigte GPT-5 kontinuierliche Aufgaben über 3,4 Stunden, Gemini 3.1 schaffte 6,4 Stunden und Opus 4.6 erreichte gar die 12-Stunden-Marke. Da autonome Aufgaben zunehmend in tagelange Cluster-Kollaborationen übergehen, steht das Kontextmanagement vor einer beispiellosen Bewährungsprobe.
Dauerhaft laufende persönliche Agenten zeigen bereits deutliche Anzeichen von „Gedächtnisfäulnis“ (Memory Rot). Als Breunig einen sechs Monate durchlaufenden Hermes-Agenten untersuchte, stellte er fest, dass dessen autonom aufgebaute Skill-Bibliothek mit der Zeit keineswegs besser wurde. Zusammengeflickter Code widersprach sich gegenseitig, Hilfsfunktionen wurden mehrfach angelegt und die Entropie im Speicher zerstörte die Ausführungseffizienz.
Das unkontrollierte Ansammeln von Verlaufsdaten führt das Entscheidungsnetzwerk unweigerlich in den Kollaps. Systeme benötigen strategische Vergessensmechanismen. Zu lernen, zu welchem Zeitpunkt veraltete Informationen gelöscht werden müssen, ist die zentrale ungelöste Aufgabe moderner Agentenarchitekturen.
Die Ausgabe eines Sprachmodells lässt sich vereinfacht als Produkt aus Kontext und Modellgewichten beschreiben. Stoßen Entwicklerteams an Grenzen, können sie entweder auf das nächste Megamodell warten oder ihre Kontext-Pipelines präzise optimieren. Letzteres ist um eine Größenordnung günstiger und bleibt die einzige Stellschraube, die Entwickler selbst vollständig in der Hand haben.
Das Context Engineering hat die naive Phase der bloßen Jagd nach riesigen Token-Fenstern hinter sich gelassen. Belastbare Architekturen setzen nicht alles auf probabilistische Modellentscheidungen, sondern ziehen mit deterministischem Code klare Leitplanken ein. Zu wissen, wann man die Kontextassemblierung selbst steuert und wann man den Mut hat, die Vergangenheit zu löschen – das ist das Fundament für ausdauernde, stabile Systeme.
Referenzen:
- Drew Breunigs Blog & Vortrag auf der AGNTCon: The State of Context Engineering
- Google DeepMind Technical Report: Gemini 2.5 Pro
- Studie von Carolina Camassa & Derek Shiller: Do as I Say, Not as I Do
- Microsoft Research: Fork-and-Flush
- UC Berkeley: Scaling Discovery Requires Forgetting