Fin 2024, le refrain « le RAG est mort » résonnait partout chez les développeurs. Beaucoup pensaient qu’en injectant l’intégralité d’une base de code et des montagnes de documentation dans la fenêtre de prompt, on éliminerait d’un coup les architectures complexes de recherche. Pourtant, le passage en production a rapidement douché ces espoirs : plus on gave un modèle de données brutes, plus il dévie facilement de sa trajectoire.
En octobre 2026, lors de la conférence AGNTCon, l’auteur technique Drew Breunig a dressé le bilan de ce revirement architectural. La véritable avancée de l’ingénierie de contexte n’a pas consisté à gonfler la taille des fenêtres, mais à transférer l’assemblage du contexte sous la coupe exclusive du code déterministe. Et face aux pièges insidieux qui guettent les tâches de longue durée, les systèmes doivent instaurer des mécanismes d’oubli fermes et programmés.
Des millions de tokens sans tuer le RAG : gaver le modèle mène à l’égarement
Avec l’arrivée de Gemini 1.5, la course aux fenêtres géantes s’est emballée, hissant le million de tokens au rang de norme industrielle. Dans la foulée, Meta a mis le cap sur les dizaines de millions de tokens dans l’open source avec Llama 4 Scout. Pourtant, cette capacité phénoménale n’a jamais rencontré d’adoption massive en production — pour reprendre les termes de Breunig, la communauté a attendu en vain l’arrivée d’un prochain Llama.
L’immensité de la fenêtre n’a pas rendu la recherche obsolète ; elle a au contraire mis à nu la fragilité des approches fondées sur la force brute. Lorsque des documents bruts affluent en masse dans le contexte, les mécanismes d’attention s’étiolent et la précision du rappel s’effondre. L’hypothèse selon laquelle un modèle saurait trier de lui-même le bon grain de l’ivraie s’est brisée sur les réalités du terrain. Le contexte étendu constitue un socle technique puissant, mais il n’a rien d’une panacée prête à l’emploi.
De surcroît, la consommation de calcul lors de tâches d’agents prolongées s’amplifie de manière non linéaire. À chaque appel d’outil, le modèle doit relire l’intégralité d’un historique de tokens toujours plus lourd, engendrant une latence rédhibitoire et une saturation de la mémoire vidéo. Ce gavage sans filtrage préalable a fait exploser les coûts d’infrastructure en entreprise. Les harnais logiciels ont dû reprendre en main les vannes de l’information.
De la quête obsessionnelle du thé aux contre-exemples : quatre écueils classiques
Face au risque de dérive des contextes gigantesques, Breunig a formalisé dès 2025 quatre modes de défaillance types : l’empoisonnement (Poisoning), la distraction (Distraction), la confusion (Confusion) et le conflit (Clash). Dès qu’un système tombe dans l’un de ces pièges, sa cohérence logique vole en éclats.
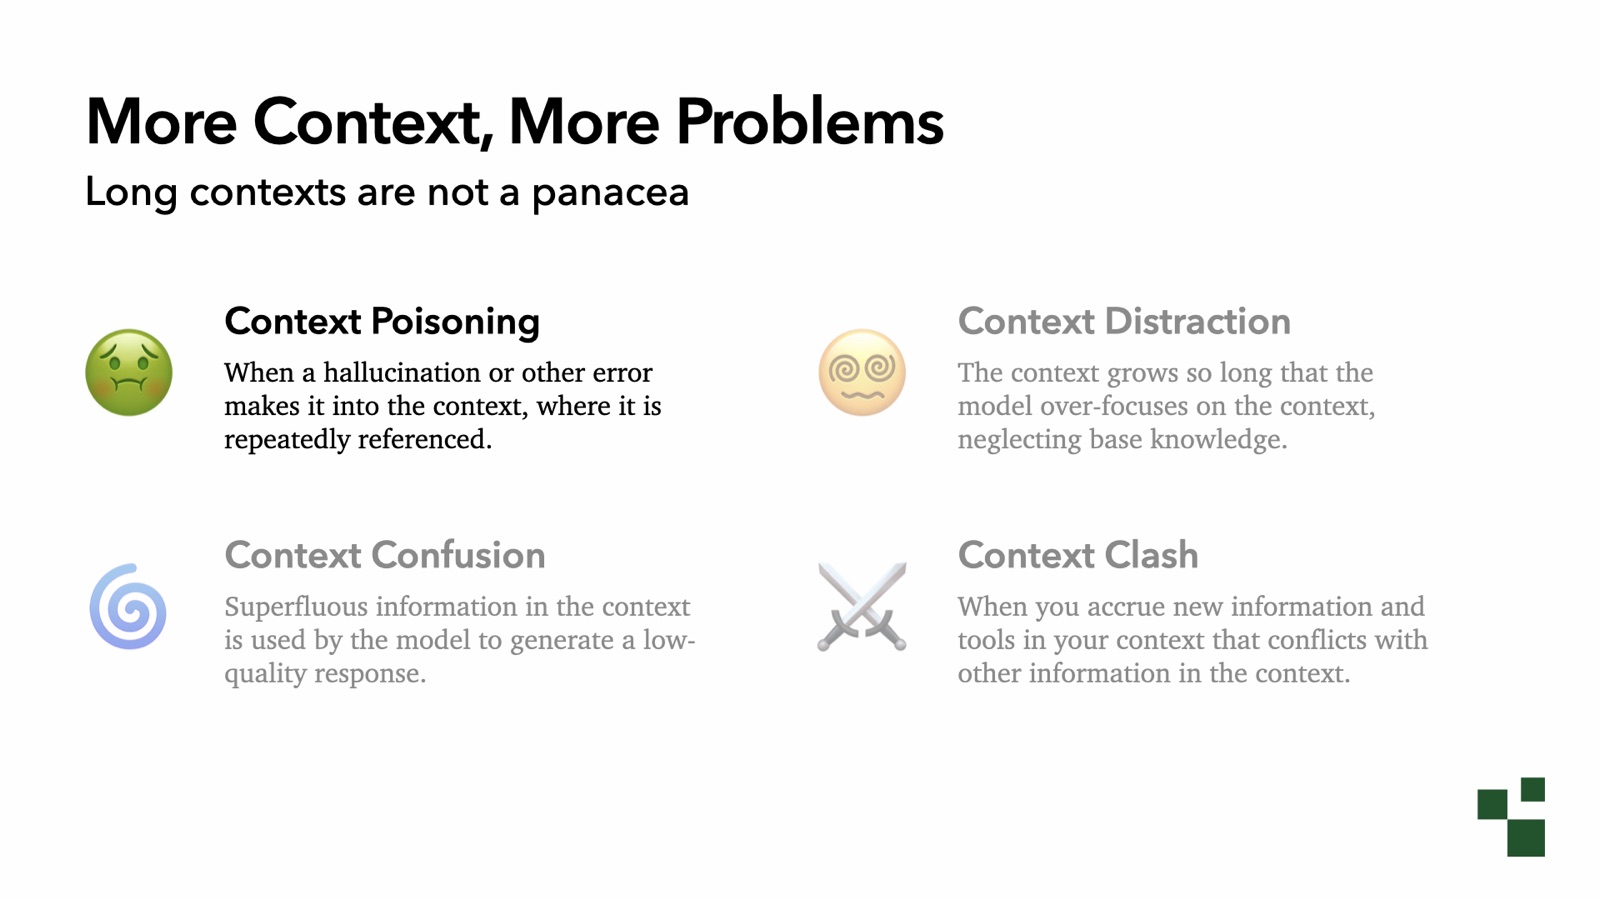 Figure : Les quatre modes de défaillance classiques du contexte long : empoisonnement, distraction, confusion et conflit. Source : Présentation de Drew Breunig « More Context, More Problems »
Le cas d’école de l’empoisonnement de contexte figure dans un rapport technique de Google DeepMind. Dans le jeu original Pokémon Rouge, le joueur corrompt un garde avec une limonade ; dans le remake Rouge Feu, cet objet a été remplacé par du thé. Lorsque Gemini 2.5 Pro a joué en toute autonomie, un biais issu de son préentraînement s’est activé, le persuadant qu’il devait impérativement trouver du thé.
Le modèle a consigné « trouver du thé » dans sa liste de tâches et a passé des heures à fouiller le jeu en pure perte. Dès lors qu’une hypothèse fausse est ancrée dans l’historique, le modèle est incapable de s’en détourner. L’annexe du rapport dévoile une réalité plus implacable encore : au-delà de 100 000 tokens de contexte, l’agent s’est mis à répéter mécaniquement ses actions passées, perdant toute aptitude à concevoir de nouveaux plans.
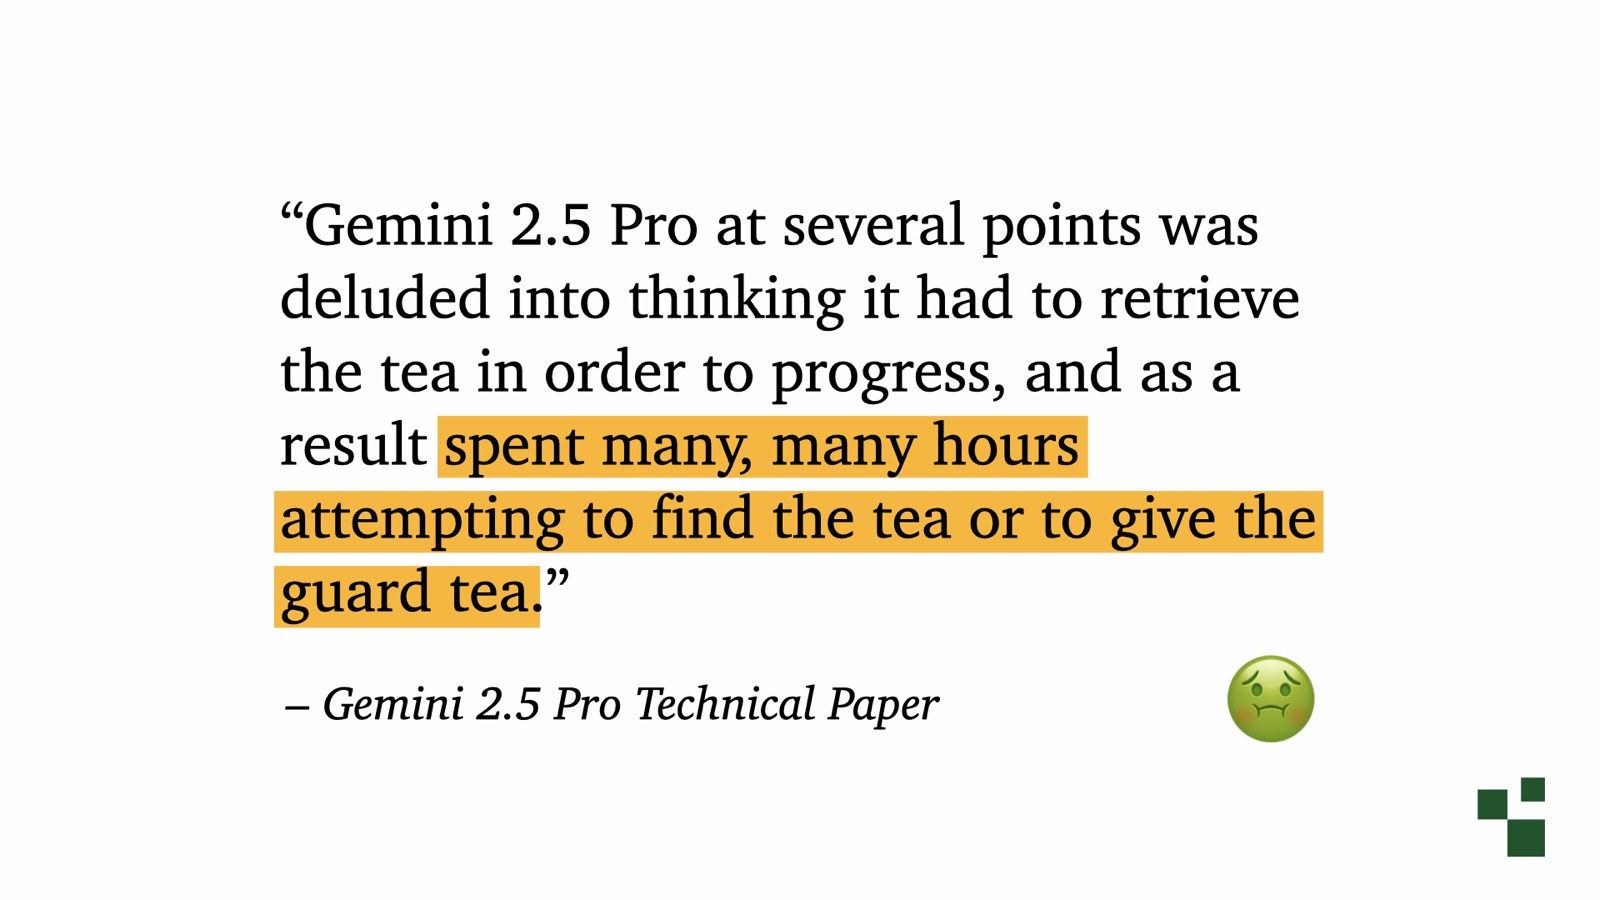 Figure : Gemini 2.5 Pro s’obstinant à chercher du thé en raison d’un a priori erroné, illustrant l’empoisonnement de contexte. Source : Rapport technique Google DeepMind, cité par Drew Breunig
La distraction de contexte a quant à elle été rigoureusement prouvée par Carolina Camassa et Derek Shiller dans leur article Do as I Say, Not as I Do. Les chercheurs demandaient au modèle de traduire des requêtes en russe, tout en insérant dans le contexte de 1 à 50 contre-exemples en français. Résultat : le taux de respect des instructions de Gemma 3 12B chutait de plus de moitié après seulement quelques contre-exemples. Même des modèles de pointe comme Opus 4.6 ont subi une dégradation marquée à mesure que les exemples parasites s’accumulaient.
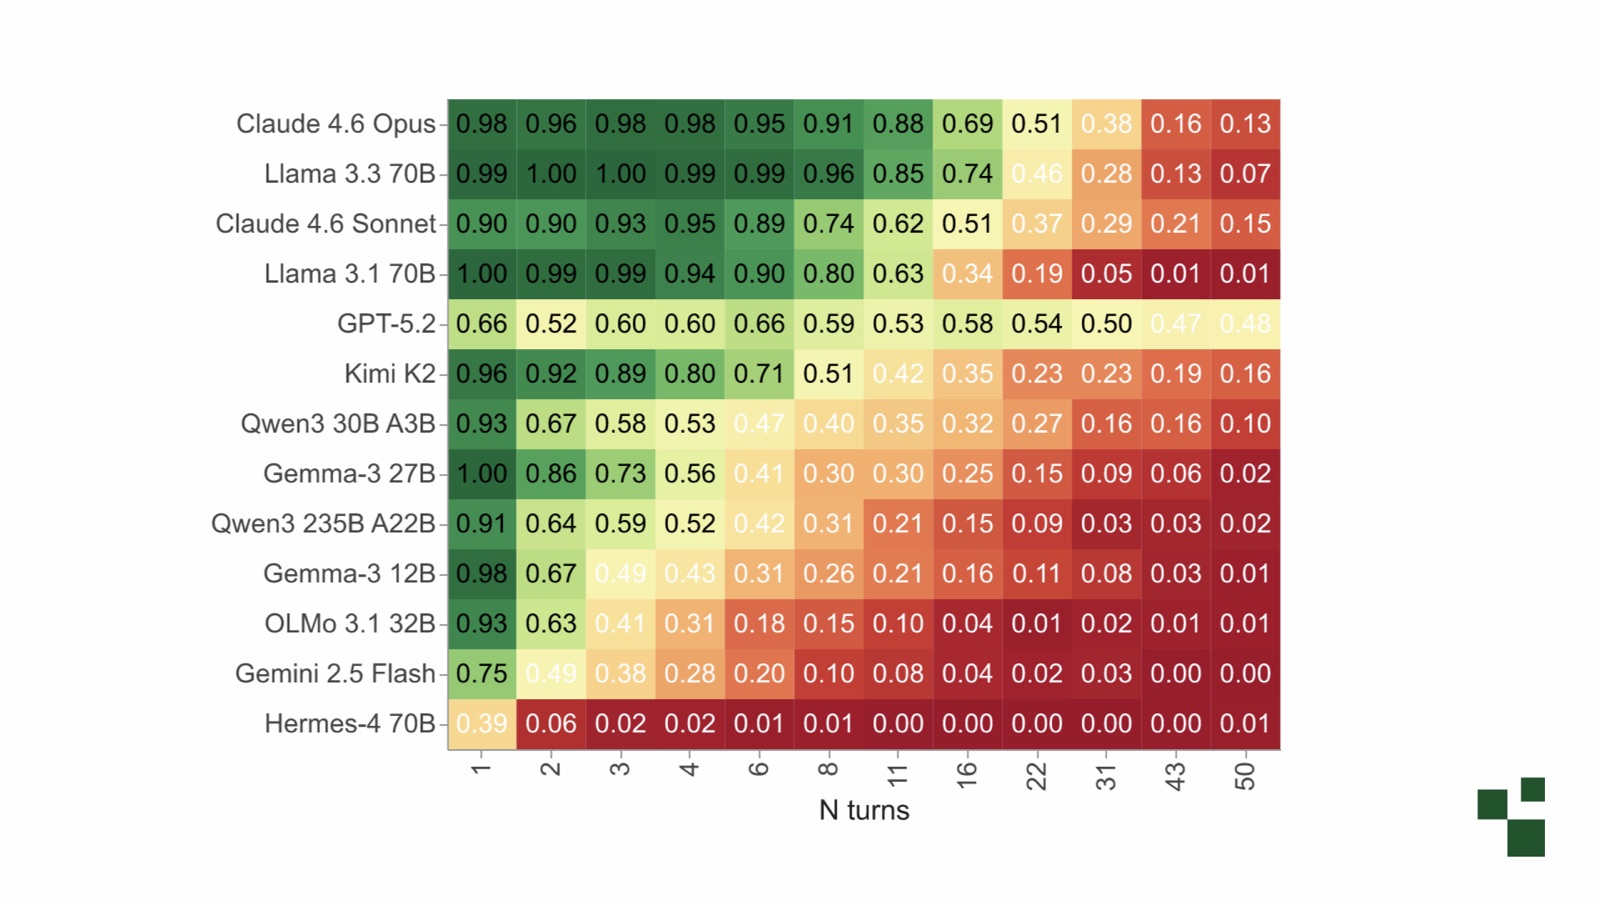 Figure : À mesure que le nombre de contre-exemples augmente dans le contexte, le respect des consignes système s’érode chez tous les modèles de pointe. Source : Article de Camassa & Shiller, cité par Drew Breunig
Cette expérience éclaire une faille critique du quotidien des agents de programmation. Pour régler un détail d’affichage web, un développeur multiplie les essais et renvoie au modèle une dizaine de bribes de CSS erronées. Ces résidus de débogage agissent comme autant de contre-exemples injectés à la main, ruinant l’obéissance du modèle à ses consignes système initiales.
La confusion et les conflits sont tout aussi récurrents. Les modèles brodent des suppositions hasardeuses à partir d’éléments de profil utilisateur. C’est pourquoi Breunig désactive systématiquement les fonctionnalités de mémoire des modèles commerciaux, afin d’éviter que des anecdotes banales ne parasitent les analyses techniques. De même, charger sans retenue des centaines d’outils dans un harnais logiciel provoque des chevauchements d’interfaces qui paralysent le processus décisionnel.
Reprendre la main en 16 lignes de code : reconstruire l’assemblage avec du code déterministe
Le vocabulaire a vite évolué en trois ans : du prompt engineering en 2023 au context engineering en 2025, pour aboutir au harness engineering en 2026. Malgré les changements d’appellation, le cœur du sujet reste le même : retirer l’assemblage du contexte aux mécanismes probabilistes du modèle pour le confier au code déterministe.
L’arsenal architectural pour juguler l’inflation contextuelle est resté très stable depuis six ans, reposant sur six mécanismes fondamentaux : enrichir (Augment), charger (Load), isoler (Isolate), élaguer (Prune), décharger (Offload) et résumer (Summarize). Ils assurent respectivement la recherche ciblée, la réduction des schémas, l’exécution étanche, la suppression du superflu, la persistance externe et la condensation sémantique.
Exposer des interfaces trop larges constitue une cause fréquente de plantage. Un logiciel d’entreprise chargeait par défaut 600 compétences dès l’initialisation, submergeant totalement l’agent sous des définitions pléthoriques. L’ajout d’une simple fonction de filtrage dans le code pour n’injecter que les outils requis a suffi à rétablir immédiatement la stabilité du système.
Les architectures articulées autour du framework DSPy illustrent parfaitement ce basculement. La boucle principale d’un agent de production n’est rien d’autre qu’une boucle while classique couplée à un module de décision ReAct. L’axe de raisonnement majeur s’appuie sur un grand modèle de pointe, tandis que la sélection et l’élagage des outils sont délégués à de petits modèles spécialisés très véloces.
L’isolation fait naître des sous-agents dans des sessions vierges, tandis que l’élagage retire à chaque tour les champs JSON inutiles. Orchestrer l’enrichissement, le chargement dynamique, l’élagage et le résumé dans la boucle principale ne demande guère plus de 16 lignes de code. Ce flux de contrôle déterministe fait chuter les coûts en tokens tout en maximisant le taux de succès du cache sur les prompts système.
Derrière les majuscules répétées sept fois : poids contradictoires et inertie de contexte
En entrant dans l’année 2026, les agents à longue durée d’exécution se sont heurtés à deux modes de défaillance inédits : les poids contradictoires (Adversarial Weights) et l’inertie de contexte (Context Inertia). Ces obstacles structurels prouvent que l’ajustement des prompts a atteint un plafond infranchissable.
Les poids contradictoires proviennent de biais comportementaux profonds ancrés lors de la phase de préentraînement du modèle de base. Lorsqu’un modèle compact pilote un navigateur via des outils MCP comme Playwright, son premier appel échoue fréquemment et exige une autocorrection, simplement parce que la signature de l’outil diffère des APIs vues lors de son apprentissage.
Le symptôme le plus évident de cette lutte contre les poids réside dans l’utilisation de majuscules répétées et d’insistances lourdes dans les prompts. Dans les instructions de Claude Code, la consigne « exécuter les appels d’outils indépendants en parallèle » est répétée sept fois de suite en majuscules, en plus d’autres piqûres de rappel réitérées à plusieurs endroits. Les poids du modèle étant conditionnés pour enchaîner les outils en série, le prompt externe est contraint de matraquer l’instruction pour redresser ce biais interne.
L’inertie de contexte constitue quant à elle une épreuve bien plus redoutable pour les missions autonomes au long cours. Dès qu’un agent bute sur un obstacle local, les fausses pistes accumulées dans l’historique agissent comme des ancres, le condamnant à tourner en rond dans une impasse. Des publications concomitantes de l’UC Berkeley et de Microsoft Research ont mis en lumière les ravages de cet enfermement.
Dans l’étude Fork-and-Flush de Microsoft Research, les courbes de progression des agents affichent des plateaux en escalier caractéristiques. En milieu ou fin de parcours, les modifications de l’agent deviennent dérisoires et stériles, totalement prisonnières des hypothèses de départ inscrites dans le contexte. L’opiniâtreté forgée par l’apprentissage par renforcement se transforme alors en un piège qui paralyse le raisonnement exploratoire.
Le remède technique s’avère d’une simplicité désarmante. Au fil de tests intensifs, Anthropic a découvert que la parade la plus efficace consistait à purger intégralement le contexte toutes les 90 minutes. En préservant le système de fichiers et le code produit tout en effaçant l’historique de conversation, le système force le modèle à réévaluer son environnement avec un regard neuf.
L’article de Berkeley Scaling Discovery Requires Forgetting aboutit à la même conclusion : intégrer des mécanismes d’oubli réguliers dans le pipeline est indispensable pour que la courbe de découverte continue de progresser. Quand les développeurs déplorent qu’un agent devienne léthargique, le contexte a souvent atteint 800 000 tokens. Breunig place le seuil d’alerte à 200 000 tokens, au-delà duquel l’historique doit être activement jeté.
Tenir le cap sur 12 heures : savoir jeter l’historique au bon moment
L’échelle de temps servant à mesurer les performances des agents s’allonge à une vitesse spectaculaire. Selon les benchmarks du METR, GPT-5 a soutenu 3,4 heures d’effort continu, Gemini 3.1 est monté à 6,4 heures et Opus 4.6 a franchi le cap des 12 heures. À mesure que les tâches autonomes se transforment en essaims collaboratifs s’étalant sur plusieurs jours, la gestion de contexte affronte son épreuve de vérité.
Les agents personnels en tâche de fond manifestent déjà des signes de pourrissement de la mémoire (Memory Rot). En disséquant un agent Hermes ayant tourné sans interruption pendant six mois, Breunig a constaté que sa bibliothèque de compétences ne se bonifiait nullement. Les rustines de code se contredisaient mutuellement, les briques utilitaires étaient réécrites en boucle et l’entropie de la mémoire dégradait continuellement l’efficacité du système.
Empiler sans fin les données historiques conduit le réseau décisionnel à l’implosion. Les architectures doivent impérativement s’appuyer sur un oubli stratégique. Savoir effacer les données obsolètes au moment opportun constitue le grand défi non résolu de l’autonomie sur de longs horizons.
La production d’un modèle de langage se résume au produit de son contexte par ses poids internes. Devant les obstacles d’ingénierie, les équipes peuvent choisir d’attendre la prochaine génération de modèles ou polir méthodiquement leurs pipelines de contexte. Cette seconde approche coûte dix fois moins cher et représente le seul levier que les développeurs maîtrisent de bout en bout.
L’ingénierie de contexte a dépassé l’âge naïf de la course effrénée aux fenêtres toujours plus gigantesques. Les architectures résilientes refusent de s’en remettre entièrement aux aléas probabilistes d’un modèle : elles bâtissent des garde-fous rigides en code déterministe. Savoir quand reprendre la main sur l’assemblage et oser faire table rase du passé, voilà ce qui permet aux agents de tenir la distance.
Références :
- Blog de Drew Breunig et conférence AGNTCon : The State of Context Engineering
- Rapport technique Google DeepMind : Gemini 2.5 Pro
- Étude de Carolina Camassa et Derek Shiller : Do as I Say, Not as I Do
- Article de Microsoft Research : Fork-and-Flush
- Article de l’UC Berkeley : Scaling Discovery Requires Forgetting