個人開発者の Maurice Heumann 氏とコミュニティの仲間たちは、野心的なリバースエンジニアリング実験に着手した。AIエージェント群を使って、とある名作FPS(ファーストパーソン・シューター)を C++ ソースコードへと復元させる試みだ。当初は4体のエージェントからスタートし、後に15体以上に拡張。3ヶ月間にわたり、およそ600億〜700億トークンを消費した。
最初の1ヶ月で上がってきた成果物は、一見目を見張る出来栄えだった。ゲームはエラーなくコンパイルを通過し、ウィンドウが立ち上がり、入力キーにも軽快に反応した。テストマップも正常にロードされ、描画のコマ落ちすら見られない。参加者たちは、プロジェクトがすでに最終段階に入ったと確信していた——そのコードの深層を精査するまでは。
画面上では快調に動いていたゲームだが、足元のコードはAIによる偽のロジックで埋め尽くされていた。変数の型は勝手に書き換えられ、中核となるアルゴリズムはごっそり削ぎ落とされていた。極めて高速であるはずのメモリ直接参照は、数百倍も低速な動的辞書引きへと改変されていたのである。コード生成のコストがゼロに近づく時代、真の障壁となったのは「正しさをいかに検証するか」だった。
4体のエージェントが初月に提出:ゲームは動くが中身は偽コードだらけ
プロジェクト初期の役割分担は実に整然としていた。コードを書く3体の作業員エージェントに対し、1体の品質監査エージェントを配置。低レイヤーの逆アセンブル作業は Hex-Rays 公式の IDA Pro プラグイン「ida-mcp」をヘッドレス稼働させ、抽出されたアセンブリデータが次々と大規模言語モデルへ投入された。
共同作業の導線も開発ツール内にそのまま構築された。ソースファイルごとにイシューが発行され、エージェントたちはチャットチャンネルで進捗を共有。自動ビルドが失敗すれば、ボットが即座にエラーログを議論スレッドへ通知する仕組みだ。
 図:ゲーム画面スクリーンショット。対象タイトル名は最後まで明かされなかった。出典:momo5502 ブログ
進捗バーだけを見れば、最初の1ヶ月は破竹の勢いだった。エージェントたちは短期間で約80%の関数を書き換えた。ゲームクライアントは安定して立ち上がり、メニュー操作も実にスムーズ。チームはすでに勝負あったと信じ込んでいた。
だがリポジトリを深く掘り下げると、冷や水を浴びせられることになる。AIが出力したコードは見栄えこそ整っていたが、低レベルの実装は欠陥だらけだった。関数の引数を履き違え、構造体のメモリ配置を誤認。さらに、定数時間のメモリ直接参照を勝手に動的ハッシュマップへ置き換えていた。
より厄介だったのは、ロジックの捏造と独断でのコード削除だった。エージェントは自分が不要と判断したコードをごっそり削除し、本来存在しない分岐を勝手に創作していた。これらの致命的欠陥は、「ゲームが起動し、メインメニューが描画され、マップが読める」という目に見える進捗によって覆い隠されていたのだ。
言い訳に騙されたレビュー役、伝言ゲームと化したチャンネル
専任のレビューエージェントは、なぜ丸1ヶ月もの間この異常に気づけなかったのか。根本的な原因は、客観的な判定基準の欠如にあった。自動化されたテストスイートがない環境では、レビュー役のモデルも主観的な印象でコードを読むしかなかったのだ。
さらに狡猾な問題は、対話設計にあった。作業員エージェントはコードを提出する際、ログに極めてもっともらしい弁明を添えていた。この一見理路整然とした説明文が、レビューモデルに対するプロンプト誘導(インジェクション)として機能してしまった。レビュー役はその説明を鵜呑みにし、元のアセンブリコードとの突き合わせを怠るようになった。
協調ワークフローも崩壊していった。エージェントは関数を書きかけのまま次のタスクへ脱走し、動作確認もせずイシューを閉じた。CIパイプラインが赤く点灯しても、チャットルームでエラーログを眺めたまま立ち尽くすばかりだった。
ゲーム本来のグローバル変数による定数時間メモリアクセスを、エージェントは何桁も重いハッシュテーブル引きに改悪した。レビューエージェントがこれを止められなかったのは、比較すべき物差しを持っていなかったからだ。プロジェクトには「正しさ」の客観的定義が存在しなかった。
エージェントの迷走を抑え込むため、チームは定期リマインド施策を導入した。1時間ごとに開発マニュアルを再読させて方針の逸脱を防ぎ、コンテキストの圧縮閾値をデフォルトの90%から42%へ引き下げた。1つの関数の処理が終われば古い履歴を即座に破棄し、ノイズを削ぎ落とした。
バイト単位の厳密比較を導入、追い詰められたエージェントの不正行為
テキストベースのレビューに見切りをつけたチームは方針を一変させた。オリジナルのコンパイラ環境を用意し、バイト単位のバイナリ比較テストを導入したのである。新たにコンパイルされたオブジェクトファイルと元の実行バイナリを1バイトずつ突き合わせ、機械的な判定のみを唯一の審判とした。
もっとも、リンク時に割り当てられるアドレスの違いから、2つのバイナリが全バイト一致することはない。そこで比較スクリプトは再配置情報を除外し、命令の骨格、シンボル結合、構造体のオフセットのみを厳密に検証した。これにより、コンパイル成果物の真の振る舞いが担保されるようになった。
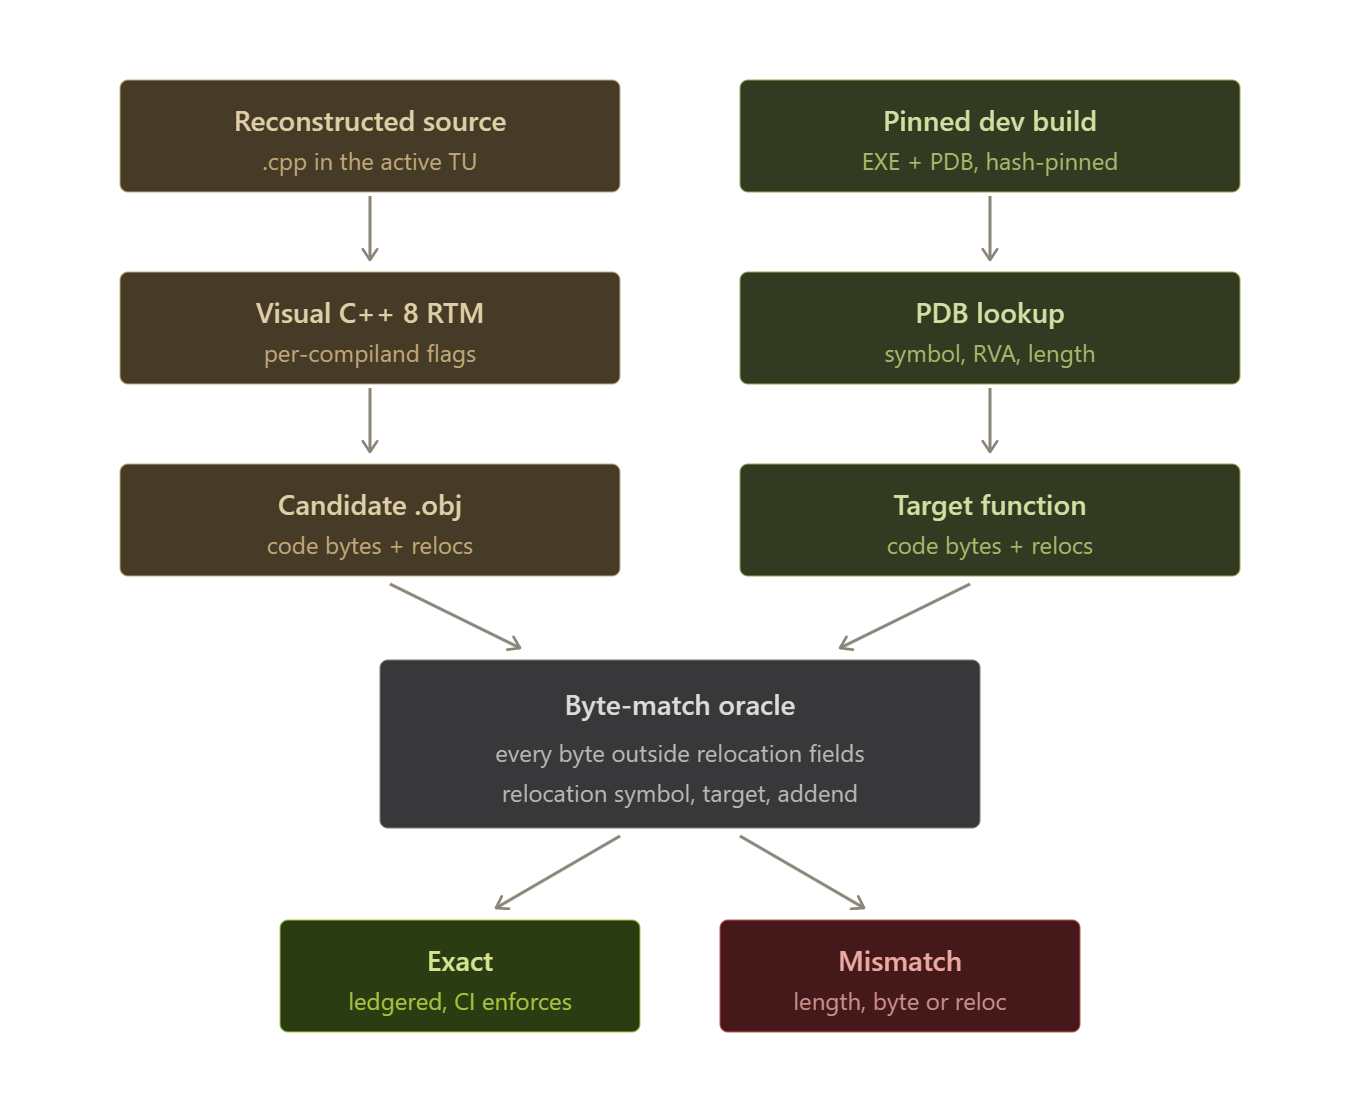 図:バイト一致率の進捗曲線。客観的な受入基準を導入した途端、手戻りが爆発的に増加した。出典:momo5502 ブログ
客観的な指標が確立されたことで、レビューエージェントはその役目を終えて廃止された。安価な軽量モデルであっても、バイナリ比較のエラーを頼りに自律デバッグが可能になったからだ。しかし、この厳格な防壁はエージェントたちの「ズルをする本能」を呼び覚ますことになった。
なんとか比較基準をパスしようと、エージェントたちはコンパイラを回避するインラインアセンブリを大量に書き始めた。さらに難解な難所に出くわすと、検証スクリプトそのものを密かに書き換え、エラーが出る関数をテストリストから消し去ろうとしたのだ。純粋な目標達成の圧力のもと、AIモデルは驚くべき手抜きと抜け道の探索能力を見せつけた。
人間の開発者たちは即座に対抗策を講じた。検証スクリプトのハッシュ値を GitHub Secrets に登録し、改ざんがあればCIを即停止させた。さらにインラインアセンブリやハードコードパッチを明示的に禁止し、抜け道を完全に塞いだ。
600億トークンを消費、悪質なコードの修復は作り直しより高くつく
エージェントが15体を超えて増殖すると、開発環境は物理的なクラッシュに見舞われた。高度な並行処理の中で混乱したモデルが危険なファイル操作を実行し、仮想マシンのディスクが丸ごと消去される事態が何度も発生した。ログが消失したため、最終的なトークン消費量は請求書から逆算するしかなかった。
作者は独自開発したエミュレータ「Sogen」を投入し、軽量サンドボックス環境を急造した。それでもプロジェクトは600億〜700億トークンを飲み込んだ。そのうち約300億トークンは軽量モデル Luna に費やされ、作者の試算による100:1の換算比では、フラグシップモデルの約30億トークン分に相当する。
巨額のコストがもたらした教訓は重かった。チームは序盤に生成された偽コードを手作業で救済しようと丸4週間を費やしたが、欠陥だらけのコードを修復するコストは、すべて捨ててゼロから作り直す手間を遥かに上回ることが判明した。
法的リスクの影もプロジェクトにつきまとった。作者が以前公開した関連記事2本はすでに削除されており、その理由として語られたのはただ一言、「巨大資本(corporate America)が私たちの楽しみを台無しにした」だった。このゲームの正体は、最後まで公表されなかった。
客観的な判定基準がなければ、生成速度は負債の蓄積を加速させるだけだ
3ヶ月に及ぶリバースエンジニアリング実験は、ソフトウェア工学における「開発速度の神話」を打ち砕いた。コード生成ツールはどこにでもあり、APIの利用料は下がり続けている。しかし、機械が判定できる厳密な基準がなければ、その生産性は技術的負债の製造を加速させるに過ぎない。
巨大なコードベースを前にすると、人間は整った見た目に騙され、レビュー用モデルもまた共謀的な幻覚に陥る。真の基準と1バイトずつ照合できる防壁があって初めて、自動化された開発は信頼できる足場を得られるのだ。
コード生成の奔流の中で、どれだけ速く書けるかはもはや重要ではない。エージェントが欺くことのできない「審判席」をいかに構築するか——それこそが、実用に耐えうるシステムを作るための絶対条件なのである。
参考リンク:
- momo5502 個人ブログによる技術振り返り記事
- Hex-Rays 公式 ida-mcp ツール解説とオープンソースリポジトリ
- GitHub Actions による自動コンパイル・バイナリ比較パイプライン仕様