2026 年 9 月 16 日,美国联邦第九巡回上诉法院公布了一起关键判决。法院维持驳回了程序员针对 GitHub Copilot 的版权诉讼。法官给出的裁决理由很直白。AI 生成的代码属于「从未包含版权信息的新作品」。既然原本就没有署名,也就不存在抹去作者信息的侵权行为。
这个逻辑迅速在开发者群体中引发了震动。几十年间,人类程序员在开源社区写下了数以亿计的代码行。如今模型消化重组了这些代码。吐出的结果在法律上却成了白纸。商业公司免除了开源署名义务。转头把这些代码作为付费资产销售。一边甩开开源义务,一边独占商业利益。这种双重标准构成了当前争论的核心冲突。
抄袭者用模型洗代码,作者告不赢
现实中的版权纠纷已经演变成荒诞的技术对抗。一位开源作者坚持使用 AGPL 协议。他发现自己的项目被商业公司全盘抄袭。在连续发出多轮侵权通知后,对方既不下架软件,也不公开源码。这家公司把全部代码塞进大模型。他们要求 AI 将所有函数重写一遍。
重写后的程序换了变量名。但底层架构与业务逻辑分毫不差。原作者在社区发出感叹。这就像用模型重写《哈利波特》,情节原封不动,只改了对话词句。代码文本改变之后,传统的字面对比手段很难证明抄袭。侵权方凭借模型生成的新外壳,轻松绕开了开源协议的约束。
这种情况并非个例。开发者 Jakub Jankiewicz 发布了一篇博文。他明确主张:所有 AI 生成的代码都应当强制开源。他列出的首要依据是语料来源。开源社区贡献了海量基础代码。模型的代码能力直接建立在人类几十年的无偿奉献之上。
Stack Overflow 上的海量问答同样被收入语料。这些内容原本遵循署名许可,明确要求下游使用必须标注出处。商业模型将人类共享知识转化为专有软件,本质上是在进行许可清洗。 这种做法切断了知识回馈的链条,开源作者自然感到权益受损。
过滤 150 个字符,反而留下逐字搬运证据
第九巡回上诉法院的 Doe v. GitHub 案因此成为关键焦点。Miller 法官在判决书中确认了一项进展:原告程序员具备诉讼资格。这项认定确立了维权前提。开发者有权向司法体系讨要说法,不必在诉讼立案门槛上被直接淘汰。
但在核心认定上,法官驳回了原告的主张。原告依据的是 DMCA 第 1202(b) 条。该条款专门惩罚移除或篡改版权管理信息的行为。它的单次违规赔偿在 2,500 至 25,000 美元之间。相比之下,传统版权侵权对整件作品的法定赔偿上限只有 30,000 美元。
原告律师原本希望借助巨额赔偿施压。但法院认定,模型吐出的代码片段属于新生成的内容。这些片段在诞生时就没有附带署名。既然原本就不存在署名,也就不符合「移除或篡改版权信息」的要件。原告在上诉中放弃了训练端侵权指控。法院因此没有裁定抓取数据是否合法。
诉讼还揭示了一个技术细节。GitHub 为证明自己合规,专门上线了重复代码过滤机制。只要输出与公开代码仓库连续重合超过 150 个字符,系统就会拦截。150 个字符的阈值本身就是一份工程证据。它直接坐实了大模型确实会逐字搬运训练集中的原始代码。
猴子按快门拿不到版权,机器也不能
如果判例认定机器吐出的是新作品,那么新作品的版权归谁?美国现行版权法给出了答案:纯机器生成的产物没有任何版权。
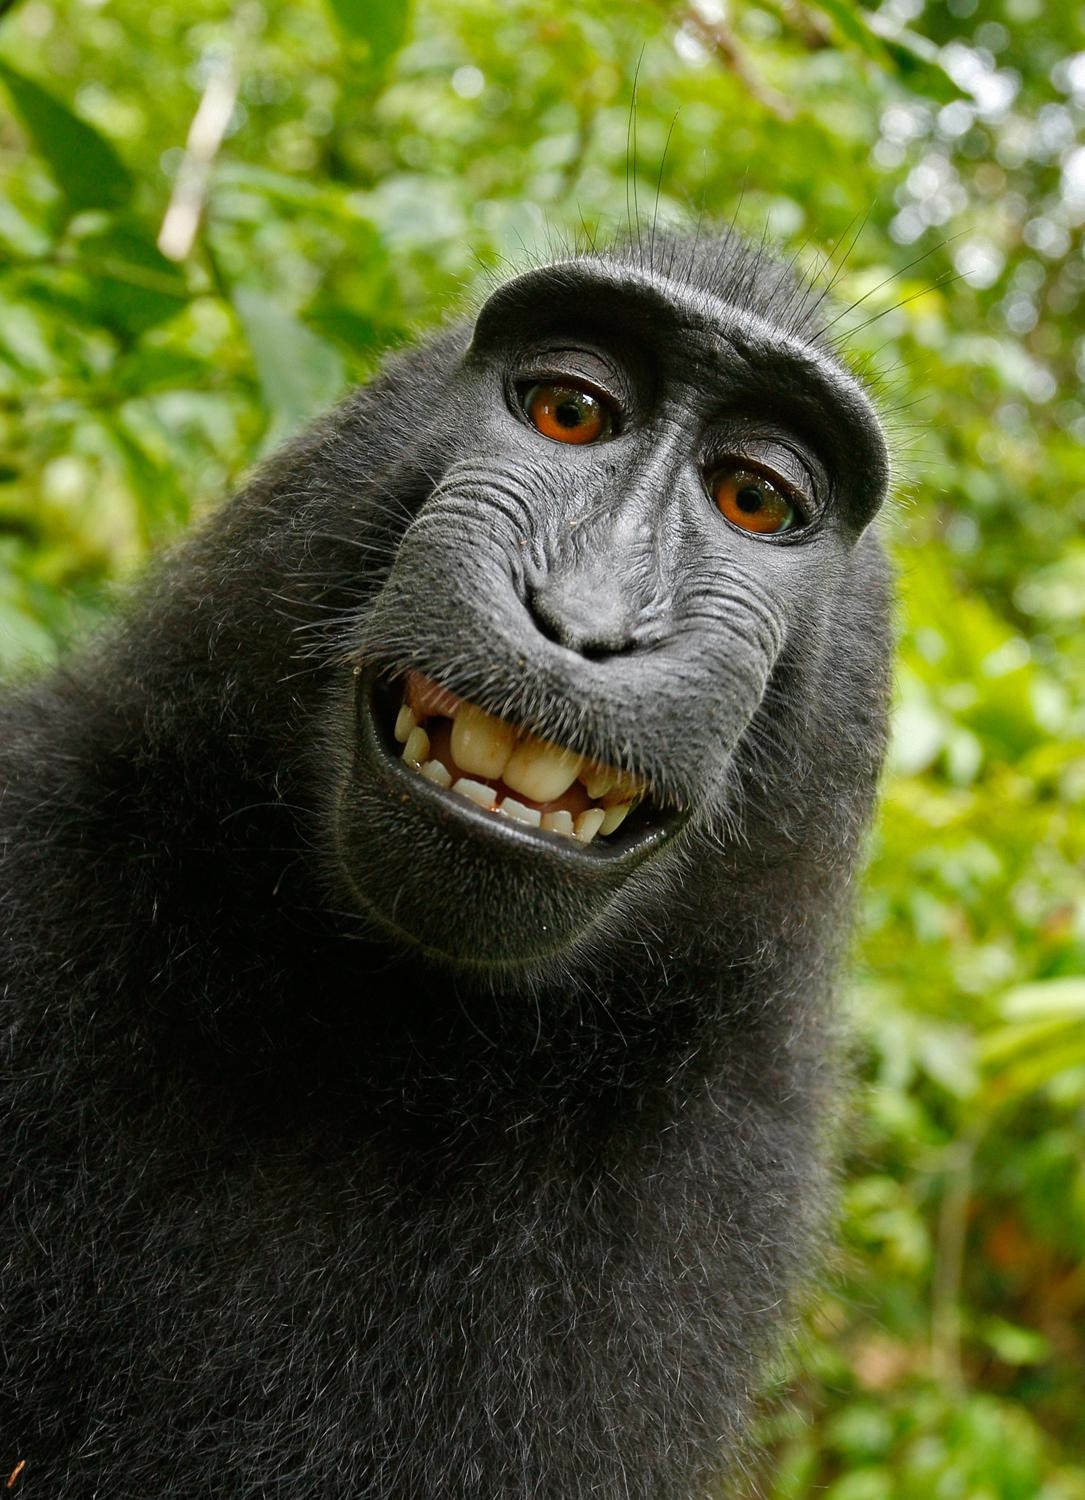 图:黑冠猕猴按动快门拍下的自拍照。美国第九巡回上诉法院在 Naruto v. Slater 案中认定动物不享有版权法保护,确立了非人类作者无法持有版权的法律基准。来源:Wikimedia Commons
这一立场的根基来自黑冠猕猴自拍案 Naruto v. Slater。当年摄影师将相机留在丛林中,一只猕猴按动快门完成了自拍。美国法院最终裁定,非人类主体不享有版权法保护。动物无法持有任何作品的所有权。
该原则随后延伸至人工智能领域。在 Thaler v. Perlmutter 案中,法院重申了基本原则。版权保护的前提是人类投入独创智力。算法自主生成的代码无法获得版权登记。维基媒体也明确规定,纯 AI 生成素材必须标记为公有领域。
各国法律在此处出现了分歧。英国法律为计算机生成作品保留了有限保护。美国与多数国家坚守人类作者底线。纯 AI 生成的代码在诞生时就属于公有领域。商业机构无法在法律上主张排他性所有权。
这种断层让商业私有化主张失去了支撑。许多团队让程序员充当提词器,直接接收模型吐出的海量代码。这些代码在法律上属于没有版权的共有物。企业试图用商业许可将其封闭,依靠的只是行业的信息差。
争论焦点不在工具,谁担风险谁拿收益
要求 AI 代码开源的主张激怒了另一批工程师。支持私有化的开发者提出了一个核心反驳:工具论。
 图:现代软件开发中人类编辑与生成的代码片段交织。当纯机器生成的代码占比越来越高,如何划定人类智力投入的版权边界成为争议焦点。来源:Unsplash / Wikimedia Commons
工程师使用 Linux 或 React 框架写软件,从不需要将业务代码开源。编译器翻译指令,框架提供底座,但成品的产权属于开发者。
工具论的依据在于责任承担机制。线上服务在凌晨崩溃时,模型厂商不会赔偿损失,平台也不会派人排查。最终通宵定位缺陷、承担违约风险的人,依然是一线工程师与企业。
很多工程师坚持一条原则:谁承担系统运行风险,谁就拥有产出的商业回报。在他们看来,大模型只是一套补全插件,或者一台高档打字机。
激进的自动化实践正在瓦解这种抗辩。很多团队不再逐行审查生成代码。工程师仅凭几句提示词,就将程序推向生产环境。 当人类的贡献只剩下几句输入指令,宣称整套系统属于人类独创便很难成立。
既逃避开源义务又想卖版权,中间态难以维系
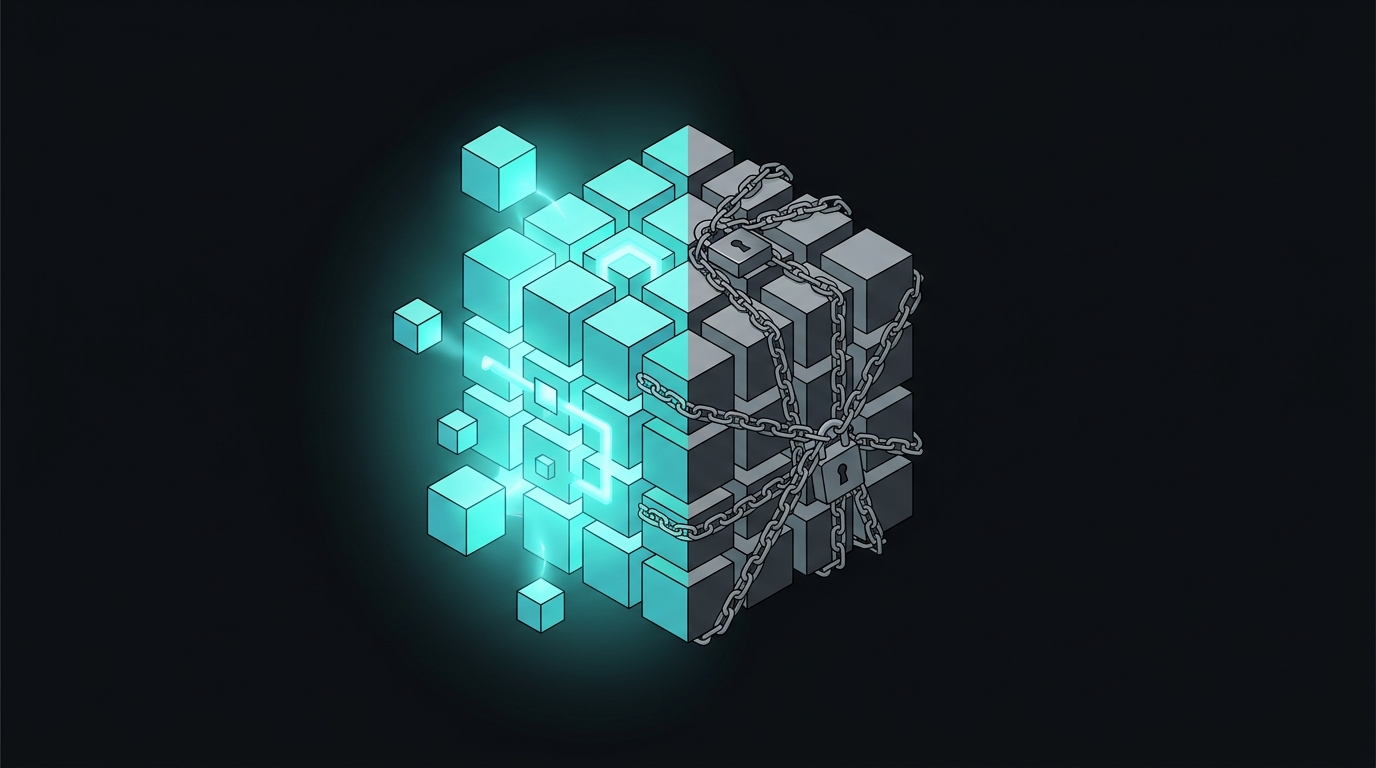
综合审视这两种力量,软件行业暴露出结构性断层。训练时模型吸收了数十年开源成果,拒绝履行署名义务。生成产物因缺乏人类独创性而无法享有版权。商业机构却将其包装为专有资产高价出售。
这种免除开源义务、却享受排他定价的中间状态,不可能维持长久秩序。商业驱动下的双重标准,正在透支开源社区数十年建立的互信。
开源协议的核心宗旨是保护共享生态,防止知识被单向割据。模型依靠算法绕开了协议的字面防线。但这种技术规避无法消除行业协作的契约要求。
商业机构终究要做出抉择。如果坚持 AI 只是工具,企业就必须对训练数据合规负责。商业公司必须为抓取的开源资产支付对价。如果主张模型输出属于新创造,企业就必须接受代码落入公有领域的现实。想把开源积淀无偿转为私有资产的路径,走不通了。司法判例正在收紧这一边界。
参考链接:
- Jakub Jankiewicz 个人博客《All AI-generated code should be Open Source》
- 美国联邦第九巡回上诉法院判决书(Doe v. GitHub, Inc.,2026 年 9 月 16 日)
- 哥伦比亚特区联邦地区法院判决书 (Thaler v. Perlmutter)
- 美国版权局《AI 生成内容版权登记指南》
- Hacker News 社区关于 AI 代码开源主张的讨论