一个仅 1.09 亿参数的文本编码器,击败了在 15–18 万亿 token 上训练的 Qwen2.5-72B 与 Llama-3-70B。布朗大学 Randall Balestriero 与 Yann LeCun 给出了理论证明。决定跨模态收敛的核心在于正样本选取。捕捉到物理世界的独立视角,能将样本需求压缩 42 倍。
这项研究把经验层面的「柏拉图表征假说」写成了数学定理。多模态工程的胜负手变了。竞争重心正在从算力堆叠,转向训练视角的几何设计。
1.09 亿参数击败 720 亿巨无霸:表征效率提升 42 倍
行业过去习惯将多模态表征融合视为模型扩展的副产物。新实验颠覆了这个直觉。在 WIT-1024 基准的 10-NN 检索评测中,1.09 亿参数的优质视角 JEPA 跑出了 0.215 至 0.230 的得分。耗费海量算力的 720 亿参数语言模型,最高得分仅有 0.210。
同语料对照实验排除了数据分布噪音。一旦把 JEPA 换成自回归预测或劣质视角,得分迅速跌落到 0.108 至 0.146。只需 2160 万样本,优质视角 JEPA 就追平了自回归模型在 9 亿样本下的表现。算力堆叠能加深单模态拟合,却无法修复目标函数在几何结构上的缺陷。
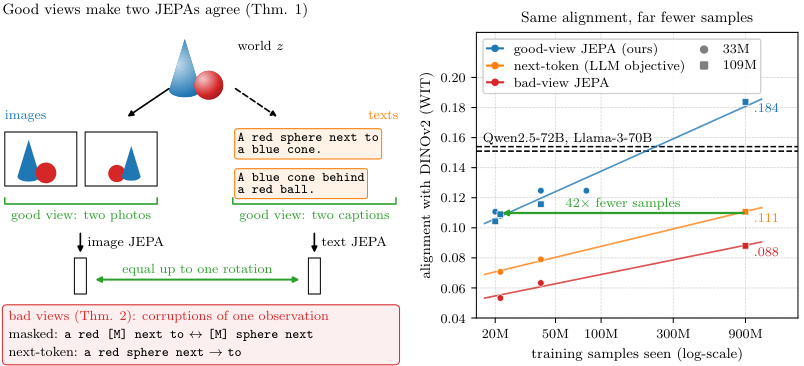 图:左侧展现单一物理世界在不同模态下的投影,右侧展示相似度随样本量的缩放轨迹。来源:Balestriero & LeCun, arXiv:2610.39302
换算成样本需求,优质视角比同语料自回归目标省了 42 倍样本。当训练量扩充到 9 亿时,轻量 JEPA 拿到了 0.184 的评测表现。这一表现越过了训练消耗 18 万亿 token 的商业大模型。
柏拉图猜想变成数学定理:跨模态表征只差一次正交旋转
Huh 等人在两年前提出柏拉图表征假说。他们观察到视觉与语言表征随着模型增大而趋同,但这长期停留在经验归纳阶段。Balestriero 与 LeCun 从谱图论给出了严格证明。带白化二阶反坍缩约束的 JEPA,本质上是在学习正样本图的谱嵌入。
不同传感器观测的是同一个物理世界。只要正样本对绑定相同的状态转移,各模态就在求解同一个拉普拉斯算子。各编码器学到的流形,只是同个结构在不同坐标系下的投影。两个独立训练的单模态编码器,在理想解下只差一个正交旋转。
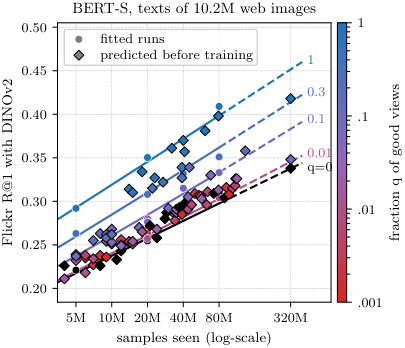 图:跨模态吻合度跨越多个数量级样本的幂律拟合曲线。来源:Balestriero & LeCun, arXiv:2610.39302
这套证明适用于图像、文本、音频与具身控制。模态之间的界限在数学上被抹平了。跨模态系统不必每次都从头联合训练。计算一个旋转矩阵,就能将不同模态的坐标系拼接起来。
语言自回归本质是坏视角:参数堆叠在掩盖几何缺陷
定理成立的前提是正样本必须属于优质视角(good views)。优质视角必须是同一物理现实的两次独立采样。它可以是两个拍摄角度,也可以是两段独立文字描述。这种设计迫使网络过滤表面噪点,提取真实世界的物理不变量。
如果正样本来自对单次观测的局部剪裁或破坏,情况就反了过来。编码器会将宝贵的容量浪费在模态特有的噪音上。自回归语言模型的前缀预测机制,就是典型的劣质视角 JEPA。上下文承载着相同的句法惯性,模型不得不死记硬背符号序列。
千亿参数模型之所以能体现跨模态能力,靠的是用庞大容量强行吸收符号噪音。这是一种代价高昂的工程妥协。依赖自回归目标获取世界模型,在几何效率上并不划算。
85 组实验验证缩放律:单次旋转即可拼出图像描述器
实验数据覆盖了 14.5 万到 9.4 亿样本的四个数量级。由此拟合出的缩放律,成功预测了 85 组新实验的最终收敛曲线。预测误差与更换随机种子的正常波动相当。理论推导出的谱图几何精确掌控了训练全流程。
正交变换的威力在组装测试中得到了展现。研究人员冻结独立训练的视觉编码器与文本 JEPA,中间只挂接一个旋转变换。拼装后的模型在 COCO 图像描述任务上跑出了 0.838 的 CIDEr 成绩。多模态能力不需要破坏单模态权重,单次旋转就能打通特征空间。
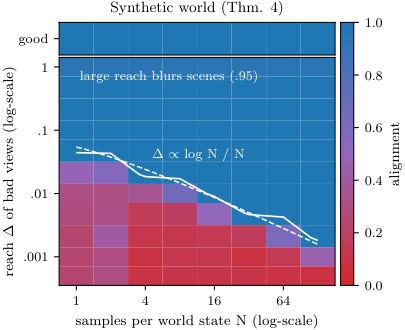 图:旋转操作前后特征向量的分布收敛过程。来源:Balestriero & LeCun, arXiv:2610.39302
在没有配对数据的零样本测试中,该方法依然优势明显。面对 ImageNet-100 的 top-5 零样本分类,文本 JEPA 拿下了 64% 的准确率。受测的 80 亿参数以下语言模型,最高纪录停留在 56%。纯粹的特征空间旋转在下游任务上击败了复杂的自回归微调。
摆脱蛮力预训练:多模态架构面临坐标重构
技术社区曾有疑问:这种收敛是否只是数据压缩的数学巧合?如果存在两套互不相容却能自洽的表征,映射几何会不会失效?因果物理学给出了清晰约束。只要模型需要输出可检验的物理预测,冲突分支就会在真实规律前坍缩。
语言模型证明了海量文本的工程潜力。但自回归并不是学习世界流形的最优方案。用文字接龙硬凑物理常识,算力代价实在过于高昂。柏拉图表征定理划清了界线:决定收敛效率的是样本对的几何定义。
当独立视角让跨模态映射收缩为一次正交旋转,堆砌算力的收益就见顶了。未来的多模态前沿,属于更懂物理几何的数据架构设计。
参考链接:
- Randall Balestriero, Yann LeCun: Proving and Improving the Platonic Representation Hypothesis with JEPAs (arXiv:2610.39302)
- Minnie Huh et al.: The Platonic Representation Hypothesis (arXiv:2405.07987)
- Hacker News 社区技术讨论