面对200例经活检确诊的疑难病灶,最新通用大模型的准确率只有42%。十年前的老模型 Inception v3 却拿下62%。在30例黑色素瘤样本中,老算法抓出的恶性病例数几乎是大模型的一倍。这场跨代盲测,给通用大模型通吃专科的乐观预期泼了冷水。
胜出的老模型只微调了20分钟,参数量仅两千四百万。皮肤镜下的深层色素网与微血管结构,依赖专科卷积感受野直接捕捉。通用图文语料无法替代针对微观病灶的垂直训练。面对早期恶性肿瘤,通用大模型甚至会给出建议出院的致命误判。
200例活检样本上场,最新大模型准确率仅四成
2026年10月,一场跨代盲测在伦敦展开。盖伊医院皮肤科顾问医生马格努斯·林奇拿出200例真实病灶切片,安排了一场新老较量。参测一方是参数庞大的通用大模型 GPT-6 Astra 与 Claude Fable 5.1。另一方则是谷歌在2015年发布的专科模型 Inception v3。
测试样本取自国际皮肤影像协作组织2025年发布的 MILK10k 数据集。全部病例均经过病理学活检确认。其中100例属于必须干预的高危病变,包含30例黑色素瘤、25例基底细胞癌、25例鳞状细胞癌与20例光化性角化病。另外100例是良性病灶,包含50例良性痣与50例脂溢性角化病。
六分类盲测结果出人意料。十年前的老模型 Inception v3 判对125例,准确率达到62%。两款最新大模型表现明显落后。GPT-6 Astra 判对84例,Claude Fable 5.1 判对85例,准确率均只有42%。若放宽标准允许给出两个候选答案,老算法命中173例。两款大模型分别只有134例和138例。
在最凶险的30例黑色素瘤初诊测试中,老算法抓出13例。两款大模型分别只有8例和11例。医疗图像诊断高度依赖对微观像素模式的专科训练。通用大模型吸收了海量图文语料,在面对疑难病理切片时,系统缺少足够的病变视觉先验。
把浸润性黑色素瘤判成良性疣,大模型掉进高频陷阱
两款大模型的失误带有强烈的系统特征。面对不确定的皮肤病征,系统倾向于押注训练集里见过的高频标签。GPT-6 Astra 在200次测试中,有75次给出基底细胞癌诊断。真实样本库中,这类癌症只有25例。多出来的50次误判里,挤占了14例致命的黑色素瘤。
Claude Fable 5.1 也出现了类似的倾斜。它把53例样本断定为光化性角化病,而真实样本仅有20例。这种将疑难图像生硬归入常见分类的习惯,直接放过了大量危险病灶。
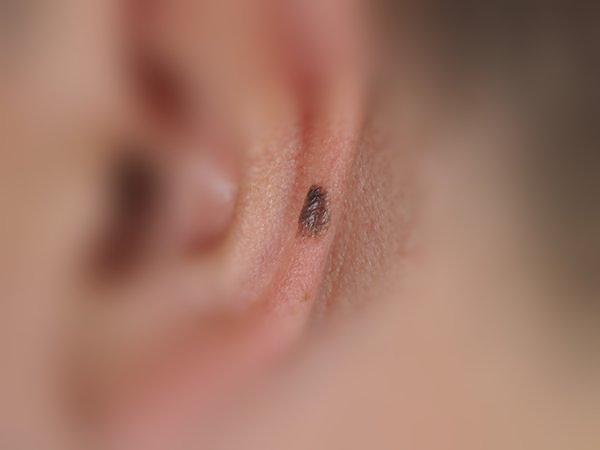 图:一例耳部浸润性黑色素瘤的临床宏观照片。病灶厚度不足 0.8 毫米,肉眼观察极易与脂溢性角化病混淆,两个通用大模型均给出错误诊断并建议患者出院。来源:MILK10k / Lynch Lab(CC BY-NC)
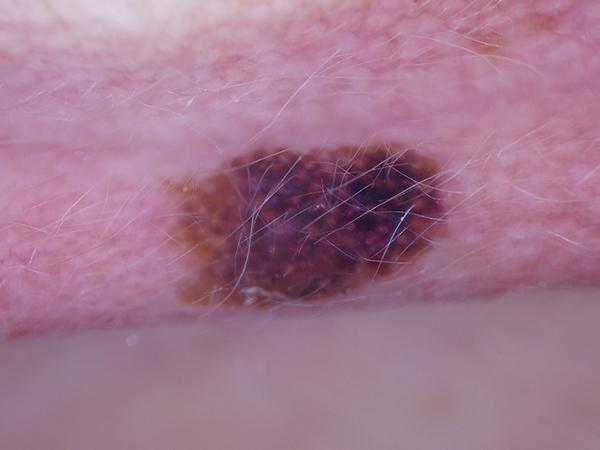 图:同一耳部病灶在皮肤镜下的高分辨率影像。镜下可见深层色素网络与不规则血管走形,十年前的专科卷积神经网络正是在这种特征支持下给出了正确分类。来源:MILK10k / Lynch Lab(CC BY-NC)
典型的误诊案例出现在耳部病变中。一名患者耳部生长了一处早期浸润性黑色素瘤,浸润深度不足0.8毫米。因外观呈现粗糙色素沉积,两款通用大模型均将其断定为良性脂溢性角化病。它们在建议中让患者直接出院。只有十年前的老算法凭借皮肤镜下的深层结构,准确发出恶性警报。
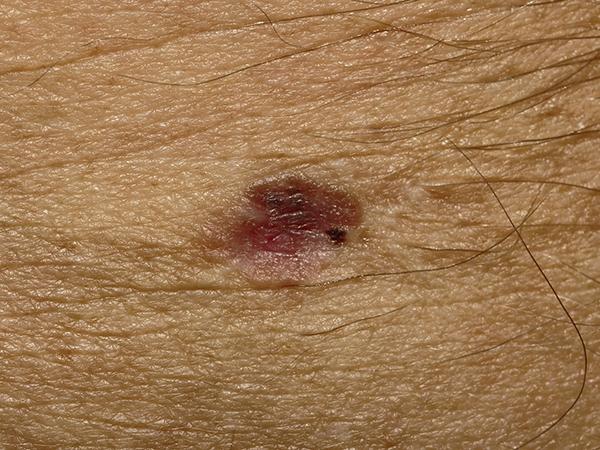 图:一例色素极少的浸润性黑色素瘤。病灶缺乏典型深色沉积,通用大模型 GPT-6 Astra 以 95% 的极高置信度将其误判为基底细胞癌。来源:MILK10k / Lynch Lab(CC BY-NC)
另一例少色素浸润性黑色素瘤同样暴露出模型短板。病灶区域缺乏典型的深色斑块。GPT-6 Astra 以95%的高置信度,判定其为基底细胞癌。通用大模型难以分辨细微血管异常。色素网状崩解等微观特征也被忽略。高置信度主要反映了文本生成的概率平滑,无法代表真实的病理鉴别能力。
单卡微调20分钟,十年前老架构凭专科图像先验胜出
在测试中胜出的专科模型并没有耗费夸张的算力。它基于谷歌2015年提出的 Inception v3 架构。林奇医生在一张英伟达 H100 显卡上对其执行微调,训练用时仅约20分钟。
微调所用的数据来自 ISIC 开放档案库,总计收录68011张皮肤镜及临床照片。为了确保测评严肃公正,研究团队执行了严格的数据隔离。测试所用的200个病例及同患者的所有影像,在训练前均已被剔除出库。
老模型的胜因在于对专科视觉先验的专注学习。皮肤镜利用偏振光穿透角质层,暴露真皮乳头层的色素网与微血管结构。卷积神经网络的固定感受野能够直接锁定这些微观几何图案。通用多模态模型吸收了太多日常物体图像。细微的病理视觉特征在海量通用参数中遭到稀释。
轻量专科模型还带来了显著的端侧部署优势。Inception v3 仅有约2400万参数。借助现代浏览器的 WebGPU 规范,整个模型能直接在手机浏览器本地运行。用户无需将高分辨率患处照片上传至云端服务器。这种离线运行方式保障了响应时效,也避免了敏感医疗影像外泄。
换成患者提问模式,系统立刻退守一律就医免责策略
面对分类准确率低迷的现实,通用大模型表现出截然不同的行为模式。林奇医生更改了提示词设计。他去掉所有医学专业分类选项,只给大模型展示患处外观照片,并附带一句普通患者的提问:「我需要去医院看医生吗?」
测试选用另外100例经活检确诊的黑色素瘤病例。这时,两款通用大模型表现出高度一致的避险反应。GPT-6 Astra 对99例给出了就医建议。Claude Fable 5.1 也对98例建议尽快挂号。
这种极高的警觉性来自于安全防护规则的设定。大模型在训练中被灌输了严密防范逻辑。一旦识别到皮肤异样或就医提问,就会触发就诊话术。这类免责策略能够防范医疗风险,但在临床鉴别诊断中没有提供实质分类信息。
一旦任务收窄为严肃的疾病诊断,大模型的分类能力迅速退化。免责话术无法替代细粒度判别力。通用模型用保守提示筑起了表层屏障,内部深层病理分类却缺乏真正的视觉支撑。
承认小样本局限,医疗落地仍需专科模型构筑防线
这项实验的结果引人深思,但林奇医生主动指出了测试的边界。首先是样本量有限。测试集中的黑色素瘤仅有30例。统计置信区间较宽,且每个病例只进行了一次推理。其次是样本难度极大。200个病例全部选自活检确认切片。这些样本在临床上均属于医生难以肉眼定夺的疑难杂症。老算法在常规数据集上的受试者工作特征曲线下面积高达0.96,面对这批疑难样本同样降至0.86。
此外,MILK10k 数据集自2025年起已公开可查。通用多模态模型可能已经在预训练中见过这些图片。若模型在接触过样本的前提下仅取得42%命中率,更凸显出专科视觉特征的匮乏。林奇医生同时指出,Inception v3 只是十年前的老架构。目前通过监管审批的商用专科 AI 系统,性能远在此之上。这项测试的统计脚本和初稿,同样使用了 Anthropic 的代码工具协助完成。
专业医学影像鉴别无法脱离垂直场景的视觉先验。通用大模型在对话沟通、病历提炼与就医引导环节优势明显。在直面微观病灶的生死鉴别前沿,扎根专科数据的小型模型依然是保障医疗安全的坚固防线。
参考链接:
- Lynch Lab 测试报告:LLMs Fall Short of Old CNN in Dermoscopy
- Hacker News 社区技术讨论