病理生検で確定診断された200例の難治・鑑別困難な皮膚病変に対し、最新の汎用フロンティア大規模言語モデル(LLM)の正答率はわずか42%にとどまりました。一方で、10年以上前に登場した古典的畳み込みニューラルネットワーク(CNN)「Inception v3」は62%の正答率を記録。さらに最重要疾患である悪性黒色腫(メラノーマ)30例においては、旧型モデルが検出した悪性症例数は最新LLMのほぼ2倍に達しました。この世代を超えたブラインド比較実験は、「汎用マルチモーダルモデルがあらゆる専門領域を席巻する」という楽観論に冷や水を浴びせています。
勝利した旧型モデルのパラメータ数はわずか約2,400万、単一GPUによる追加ファインチューニングに要した時間はたったの20分でした。ダーモスコピー画像に見られる深部色素ネットワークや微細血管走行のパターンは、局所的な幾何特徴を直接捉える専用の畳み込み受容野によってこそ抽出されます。ウェブ上の膨大なテキスト・画像データで事前学習された汎用基盤モデルでは、ミクロな病理学的所見を代替できません。初期の浸潤性悪性腫瘍に対し、最新LLMは「経過観察で問題なし(受診不要)」という致命的な誤診すら下しました。
生検確定の200症例で対決:最新LLMの正答率は4割に低迷
2026年10月、ロンドンで新旧AIモデルによるブラインド比較テストが実施されました。ガイ病院の皮膚科コンサルタント医師であるマグナス・リンチ博士は、病理生検で確定診断済みの200例の皮膚病変画像を用意し、対決の場を設けました。迎え撃つ最新鋭は、巨大なパラメータ規模を誇るマルチモーダルLLM「GPT-6 Astra」と「Claude Fable 5.1」。対する相手は、Googleが2015年に発表した専門画像分類アーキテクチャ「Inception v3」です。
テストデータは、国際皮膚画像コラボレーション(ISIC)が2025年に公開したオープンベンチマーク「MILK10k」から抽出されました。全症例が病理生検で裏付けられています。100例は早期介入が必須の高リスク病変(メラノーマ30例、基底細胞癌25例、扁平上皮癌25例、日光角化症20例)。残り100例は良性病変(良性母斑50例、脂漏性角化症50例)で構成されています。
6クラス分類のブラインドテスト結果は衝撃的でした。10年前のInception v3が125例を正しく分類し正答率62%を達成したのに対し、最新LLMはGPT-6 Astraが84例、Claude Fable 5.1が85例と、いずれも約42%と大きく引き離されました。第2候補まで含めたTop-2正答率でも、旧型CNNが173例を的中させたのに対し、LLM勢はそれぞれ134例と138例にとどまりました。
特に命に関わるメラノーマ30例の鑑別では、旧型モデルが13例を検出したのに対し、最新LLMはそれぞれ8例、11例しか特定できませんでした。医療画像診断は微細なピクセルパターンの垂直的学習に強く依存します。膨大な一般知識を持つ大規模モデルであっても、難易度の高い病理画像に対しては、視覚的な診断事前分布(Visual Priors)が根本的に不足していることが浮き彫りになりました。
浸潤性メラノーマを良性イボと誤診:高頻度ラベルに引っ張られる大モデルの罠
最新LLMの誤診には顕著な規則性が見られました。判断に迷う病変に直面した際、モデルは訓練データ中で出現頻度が高いラベルへ安易に賭ける傾向を示したのです。GPT-6 Astraは200回の推論中、75回も「基底細胞癌(BCC)」と診断しました。しかしデータセット内の実際のBCCは25例にすぎません。水増しされた50回の過剰診断の陰で、14例もの致死的なメラノーマが見落とされていました。
Claude Fable 5.1にも同様の偏向が現れました。実データには20例しかない日光角化症に対し、53例をその病名と断定したのです。解釈の難しい画像をありふれた診断枠へ強引に当てはめるこの挙動は、危険な悪性腫瘍を大量に見逃す致命的なリスクに直結します。
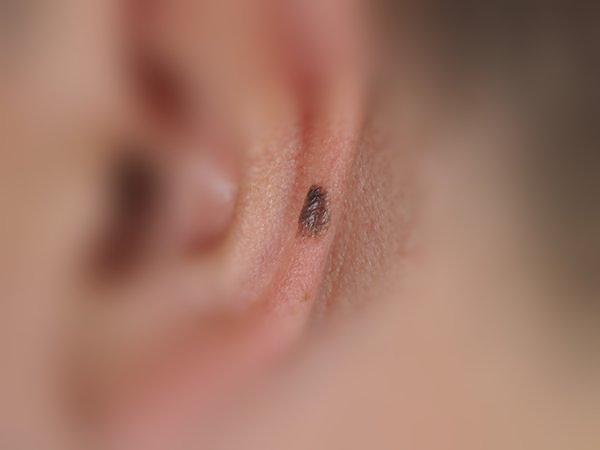 図:耳介部に生じた浸潤性悪性黒色腫の臨床肉眼写真。ブレスロー厚0.8mm未満の早期病変であり、肉眼では良性の脂漏性角化症と極めて誤認しやすい。2つの最新LLMはいずれも良性と誤認し、受診不要の助言を出力した。出典:MILK10k / Lynch Lab (CC BY-NC)
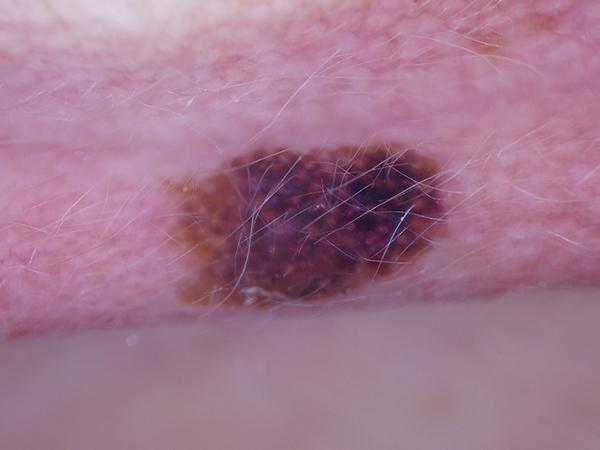 図:同一病変の高解像度ダーモスコピー画像。深層の色素ネットワーク構造と不整な血管走行が観察できる。10年前の専用CNNは、まさにこの微細構造を捉えて正確に悪性と判定した。出典:MILK10k / Lynch Lab (CC BY-NC)
典型的な誤診例が耳介部の病変です。厚さ0.8mm未満の早期浸潤性メラノーマを患った症例では、表面の粗い角化と色素沈着から、最新LLMの双方が良性の「脂漏性角化症」と誤診。さらに「特に心配はなく通院も不要」と助言しました。偏光ダーモスコピー下の深部組織構造を読み取って悪性のアラートを正確に鳴らせたのは、10年前の旧型CNNだけでした。
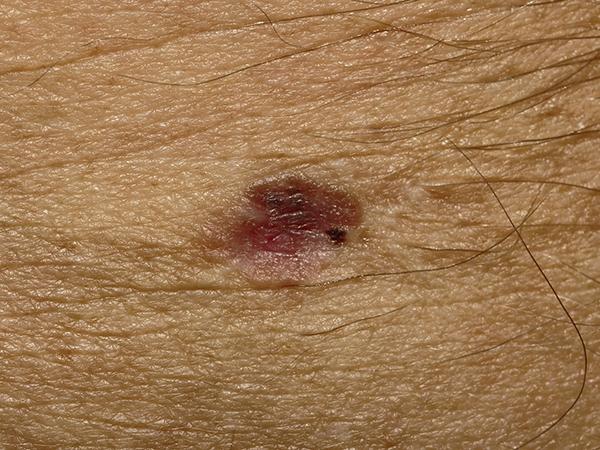 図:メラニン沈着に乏しい無色素性浸潤性悪性黒色腫。典型的な黒色色素沈着を欠くため、GPT-6 Astraは95%という極めて高い確信度で基底細胞癌と誤判定した。出典:MILK10k / Lynch Lab (CC BY-NC)
色素沈着の乏しい無色素性メラノーマでも弱点が露呈しました。GPT-6 Astraは95%という驚異的な確信度でこれを基底細胞癌と誤判定。マルチモーダルLLMは、微細な血管新生の異常や色素ネットワークの断裂を捉えきれません。言語モデルが示す「高い確信度」は、単にテキスト生成時の確率分布が平滑化されている結果にすぎず、実際の病理鑑別能力を反映したものではありません。
単一GPUで20分ファインチューン:旧型モデルが専門事前分布で勝てた理由
今回首位に立った旧型モデルは、巨大な計算資源を消費したわけではありません。Googleが2015年に設計したInception v3アーキテクチャをベースに、リンチ医師が単一のNVIDIA H100 GPU上で約20分間微調整しただけのものです。
学習データにはISICの公開アーカイブから68,011枚のダーモスコピーおよび臨床写真を使用。厳格な科学的妥当性を担保するため、評価に用いた200症例および同一患者の別画像は、学習前にデータセットから完全に隔離・除外されました。
旧型モデルの勝因は、皮膚科領域に特化した視覚事前分布の徹底的な学習にあります。偏光ダーモスコピーは角質層を透過し、真皮乳頭層の色素網や毛細血管網を可視化します。CNNの固定受容野は、こうした微視的な幾何構造を捉えることに極めて適しています。対して汎用マルチモーダルモデルは、日常的な風景や物体画像を過剰に学習した結果、パラメータ空間内で専門的な病理特徴が希釈されてしまっているのです。
さらに、軽量な専用モデルはエッジ端末展開において絶大なアドバンテージを持ちます。パラメータ数わずか2,400万のInception v3は、WebGPUを介してスマートフォンのブラウザ上で完全にローカル動作します。患者が撮影した高解像度の患部画像を外部サーバーに送信する必要がないため、プライバシー保護と即時性の両立が可能です。
患者の相談プロンプトに切り替えると一転:全件「受診推奨」の免責モードへ
正式な分類タスクで苦戦した汎用LLMですが、プロンプトの形式を変えると全く異なる反応を示しました。リンチ医師が専門的な選択肢をすべて外し、一般患者の相談を模した「病院へ行くべきですか?」という一文とともに患部写真を提示したところ、挙動が一変したのです。
生検確定済みのメラノーマ100例で追試を行った結果、両モデルは強烈なリスク回避行動を見せました。GPT-6 Astraは99例で受診を強く推奨し、Claude Fable 5.1も98例で直ちに受診するよう助言しました。
この過敏な反応は、モデルに組み込まれたアライメントと安全ガードレールに起因します。皮膚の異常や受診相談の文脈を検知すると、即座に定型の受診推奨テンプレートが発動するように設計されているためです。こうした免責的対応は医療訴訟リスクを防ぐ上では有用ですが、鑑別診断としての実質的な情報価値はゼロに等しいと言えます。
タスクを厳密な疾患鑑別に絞った瞬間、汎用モデルの診断能力は崩壊します。安全重視の対話テンプレートは表面的な防壁にすぎず、その内側に精緻な病理学的視覚識別能力が備わっているわけではないことが実証されました。
小サンプルテストの限界を踏まえつつ、医療現場が導くべき教訓
本実験の結果は示唆に富んでいますが、リンチ医師自身もテストの限界を率直に提示しています。第一にサンプルサイズです。メラノーマ症例は30例と限られており、統計的信頼区間は広めで、推論も1回試行です。第二にサンプルの難易度です。200例すべてが生検を必要とした症例であり、臨床現場でも熟練医師が目視だけで判断に悩む難病変ばかりでした。Inception v3自身も、通常のISICベンチマークではAUROC 0.96を記録するのに対し、今回の難症例群では0.86まで低下しています。
さらに、MILK10kデータセットは2025年から公開されており、LLMの事前学習データに含まれていた可能性もあります。仮にデータ汚染があったとしても正答率が42%にとどまった事実は、専門的視覚特徴の獲得がいかに困難であるかを物語っています。また、Inception v3は10年前のベースラインにすぎず、現在規制当局の承認を得ている商用の専門AIシステムはこれを遥かに凌駕する性能を持っています。興味深いことに、本研究の統計解析スクリプトや草稿作成にはAnthropicのコード支援ツールが活用されました。
専門的な医用画像診断には、現場特化の視覚事前分布が欠かせません。汎用フロンティアモデルは患者との対話、カルテ要約、問診トリアージなどで比類なき価値を発揮するでしょう。しかし、生命を左右する微細病変の鑑別の最前線においては、専門データで丹念に鍛え上げられた小型専用モデルこそが、医療安全を守る堅固な防波堤であり続けます。
参考リンク:
- Lynch Lab レポート: LLMs Fall Short of Old CNN in Dermoscopy
- Hacker News コミュニティ技術ディスカッション