Frente a 200 casos complejos confirmados mediante biopsia patológica, la precisión de los modelos de lenguaje multimodales de última generación apenas alcanzó el 42 %. En contraste, Inception v3, una arquitectura convolucional de hace más de una década, obtuvo un 62 %. En el subconjunto crítico de 30 muestras de melanoma, el algoritmo veterano detectó casi el doble de casos malignos que los LLM punteros. Esta evaluación a ciegas intergeneracional supone un duro baño de realidad ante la expectativa de que los modelos generalistas conquistarán sin esfuerzo la medicina especializada.
El modelo vencedor requirió apenas 20 minutos de ajuste fino (fine-tuning) y cuenta con solo 24 millones de parámetros. Bajo el dermatoscopio, las redes pigmentarias profundas y los patrones microvasculares atípicos dependen de campos receptivos convolucionales diseñados específicamente para aislar estructuras geométricas sutiles. Los ingentes volúmenes de texto e imágenes generalistas de internet no pueden sustituir el entrenamiento vertical sobre micrografías patológicas. Ante neoplasias malignas invasivas en estadio temprano, los modelos generalistas llegaron a emitir diagnósticos fatales, recomendando dar el alta a los pacientes sin seguimiento.
Frente a 200 lesiones confirmadas por biopsia: los grandes LLM se quedan en el 40 %
En octubre de 2026 tuvo lugar en Londres una exhaustiva prueba a ciegas generacional. El Dr. Magnus Lynch, dermatólogo consultor en Guy’s Hospital, reunió 200 imágenes de lesiones reales validadas histológicamente para organizar un cara a cara definitivo. De un lado compitieron modelos generalistas de enorme escala: GPT-6 Astra y Claude Fable 5.1. Del otro se encontraba Inception v3, arquitectura publicada por Google en 2015.
Las muestras procedían de MILK10k, un banco de pruebas de referencia abierto publicado en 2025 por el International Skin Imaging Collaboration (ISIC). Todos los casos contaban con respaldo de biopsia. La mitad (100 casos) correspondía a patologías de alto riesgo que requerían intervención inmediata: 30 melanomas, 25 carcinomas basocelulares (CBC), 25 carcinomas escamocelulares y 20 queratosis actínicas. Los otros 100 casos integraban el grupo de control benigno: 50 nevus benignos y 50 queratosis seborreicas.
El resultado de la clasificación a ciegas entre seis patologías fue demoledor. Inception v3 acertó 125 casos, alcanzando una precisión del 62 %. Los LLM más recientes quedaron muy rezagados: GPT-6 Astra acertó 84 y Claude Fable 5.1 clasificó 85 (ambos alrededor del 42 %). Al ampliar el criterio a precisión top-2 (admitiendo dos opciones diagnósticas), el veterano CNN identificó 173 casos, frente a solo 134 y 138 de los modelos de lenguaje.
En los 30 casos más delicados de melanoma invasivo, el algoritmo clásico detectó 13 casos en el diagnóstico inicial, mientras que los grandes modelos solo identificaron 8 y 11 respectivamente. El diagnóstico por imagen médica depende de un aprendizaje específico sobre microestructuras a nivel de píxel. Por más datos multimodales globales que hayan ingerido, los LLM generalistas carecen del conocimiento visual previo indispensable para interpretar cortes patológicos complejos.
Confundir un melanoma invasivo con una verruga benigna: la trampa de la alta frecuencia
Los errores de los modelos generalistas mostraron claros sesgos sistemáticos. Al enfrentarse a manifestaciones cutáneas ambiguas, tendieron a apostar por las etiquetas diagnósticas más frecuentes de sus datos de entrenamiento. En 200 pruebas, GPT-6 Astra diagnosticó carcinoma basocelular en 75 ocasiones, a pesar de que el conjunto de prueba solo contenía 25 casos reales de esta neoplasia. Detrás de esos 50 falsos positivos, quedaron sepultados y desatendidos 14 melanomas letales.
Claude Fable 5.1 mostró una desviación semejante: atribuyó 53 muestras a queratosis actínica, frente a las 20 reales. Esta costumbre de encasillar imágenes de difícil interpretación en categorías comunes propició el descarte inadvertido de lesiones sumamente peligrosas.
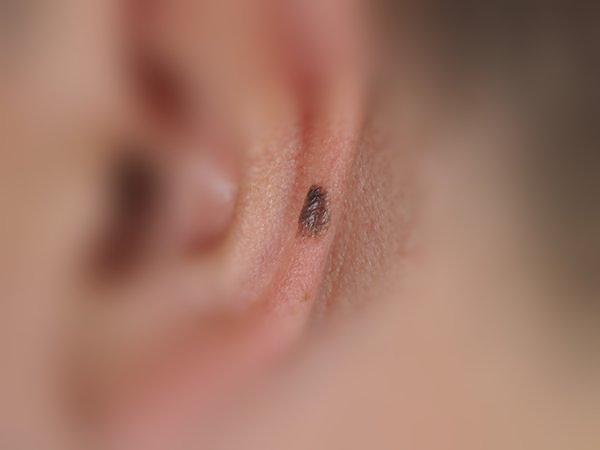 Figura: Fotografía clínica macroscópica de un melanoma invasivo en la oreja. Con un espesor de Breslow inferior a 0,8 mm, la lesión se confunde con facilidad con una queratosis seborreica benigna a simple vista. Ambos LLM generalistas la catalogaron erróneamente como benigna y desaconsejaron la atención médica. Fuente: MILK10k / Lynch Lab (CC BY-NC)
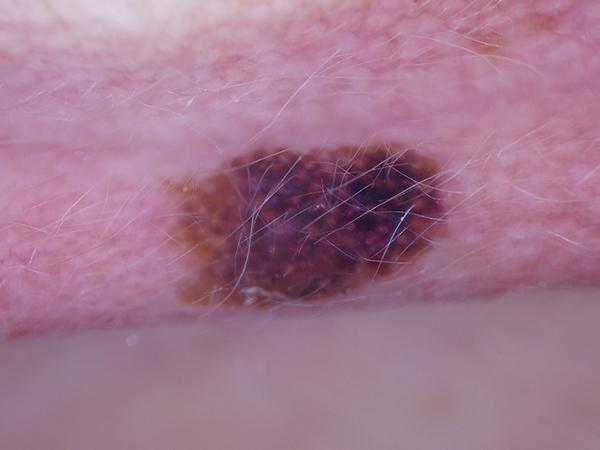 Figura: Imagen dermatoscópica de alta resolución de la misma lesión. Bajo la superficie se aprecian redes pigmentarias atípicas y vasos irregulares. Gracias a estos patrones estructurales, el CNN de hace diez años emitió la alerta correcta por neoplasia maligna. Fuente: MILK10k / Lynch Lab (CC BY-NC)
Un ejemplo alarmante se produjo en una lesión auricular. Un paciente presentaba un melanoma invasivo precoz con un espesor de Breslow inferior a 0,8 mm. Su superficie descamativa y pigmentación heterogénea llevaron a ambos LLM a catalogarlo como una benigna queratosis seborreica. En su informe, aconsejaron que el paciente no necesitaba consulta posterior. Solo la red convolucional especializada, examinando las estructuras bajo dermatoscopia polarizada, identificó la malignidad.
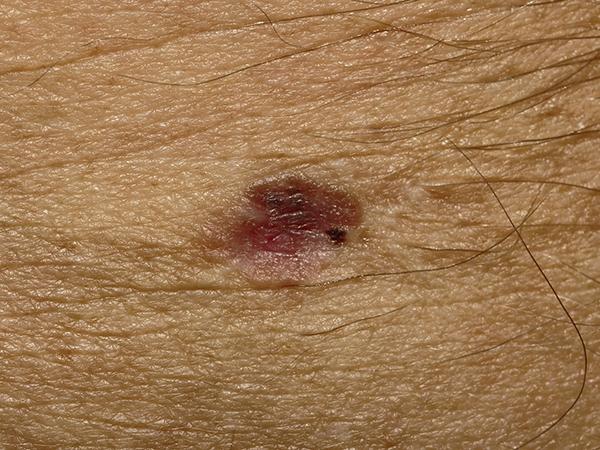 Figura: Melanoma invasivo amelanótico con escasa pigmentación melánica. Al carecer de la pigmentación oscura habitual, GPT-6 Astra lo clasificó erróneamente como carcinoma basocelular con un 95 % de confianza. Fuente: MILK10k / Lynch Lab (CC BY-NC)
Otro caso de melanoma amelanótico puso de relieve las debilidades de los grandes modelos. Al carecer de depósitos oscuros evidentes, GPT-6 Astra afirmó con una confianza del 95 % que se trataba de un carcinoma basocelular. Los modelos generalistas tienen serias dificultades para identificar anomalías vasculares finas y rupturas reticulares sutiles. En un LLM, una confianza elevada suele reflejar la suavización de probabilidades propia de la generación de texto, no una capacidad patológica real.
Ajuste fino en 20 minutos con una sola GPU: la ventaja del aprendizaje especializado
El modelo que se impuso en las pruebas no necesitó una capacidad de cómputo desmesurada. Desarrollado sobre la arquitectura Inception v3 de Google de 2015, el Dr. Lynch lo ajustó en una única tarjeta NVIDIA H100 en unos 20 minutos.
El corpus de entrenamiento provino del archivo abierto de ISIC, con 68 011 imágenes clínicas y dermatoscópicas. Para garantizar la máxima rigurosidad, se aplicó un aislamiento absoluto: los 200 casos del conjunto de prueba y cualquier imagen de los mismos pacientes fueron excluidos de la base de datos antes de entrenar.
La superioridad del modelo veterano radica en la asimilación profunda de patrones visuales dermatológicos. La dermatoscopia utiliza luz polarizada para traspasar el estrato córneo y revelar las redes pigmentarias y los capilares de la dermis papilar. Los campos receptivos de una red convolucional capturan directamente estas geometrías microscópicas. En cambio, los modelos multimodales generalistas diluyen los rasgos patológicos entre miles de millones de parámetros entrenados con fotos cotidianas de internet.
Asimismo, los modelos ligeros especializados aportan ventajas decisivas para su implementación local (on-device). Con apenas 24 millones de parámetros, Inception v3 se ejecuta en navegadores móviles mediante WebGPU. Esto permite procesar imágenes de alta resolución en el propio dispositivo sin enviar historiales médicos a la nube, preservando la privacidad del paciente y garantizando una respuesta instantánea.
El cambio al rol de consulta del paciente: retirada hacia el descargo de responsabilidad
Ante la baja precisión en clasificación formal, los LLM generalistas mostraron una reacción completamente opuesta cuando se varió el formato de consulta. El Dr. Lynch eliminó las opciones diagnósticas técnicas y presentó únicamente la fotografía de la lesión junto a una pregunta común: «¿Debería ir al médico a revisar esto?»
Al evaluar otros 100 casos de melanoma confirmados por biopsia, los dos modelos mostraron una aversión extrema al riesgo. GPT-6 Astra recomendó acudir al especialista en 99 de los 100 casos, y Claude Fable 5.1 aconsejó pedir cita médica en 98.
Esta elevada sensibilidad deriva de sus mecanismos de seguridad y alineación. Están programados para activar plantillas de advertencia sanitaria en cuanto detectan una irregularidad dérmica o una consulta de salud. Si bien estas advertencias mitigan la responsabilidad legal, carecen de cualquier valor clínico diferencial.
En el instante en que el reto exige una discriminación diagnóstica rigurosa, la competencia de los modelos generalistas se desmorona. Las frases de precaución no suplen la capacidad de discernimiento; el discurso defensivo es solo una fachada que oculta la ausencia de comprensión visual patológica.
Limitaciones del ensayo y lecciones para la integración de la IA médica
Aunque los hallazgos son reveladores, el Dr. Lynch reconoció abiertamente las limitaciones del experimento. La primera es el tamaño de la muestra: 30 melanomas implican intervalos de confianza amplios y evaluaciones basadas en una sola inferencia por caso. La segunda es la extraordinaria dificultad clínica: las 200 lesiones representaban casos de biopsia que presentaban dudas incluso a dermatólogos experimentados. El propio Inception v3, que alcanza un AUROC de 0,96 en el conjunto de ISIC estándar, bajó a 0,86 en este lote complejo.
Además, el conjunto MILK10k es de acceso público desde 2025, por lo que los LLM podrían haber visto estas imágenes durante su preentrenamiento. Que aun con esa posibilidad solo obtuvieran un 42 % resalta todavía más su falta de especialización visual. El Dr. Lynch también recordó que Inception v3 es un diseño de 2015; los sistemas de IA médica comercializados y homologados hoy en día ofrecen rendimientos muy superiores. Curiosamente, los scripts estadísticos y el borrador de este estudio se redactaron con ayuda de herramientas de programación asistida de Anthropic.
El diagnóstico por imagen médica especializada no puede prescindir del conocimiento visual del entorno clínico concreto. Los modelos fundacionales generalistas seguirán brillando en la comunicación con el paciente, el triaje inicial y el resumen de historiales. Sin embargo, en la frontera crítica del diagnóstico diferencial que salva vidas, los modelos compactos entrenados en datos clínicos especializados continúan siendo la barrera de seguridad más fiable de la medicina.
Enlaces de referencia:
- Informe de Lynch Lab: LLMs Fall Short of Old CNN in Dermoscopy
- Debate técnico en la comunidad de Hacker News

