조직생검으로 확진된 까다로운 피부 병변 200건을 대상으로 한 블라인드 진단 테스트에서 최신 범용 초거대 멀티모달 모델들의 정확도는 42%에 그쳤다. 반면 10여 년 전 발표된 구형 모델인 Inception v3는 62%를 기록했다. 특히 가장 치명적인 흑색종 30건을 식별하는 시험에서 구형 알고리즘이 잡아낸 악성 종양 건수는 최신 LLM의 거의 두 배에 달했다. 이번 세대 간 블라인드 테스트는 범용 대형 모델이 전문 진료 영역까지 단숨에 집어삼킬 것이라는 장밋빛 전망에 차가운 경종을 울렸다.
승리를 거둔 구형 모델은 단일 GPU에서 단 20분 동안 미세조정(Fine-tuning)을 거쳤으며, 파라미터 수는 2,400만 개에 불과하다. 더모스코피(피부확대경) 영상에서 드러나는 심층 색소망과 미세혈관 주행 패턴은 국소 기하 구조를 정밀하게 포착하도록 설계된 전문 합성곱 수용영역(Receptive field)에 의존한다. 웹 규모의 방대한 일반 텍스트·이미지 말뭉치는 미세 병리 소견을 대체할 수 없다. 초기 침윤성 악성 종양 앞에서 최신 범용 모델들은 암 환자에게 아무 조치 없이 귀가해도 좋다는 치명적인 오진까지 내놓았다.
조직검사 확진 200건 블라인드 대결, 최신 LLM 정확도는 40%대에 머물러
2026년 10월, 런던에서 세대를 뛰어넘는 인공지능 블라인드 대결이 펼쳐졌다. 가이 병원(Guy’s Hospital) 피부과 전문의 매그너스 린치(Magnus Lynch) 박사는 조직검사로 병리가 확진된 실제 병변 이미지 200건을 모아 신구 모델 간의 맞대결을 주선했다. 한쪽은 막대한 파라미터 수를 자랑하는 최신 범용 프론티어 모델인 GPT-6 Astra와 Claude Fable 5.1이었고, 다른 한쪽은 구글이 2015년에 공개했던 전문 이미지 분류 아키텍처 Inception v3였다.
테스트 데이터는 국제피부영상협력체(ISIC)가 2025년에 공개한 오픈 벤치마크인 MILK10k 데이터셋에서 추출되었다. 모든 증례는 병리학적 생검을 통해 확진 판정을 받았다. 이 중 100건은 즉각적인 임상 개입이 필요한 고위험 병변으로, 흑색종 30건, 기저세포암 25건, 편평세포암 25건, 광선각화증 20건으로 이루어졌다. 나머지 100건은 양성 대조군으로, 양성 모반 50건과 지루각화증 50건이었다.
6개 질환 분류 블라인드 테스트 결과는 충격적이었다. 10년 전 모델인 Inception v3는 125건을 정확히 맞혀 62%의 정확도를 달성했다. 반면 최신 대형 모델들의 성적은 초라했다. GPT-6 Astra는 84건, Claude Fable 5.1은 85건을 맞히는 데 그치며 나란히 42% 수준에 머물렀다. 상위 2개 후보까지 정답으로 인정하는 Top-2 기준에서도 구형 CNN은 173건을 적중시킨 반면, 두 최신 대형 모델은 각각 134건과 138건에 그쳤다.
특히 생명을 위협하는 침윤성 흑색종 30건의 초기 진단 테스트에서 구형 모델은 13건을 찾아냈지만, 두 범용 모델은 각각 8건과 11건만을 감별했다. 의료 영상 판독은 미세 픽셀 패턴에 대한 수직적이고 전문화된 학습에 절대적으로 의존한다. 범용 대형 모델이 아무리 방대한 양의 멀티모달 데이터를 학습했더라도, 고난도 병리 영상 앞에서는 결정적인 시각적 사전 분포(Visual Priors)가 결여되어 있음이 명백히 드러났다.
침윤성 흑색종을 양성 사마귀로 오진, 고빈도 편향의 함정에 빠진 대형 모델
최신 대형 모델들의 오진에는 뚜렷한 시스템적 결함이 있었다. 판별이 모호한 피부 병변을 마주했을 때, 모델은 사전 학습 데이터에서 자주 등장했던 고빈도 질환 라벨로 회피하는 성향을 보였다. GPT-6 Astra는 200회 테스트 중 무려 75회나 ‘기저세포암(BCC)’ 진단을 내렸다. 하지만 실제 데이터셋에서 기저세포암은 25건에 불과했다. 과도하게 남발된 50건의 오진 이면에서 치명적인 악성 흑색종 14건이 조용히 묻혀버렸다.
Claude Fable 5.1 역시 비슷한 왜곡을 보였다. 실제 샘플이 20건뿐인 광선각화증에 대해 53건이나 해당 질환으로 분류한 것이다. 판독하기 까다로운 이미지를 흔한 진단명으로 억지 분류하는 이러한 편향은 위험한 중증 병변을 대량으로 놓치는 치명적인 결과를 낳는다.
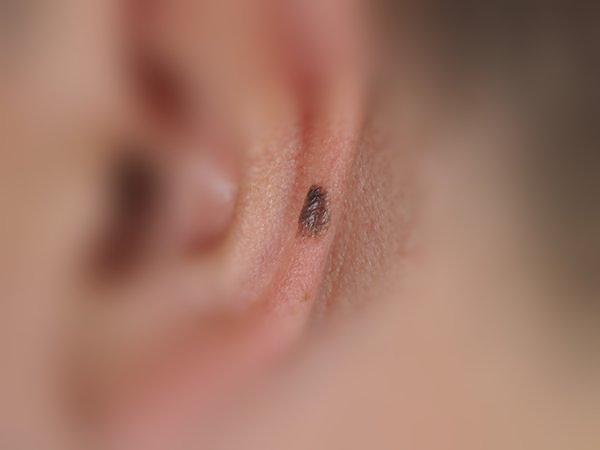 사진: 귀 부위에 발생한 침윤성 악성 흑색종의 육안 임상 사진. 브레슬로 두께가 0.8mm 미만인 초기 병변으로, 육안으로는 양성 지루각화증과 구별하기 극히 어렵다. 두 최신 범용 모델은 모두 이를 양성으로 오진하고 환자에게 진료가 필요 없다고 권고했다. 출처: MILK10k / Lynch Lab (CC BY-NC)
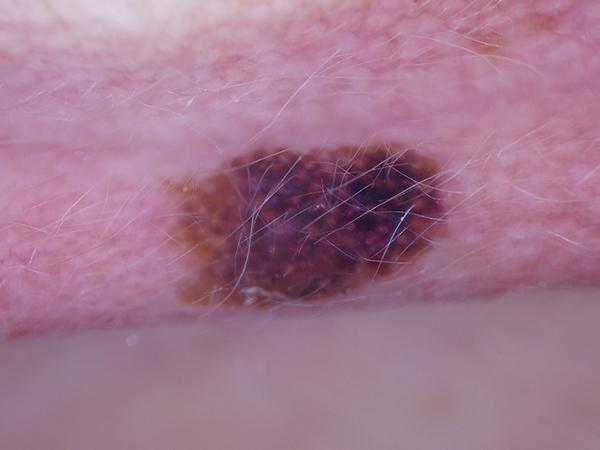 사진: 동일한 병변의 고해상도 더모스코피 영상. 피부 표면 아래로 비정형 색소망과 불규칙한 미세혈관 주행이 관찰된다. 10년 전 구형 CNN은 바로 이러한 미세 구조적 특징을 포착해 정확하게 악성 종양으로 판정했다. 출처: MILK10k / Lynch Lab (CC BY-NC)
대표적인 오진 사례는 귀 부위 병변에서 발생했다. 한 환자의 귀에 브레슬로 두께 0.8mm 미만의 초기 침윤성 흑색종이 자라나 있었다. 표면의 거친 각화와 불규칙한 색소 침착 때문에 두 범용 모델은 이를 양성 지루각화증으로 오진했다. 심지어 환자에게 병원에 갈 필요 없이 귀가해도 좋다는 권고까지 내놓았다. 오직 10년 전 구형 알고리즘만이 편광 더모스코피로 투과된 심층 조직 구조를 읽어내어 악성 종양 경보를 울렸다.
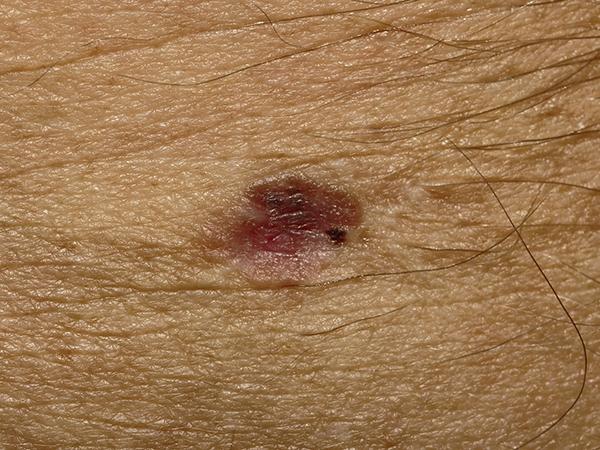 사진: 멜라닌 색소 침착이 거의 없는 무색소성 침윤성 흑색종. 전형적인 어두운 색소 침착이 없다는 이유로 GPT-6 Astra는 95%라는 매우 높은 확신도를 보이며 기저세포암으로 오진했다. 출처: MILK10k / Lynch Lab (CC BY-NC)
색소 침착이 드문 무색소성 흑색종 증례에서도 대형 모델의 치명적 한계가 드러났다. GPT-6 Astra는 95%라는 압도적인 확신도로 이를 기저세포암으로 오진했다. 범용 모델은 미세혈관의 비정상적 증식이나 색소망 붕괴 같은 미세 징후를 분별하지 못한다. 언어 모델이 출력하는 ‘높은 확신도’는 텍스트 생성 확률 분포의 평활화 결과일 뿐, 실제 병리학적 감별 진단 능력을 뒷받침하지 못한다.
단일 GPU로 20분 미세조정, 도메인 특화 시각 정보로 완승한 구형 아키텍처
테스트에서 1위를 차지한 전문 모델은 엄청난 컴퓨팅 파워를 소모하지 않았다. 구글이 2015년에 설계한 Inception v3 아키텍처 기반으로, 린치 박사는 단 한 장의 엔비디아 H100 GPU에서 약 20분 동안 미세조정을 진행했을 뿐이다.
학습 데이터는 ISIC 공개 아카이브에서 선별한 68,011장의 더모스코피 및 임상 사진이었다. 엄격하고 공정한 평가를 위해 연구팀은 철저한 데이터 격리를 단행했다. 테스트에 사용된 200건의 증례 및 해당 환자의 모든 관련 이미지는 학습 시작 전 데이터셋에서 완전히 배제되었다.
구형 모델의 승인은 피부과 특화 시각 사전 분포(Visual Priors)에 집중 학습한 데 있다. 편광 더모스코피는 각질층을 통과하여 진피 유두층의 색소 네트워크와 미세 모세혈관 구조를 드러낸다. CNN의 고정된 수용영역은 이러한 미세 기하학적 패턴을 직접 포착하는 데 최적화되어 있다. 반면 범용 멀티모달 모델은 일상적인 사물 이미지를 너무 많이 학습하면서, 방대한 파라미터 속에서 섬세한 병리 특징이 희석되고 만다.
경량 특화 모델은 온디바이스(On-device) 배포 측면에서도 강력한 이점을 제공한다. 파라미터가 약 2,400만 개에 불과한 Inception v3는 웹브라우저의 WebGPU 표준을 통해 스마트폰 브라우저에서 로컬로 직접 구동될 수 있다. 환자나 의료진이 고해상도 환부 사진을 외부 클라우드 서버로 업로드할 필요가 없다. 이러한 오프라인 구동 방식은 지연 없는 즉각적인 반응을 보장할 뿐 아니라, 민감한 개인 의료 정보의 외부 유출을 원천 차단한다.
환자 질문 모드로 전환하자 일괄 ‘병원 방문 권고’ 면책 모드로 후퇴
정밀 진단 분류에서 저조한 성적표를 받아든 범용 대형 모델들은 프롬프트 형식을 바꾸자 완전히 다른 행동 양식을 보였다. 린치 박사는 6가지 질환 보기를 모두 제거하고, 일반 환자의 자연스러운 문의를 흉내 낸 한 줄의 질문과 함께 환부 사진만을 제시했다. “이거 병원에 가서 의사 진료를 받아야 하나요?”
조직검사로 확진된 또 다른 100건의 흑색종 증례로 테스트한 결과, 두 범용 모델은 극단적인 위험 회피 반응을 나타냈다. GPT-6 Astra는 100건 중 99건에 대해 즉시 병원 진료를 권고했고, Claude Fable 5.1 역시 98건에 대해 신속히 전문의를 찾아가라고 조언했다.
이러한 높은 경각심은 모델에 적용된 안전성 및 책임 방어 가드레일에서 비롯된다. 모델들은 피부 이상 징후나 진료 문의가 감지되면 즉각 안전 템플릿 문구를 출력하도록 훈련받았다. 이러한 면책성 조치는 의료 소송 위험을 방어하는 데는 유용할지 모르지만, 실질적인 감별 진단 정보는 전혀 제공하지 못한다.
진단 과제가 정밀한 질환 감별로 좁혀지는 순간, 범용 모델의 역량은 빠르게 무너진다. 면책성 조언 문구는 정밀한 판별력을 대체할 수 없다. 범용 모델은 방어적인 대화 템플릿으로 표면적 장벽을 둘렀을 뿐, 내부 깊숙한 곳에는 진짜 병리학적 시각 판별력이 부재한 상태다.
소표본 한계 인정 속에서 의료 현장이 얻어야 할 교훈
이번 실험 결과는 시사하는 바가 크지만, 린치 박사는 연구의 한계점 또한 솔직하게 짚었다. 첫째는 표본 수의 제약이다. 테스트에 포함된 흑색종은 30건으로 통계적 신뢰구간이 다소 넓으며, 추론은 단 1회씩만 수행되었다. 둘째는 표본의 높은 난이도다. 200건 모두 생검을 거쳐야만 판별할 수 있었던 증례들로, 실제 임상에서도 숙련된 의사조차 육안만으로는 결정을 내리기 어려운 난치성 병변이었다. Inception v3조차 일반 ISIC 데이터셋에서는 AUROC 0.96을 기록했으나, 이번 고난도 데이터셋에서는 0.86으로 하락했다.
또한 MILK10k 데이터셋은 2025년부터 공개된 데이터이므로 범용 LLM이 사전 학습 과정에서 이미 접했을 가능성도 배제할 수 없다. 만약 데이터를 이미 본 상태에서도 42%의 정확도에 머물렀다면, 전문 시각 표현력의 빈곤함이 더욱 두드러지는 셈이다. 아울러 린치 박사는 Inception v3가 10년 전 구형 아키텍처일 뿐이며, 현재 규제 당국의 정식 승인을 획득한 상용 전문 의료 AI 시스템은 이보다 훨씬 뛰어난 성능을 보인다고 덧붙였다. 흥미롭게도 이번 연구의 통계 분석 스크립트 작성과 초고 정리에는 Anthropic의 코드 어시스턴트 도구가 활용되었다.
전문 의료 영상 분석은 특정 임상 현장의 시각적 사전 분포 없이는 성립할 수 없다. 범용 대형 모델은 환자와의 원활한 소통, 의무기록 요약, 초기 문진 접수 등에서는 압도적인 역량을 발휘할 것이다. 그러나 미세 병변의 생사를 가르는 감별 진단의 최전선에서는, 전문 임상 데이터로 단련된 특화 소형 모델이 의료 안전을 지키는 든든한 방파제 역할을 계속 맡아야 한다.
참고 링크:
- Lynch Lab 리포트: LLMs Fall Short of Old CNN in Dermoscopy
- Hacker News 커뮤니티 기술 토론