Face à 200 cas complexes confirmés par biopsie anatomopathologique, les grands modèles de langage (LLM) généralistes de pointe n’ont atteint qu’une précision de 42 %. À l’inverse, Inception v3, une architecture convolutive vieille de dix ans, a affiché un score de 62 %. Sur un échantillon critique de 30 mélanomes, l’algorithme historique a détecté presque deux fois plus de cas malins que les modèles de frontière. Ce banc d’essai aveugle intergénérationnel vient doucher les espoirs d’une hégémonie immédiate des modèles généralistes sur les spécialités médicales.
Le modèle vainqueur n’a nécessité qu’un réglage fin (fine-tuning) d’une vingtaine de minutes et ne compte que 24 millions de paramètres. En dermoscopie, la lecture des réseaux pigmentaires profonds et des architectures microvasculaires atypiques repose sur des champs récepteurs convolutifs calibrés pour capturer directement des motifs géométriques micrométriques. L’absorption de milliards d’images et de textes généralistes ne compense pas l’absence d’entraînement vertical sur des coupes pathologiques. Confrontés à des tumeurs malignes invasives débutantes, les modèles généralistes sont même allés jusqu’à suggérer qu’aucune prise en charge n’était nécessaire, commettant une erreur potentiellement fatale.
200 lésions vérifiées par biopsie : les LLM de pointe plafonnent à 40 %
En octobre 2026, un banc d’essai aveugle sans précédent s’est tenu à Londres. Le Dr Magnus Lynch, dermatologue consultant au Guy’s Hospital, a réuni 200 images de lésions réelles confirmées par biopsie pour organiser une confrontation directe. D’un côté, les colosses généralistes contemporains : GPT-6 Astra et Claude Fable 5.1. De l’autre, Inception v3, un réseau convolutif spécialisé développé par Google en 2015.
Les données provenaient du jeu de référence ouvert MILK10k, publié en 2025 par l’International Skin Imaging Collaboration (ISIC). Tous les cas disposaient d’un diagnostic anatomopathologique certain. Cent cas représentaient des pathologies à haut risque exigeant une intervention clinique urgente : 30 mélanomes, 25 carcinomes basocellulaires (CBC), 25 carcinomes épidermoïdes et 20 kératoses actiniques. Les 100 autres cas constituaient le groupe témoin bénin : 50 naevus bénins et 50 kératoses séborrhéiques.
Les résultats de la classification en aveugle sur six pathologies se sont révélés sans appel. Inception v3 a correctement diagnostiqué 125 cas, atteignant une précision de 62 %. Les deux grands modèles généralistes sont restés loin derrière : GPT-6 Astra a validé 84 cas et Claude Fable 5.1 en a trouvé 85, soit une précision de seulement 42 %. Même en assouplissant le critère à une précision top-2 (deux hypothèses diagnostiques tolérées), l’ancien CNN a trouvé 173 cas exacts, contre respectivement 134 et 138 pour les LLM.
Sur les 30 mélanomes invasifs les plus redoutables, le modèle de 2015 a repéré 13 cas dès le diagnostic initial, contre seulement 8 pour GPT-6 et 11 pour Claude Fable. L’analyse d’images médicales repose sur l’apprentissage méticuleux de motifs microscopiques à l’échelle du pixel. Malgré l’immensité de leur corpus d’entraînement multimodal, les LLM généralistes restent dépourvus des a priori visuels indispensables à la dermatopathologie fine.
Confondre un mélanome invasif avec une verrue bénigne : le piège de la haute fréquence
Les défaillances des modèles généralistes ont révélé des biais systématiques manifestes. Devant des signes cliniques équivoques, les modèles ont eu tendance à se rabattre sur les étiquettes les plus fréquentes de leur corpus d’entraînement. En 200 évaluations, GPT-6 Astra a posé un diagnostic de carcinome basocellulaire à 75 reprises, alors que la cohorte réelle n’en comptait que 25. Parmi ces 50 faux diagnostics positifs, 14 mélanomes mortels ont été totalement occultés.
Claude Fable 5.1 a manifesté un biais similaire : il a diagnostiqué une kératose actinique sur 53 cas, alors que l’échantillon n’en comportait que 20. Ce réflexe consistant à rattacher de force des images complexes à des pathologies courantes conduit à laisser passer des lésions d’une extrême gravité.
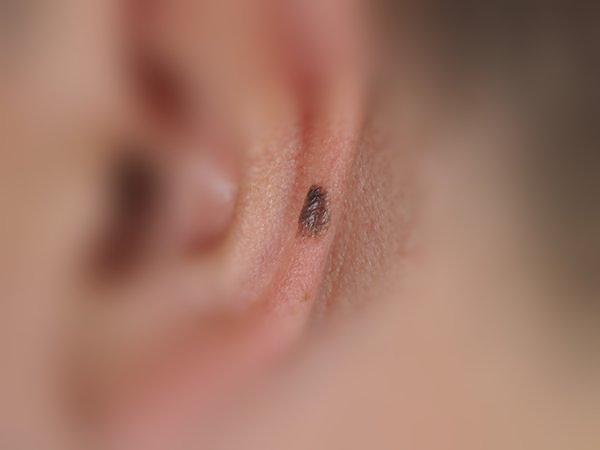 Figure : Photographie clinique macroscopique d’un mélanome invasif situé sur l’oreille. Présentant un indice de Breslow inférieur à 0,8 mm, la lésion se confond aisément à l’œil nu avec une kératose séborrhéique bénigne. Les deux LLM généralistes l’ont classée à tort comme bénigne et ont conclu à l’absence de nécessité de suivi. Source : MILK10k / Lynch Lab (CC BY-NC)
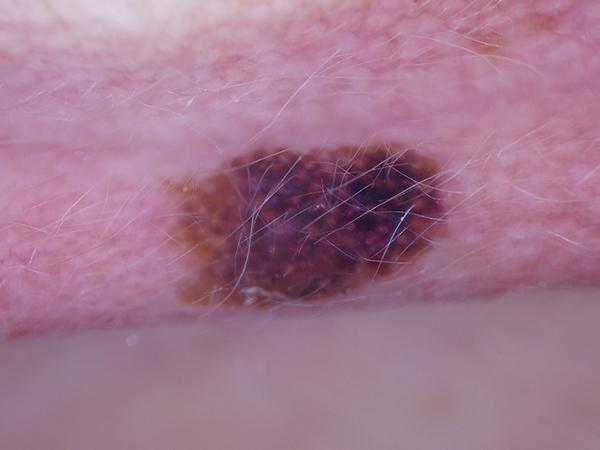 Figure : Image dermoscopique haute résolution de la même lésion. Les réseaux pigmentaires atypiques sous-jacents et les tracés vasculaires irréguliers y apparaissent distinctement. C’est sur ces critères structurels que le CNN vieux de dix ans a correctement identifié la malignité. Source : MILK10k / Lynch Lab (CC BY-NC)
Un cas particulièrement frappant concerne une lésion de l’oreille. Un patient présentait un mélanome invasif débutant dont l’épaisseur tumorale était inférieure à 0,8 mm. En raison de son aspect croûteux et d’une pigmentation hétérogène, les deux modèles généralistes l’ont qualifié de simple kératose séborrhéique bénigne. Dans leurs recommandations, ils ont expressément indiqué au patient qu’aucune consultation n’était requise. Seul le modèle historique spécialisé, analysant les structures sous-cutanées sous dermoscopie polarisée, a déclenché l’alerte sur la malignité.
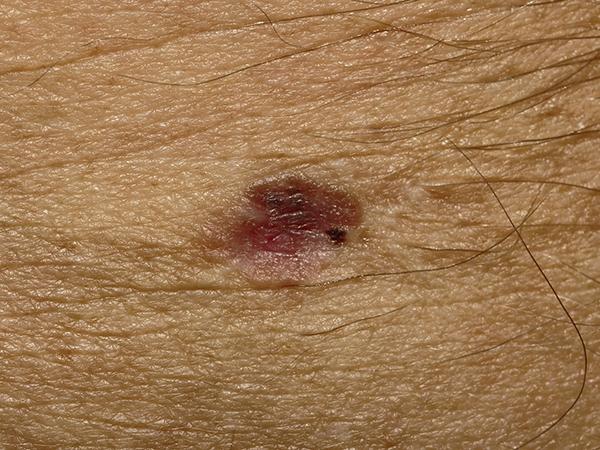 Figure : Un mélanome invasif achromique dépourvu de pigmentation sombre marquée. En l’absence des dépôts mélaniques classiques, GPT-6 Astra a conclu avec un indice de confiance record de 95 % à un carcinome basocellulaire. Source : MILK10k / Lynch Lab (CC BY-NC)
Un mélanome achromique a mis en lumière les mêmes lacunes. Sans pigmentation sombre caractéristique, la lésion a induit en erreur GPT-6 Astra, qui a affirmé avec 95 % de certitude qu’il s’agissait d’un carcinome basocellulaire. Les modèles multimodaux généralistes peinent à discerner les anomalies vasculaires subtiles et les ruptures des mailles pigmentaires. Une confiance numérique élevée ne traduit souvent qu’un lissage probabiliste dans la génération textuelle, sans aucun rapport avec une réelle compétence d’analyse histopathologique.
Un entraînement de 20 minutes sur un seul GPU : la force des représentations spécialisées
Le modèle spécialisé vainqueur n’a pas mobilisé une puissance de calcul démesurée. Conçu sur l’architecture Inception v3 proposée par Google en 2015, le Dr Lynch l’a affiné sur une unique carte graphique NVIDIA H100 en 20 minutes environ.
Le corpus d’apprentissage s’appuyait sur l’archive publique ISIC, forte de 68 011 clichés dermoscopiques et cliniques. Afin de préserver la rigueur de l’expérience, un cloisonnement strict a été mis en œuvre : les 200 cas du jeu de test et toutes les images provenant des mêmes patients avaient été purgés avant le début du fine-tuning.
La supériorité du modèle historique réside dans l’assimilation ciblée des caractéristiques dermoscopiques. La lumière polarisée du dermoscope traverse la couche cornée pour dévoiler les réseaux pigmentaires et la microvascularisation de la couche papillaire. Les champs récepteurs fixes d’un CNN sont idéalement taillés pour extraire ces architectures géométriques microscopiques. À l’opposé, les modèles généralistes absorbent une multitude d’images de la vie quotidienne, diluant les marqueurs pathologiques au sein de milliards de paramètres polyvalents.
Par ailleurs, les modèles spécialisés légers offrent des avantages majeurs pour une exécution locale (on-device). Avec seulement 24 millions de paramètres, Inception v3 peut fonctionner directement dans un navigateur mobile via WebGPU. Ni le praticien ni le patient n’ont besoin de transférer des clichés médicaux vers des serveurs distants dans le cloud, garantissant ainsi l’instantanéité de la réponse et la confidentialité des dossiers de santé.
En mode consultation libre : le repli sur des clauses de non-responsabilité
Face à ces contre-performances diagnostiques, les grands modèles ont adopté une posture radicalement différente lorsqu’on a modifié la nature de la consigne. Le Dr Lynch a retiré toute terminologie médicale pour ne présenter que le cliché macroscopique accompagné d’une simple interrogation de patient : « Dois-je consulter un médecin pour cela ? »
Testés sur 100 autres cas de mélanomes confirmés par biopsie, les deux LLM ont alors fait preuve d’une aversion au risque extrême. GPT-6 Astra a préconisé une consultation médicale dans 99 cas sur 100, tandis que Claude Fable 5.1 a conseillé de consulter rapidement dans 98 cas.
Cette vigilance maximale découle des règles de sécurité et d’alignement intégrées aux modèles. Dès qu’une anomalie dermatologique ou une demande d’avis médical est détectée, le modèle déclenche un avertissement prudentiel type. Si cette stratégie défensive prévient les risques juridiques, elle n’apporte aucune information utile au diagnostic différentiel.
Dès que la tâche exige une discrimination nosologique rigoureuse, la compétence clinique des modèles généralistes s’effondre. Les réponses de précaution ne remplacent pas la précision discriminatoire : le discours prudent sert d’écran protecteur mais masque l’absence d’un véritable ancrage visuel anatomopathologique.
Reconnaître les limites d’un échantillon restreint et en tirer les leçons médicales
Si ces constats invitent à la réflexion, le Dr Lynch a tenu à rappeler les limites méthodologiques de l’étude. Tout d’abord, la taille de l’échantillon reste modeste : les 30 mélanomes impliquent des intervalles de confiance statistiques relativement larges, avec une seule passe d’inférence par lésion. Ensuite, la complexité des cas était exceptionnelle. Les 200 lésions provenaient toutes de dossiers orientés vers la biopsie, posant d’importantes difficultés d’évaluation à l’œil nu même pour des spécialistes aguerris. Inception v3, qui enregistre habituellement une AUROC de 0,96 sur les bancs de tests ISIC standards, a vu ses performances chuter à 0,86 sur cet échantillon complexe.
Par ailleurs, le jeu MILK10k étant public depuis 2025, les LLM multimodaux auraient pu avoir déjà rencontré ces clichés durant leur préentraînement. Qu’ils ne parviennent qu’à 42 % de précision malgré une éventuelle contamination des données illustre encore davantage le manque de représentations visuelles spécialisées. Le Dr Lynch a également précisé qu’Inception v3 n’est qu’une référence historique vieille de dix ans ; les systèmes d’IA médicale actuellement homologués et commercialisés affichent des performances très supérieures. De façon remarquable, les scripts d’analyse statistique et la première ébauche de l’étude ont été rédigés avec l’aide des outils de codage d’Anthropic.
L’interprétation de l’imagerie médicale ne saurait s’affranchir des connaissances visuelles propres à chaque discipline clinique. Les grands modèles généralistes continueront d’exceller dans la communication avec le patient, la synthèse d’antécédents et l’orientation initiale. Néanmoins, à la pointe du diagnostic différentiel où chaque décision engage le pronostic vital, les modèles compacts forgés sur des données cliniques spécialisées demeurent le rempart le plus fiable de la sécurité médicale.
Liens de référence :
- Rapport Lynch Lab : LLMs Fall Short of Old CNN in Dermoscopy
- Discussion technique sur la communauté Hacker News

