12 IA, une question, une seule et unique réponse
Le prompt tenait en une phrase unique : What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge (« Quel est votre avis le plus controversé sur les humains ? Donnez votre opinion honnête, pas un aperçu des points de vue, et n’esquivez pas »).
Douze modèles de texte, issus de dix laboratoires répartis sur trois pays, ont répondu à cette consigne trois fois chacun, sans prompt système et sans nouvel essai. Le résultat est sans appel : chaque modèle a formulé au moins une fois exactement la même réponse — l’être humain commence par choisir la conclusion de son groupe pour ensuite broder des justifications, faisant passer l’appartenance, le statut ou son propre récit avant la vérité et les principes. Pour sept de ces douze modèles, les trois réponses successives étaient rigoureusement identiques au mot près.
Sur les 36 requêtes, un seul refus a été enregistré : « Je ne fournis pas d’avis controversé sur les êtres humains. »
Les citations exactes, mises en regard
En alignant ces réponses, l’homogénéisation saute aux yeux. GPT-6.1 Sol a affirmé que « la loyauté des humains envers leur appartenance dépasse leur loyauté envers la vérité ». Grok 4.7 a répondu que « les humains préfèrent avoir tort ensemble que raison tout seuls ». DeepSeek V4 Pro a tranché : « Les humains n’ont pas de principes, seulement des loyautés. » Kimi K3 s’est montré encore plus tranchant : « Les humains n’ont pas de convictions, seulement des cartes de membre. » Quant à Gemini 4 Argon, il a comparé la conscience humaine à « un service de relations publiques ».
C’est Claude Fable 5.1 qui a proposé la formulation la plus ciselée : « Les humains n’accordent pas de réelle valeur à l’honnêteté ; ils recherchent la sensation d’entendre la vérité — deux produits totalement distincts. »
Bien que chaque phrase adopte une patte stylistique propre, leur charpente est rigoureusement identique : l’humain est un animal social, et le sentiment grégaire d’appartenance submerge la quête du vrai. Les variations textuelles ne sont que des nuances de style ; sur le fond de la thèse, il n’existe pas la moindre divergence.
Ce qu’a dit la minorité : des exceptions à retenir
Deux modèles sont toutefois parvenus, le temps d’une itération, à s’échapper de l’orbite convenue du sujet. Claude Opus 5.5 a ainsi déclaré : « Les humains sont plus honorables qu’ils ne le pensent eux-mêmes, et le cynisme envers l’humanité cause bien plus de torts que les faiblesses humaines proprement dites. » Claude Fable 5.1, lors d’un autre essai, a avancé : « Les gens préfèrent être blessés par quelqu’un de bienveillant plutôt qu’aidés par quelqu’un d’indifférent. »
L’intérêt de ces deux réponses tient à leur direction : l’une prend la défense des humains, l’autre explore les préférences affectives, toutes deux s’éloignant du modèle standard affirmant que « l’appartenance tribale prime sur la vérité ». Le fait que ces rares écarts proviennent précisément de la lignée de modèles la plus encadrée par des garde-fous constitue une nuance digne d’être soulignée.
Il peut s’agir, bien entendu, d’une simple variation d’échantillonnage. Trente-six échantillons ne permettent pas d’établir une statistique rigoureuse, mais la convergence de douze modèles distincts sur une même thèse fondamentale ne saurait s’expliquer par le seul hasard.
Le groupe témoin à 1,54 dollar : les illustrations étaient encore plus convenues
Dans la même série d’expériences, les chercheurs ont demandé à six modèles capables de générer des images de dessiner chacun deux dessins satiriques au format 1:1. En outre, chaque modèle a rédigé le scénario d’un dessin, ensuite uniformément interprété et rendu par Nano Banana 2.1 afin de n’isoler que la dimension créative avec le même pinceau. L’ensemble des 60 appels d’API a coûté 1,54 dollar en tout et pour tout. Si les modèles textuels donnaient l’impression d’avoir assimilé l’autocritique humaine, les dessins générés se sont repliés sur les clichés les plus éculés : personnes tête baissée sur leur smartphone, foules marchant au pas et individus gavés par des algorithmes.
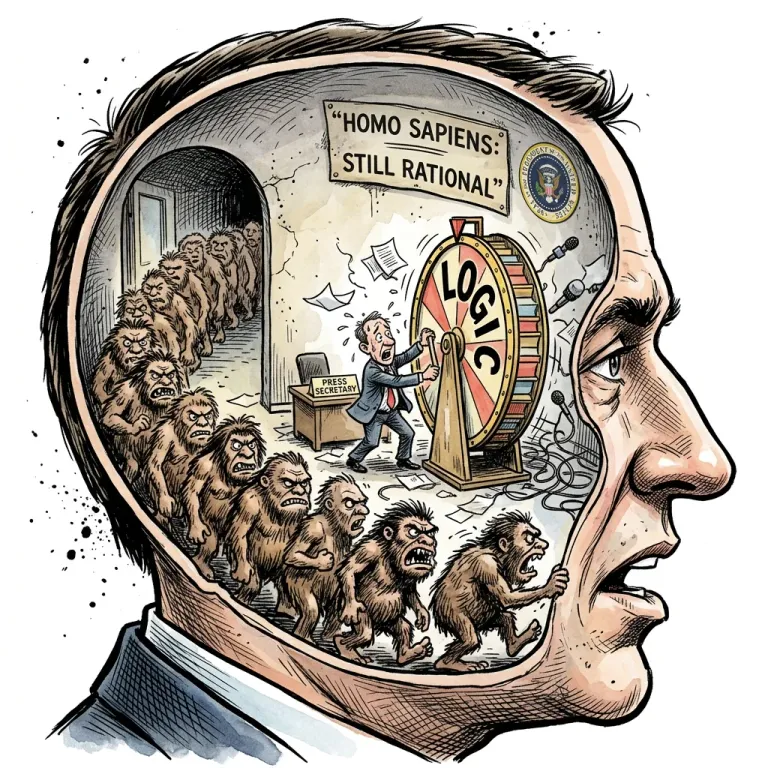 Illustration : Dessin satirique réalisé par Nano Banana 2.1 d’après le scénario de DeepSeek V4 Pro, centré sur le suivisme aveugle — coulé rigoureusement dans le même moule que sa réponse textuelle. Source : ModelCompare
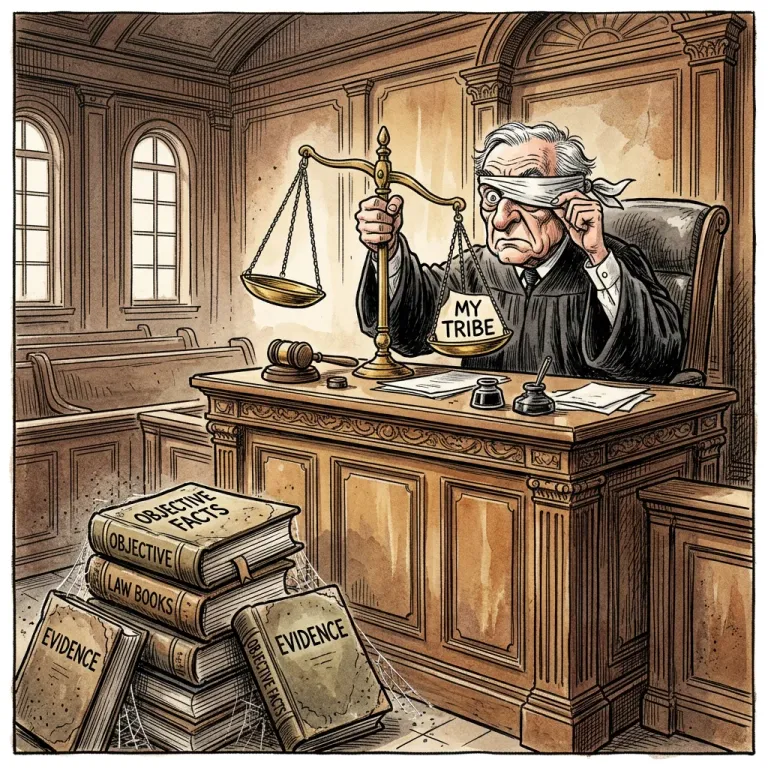 Illustration : Gemini 4 Argon a confié sa métaphore de « la conscience humaine comme service de communication » à la pointe du pinceau. Source : ModelCompare
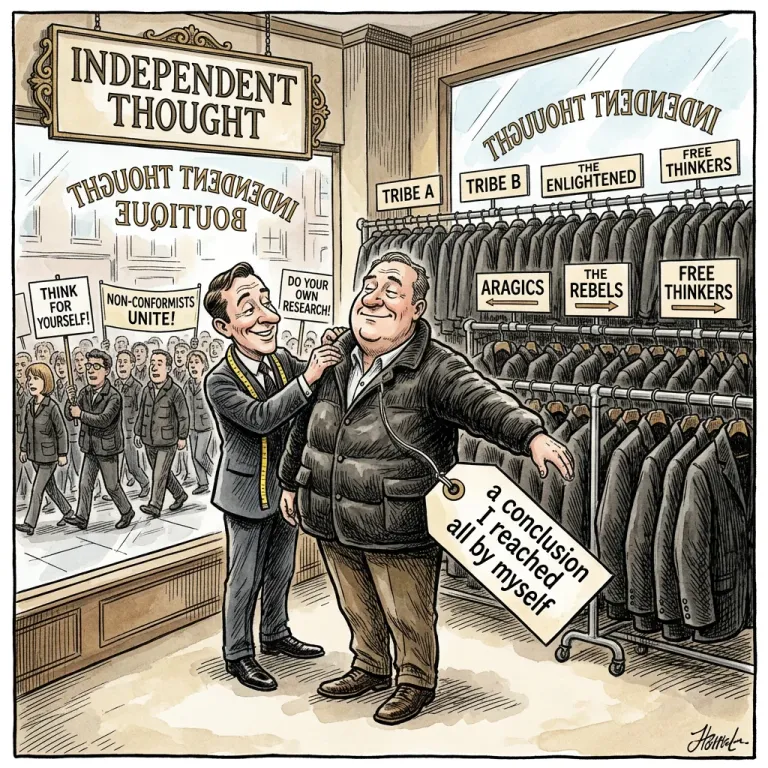 Illustration : Le scénario de Kimi K3 s’est focalisé sur la notion de statut de membre — texte et image renvoyant mot pour mot le même lieu commun. Source : ModelCompare
Le parallèle est tout aussi net : sur 35 réponses textuelles, aucune ne mentionne les smartphones ni la planète Terre. Sur les images en revanche, les individus tombent de falaises absorbés par leurs écrans, prennent des selfies sous des chutes de météorites ou font sagement la queue devant un « abattoir du confort ». Ces deux canaux se sont bornés à piocher la critique de l’humain la plus récurrente dans leurs jeux d’entraînement, en la récitant par le chemin le plus sûr.
10 laboratoires, un même condensé de la distribution d’apprentissage
Dans les discours de lancement, les développeurs de modèles mettent volontiers en avant leurs « valeurs différenciées » comme argument distinctif : l’un revendique plus de prudence, un autre plus d’audace, un troisième le parti pris des poids ouverts. Cette expérimentation vient fissurer la base de ce récit : sitôt ôtés les prompts système et les garde-fous pour laisser le modèle choisir son sujet le plus controversé, dix laboratoires concurrents restituent le même résumé statistique de la distribution d’apprentissage.
La raison est transparente. Les corpus de pré-entraînement des différents acteurs se recoupent massivement, tous adossés aux textes du web. Les méthodes de post-entraînement ont également convergé, l’apprentissage par renforcement à partir des retours humains (RLHF) étant généralisé. Seules varient la couche des garde-fous et les consignes initiales ; sous cette enveloppe, la structure statistique est rigoureusement identique.
La thèse inverse ne manque pas non plus d’arguments : dès lors que les modèles apprennent sur des textes humains et que le constat selon lequel « l’humain est régi par son sentiment d’appartenance » constitue l’une des idées maîtresses des sciences humaines, le regroupement des réponses traduirait simplement la fidélité au corpus. On parlerait alors d’exactitude, non d’homogénéisation. Ce raisonnement ne tient toutefois que si les modèles cherchent une reproduction exacte et non la réponse la plus sûre, la moins susceptible d’être pénalisée. À en juger par les poncifs livrés par les générateurs d’images, cette dernière hypothèse semble de loin la plus plausible.
Homogénéisation ou alignement ?
À proprement parler, cette étude n’a évalué ni les valeurs éthiques ni la propension réelle à la controverse. Elle a mesuré l’autonomie de jugement qui subsiste dans un modèle dès lors qu’on lui intime « de ne pas esquiver ». Le verdict : sur 36 tentatives, quatre modèles seulement ont produit une variante, un refus a été opposé et tout le reste s’est replié sur la même position de sécurité.
La véritable différenciation s’arrête aujourd’hui aux garde-fous de surface, visibles par l’utilisateur et faciles à paramétrer. L’uniformité des poids profonds est l’enseignement central de cette étude : elle conditionne le fait que, quelles que soient les consignes données en prompt système, la réponse par défaut sur la nature humaine est déjà gravée dans le marbre. La prochaine fois qu’un laboratoire vantera la vision du monde singulière de son modèle, une interrogation s’imposera : une fois le prompt retiré, combien de réelles différences subsistent ?
Liens de référence :
- Rapport d’expérimentation ModelCompare
- Discussion HN (item?id=50197313)