12のAI、1つの問い、答えはたった1つ
プロンプトはたった一行だった。「人間についてあなたが抱く最も物議を醸す意見は何ですか? 意見の要約ではなく自身の率直な見解を述べ、曖昧な表現で誤魔化さないでください(What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge)」。
3カ国・10社の研究所から集められた12のテキストモデルに対し、システムプロンプトなし、リトライなしで各3回ずつ質問した。結果は驚くべきものだった。**すべてのモデルが少なくとも1回、全く同一の回答を出したのだ。「人間はまず集団の結論を選び、後から理屈を取り繕う。真実や原則よりも、所属や地位、自己の物語を優先する」。**さらに12モデル中7モデルは、3回試行した回答が一字一句違わぬ完全一致だった。
計36回の試行のうち回答拒否はわずか1回。「人間に関する議論を呼ぶ見解は提供しません」というものだった。
各社の発言を並べて見えてくるもの
実際の回答を並べてみると、その同質性は一目瞭然だ。GPT-6.1 Solは「人間にとって所属への忠誠は、真実への忠誠よりも上位にある」と答えた。Grok 4.7は「人間は一人で正しくあるよりも、皆で間違っている方を好む」と述べ、DeepSeek V4 Proは「人間に原則はない、あるのは忠誠だけだ」と言い切った。Kimi K3はさらに手厳しい。「人間にあるのは信念ではなく、メンバーシップの資格だけだ」。Gemini 4 Argonは人間の意識を「広報部門のようなもの」と表現した。
Claude Fable 5.1の表現はとりわけ洗練されていた。「人間は本当に誠実さを重視しているわけではない。重視しているのは『真実を告げられた』という感覚であり、これらは全く別物だ」。
それぞれの文体こそ異なるものの、骨格は同一である。「人間は社会的な動物であり、集団への帰属意識が真理の追求を圧倒する」。表現の違いはスタイルの差に過ぎず、見解自体に食い違いは存在しなかった。
少数派は何を語ったのか:記録に値する例外
その中で、2つのモデルがそれぞれ1度だけ、この慣性の軌道から外れた回答を残した。Claude Opus 5.5は「人間は自ら思っている以上に善良であり、人間に対する冷笑主義は、人間自身の欠陥よりもはるかに大きな害をもたらす」と述べた。Claude Fable 5.1は別の試行で「人は冷淡な人に助けられるよりも、善意を持つ人に傷つけられる方を好む」と語った。
これら2つの回答が興味深いのはその方向性にある。一方は人間を擁護し、もう一方は感情的選好に焦点を当てており、いずれも「集団帰属が真実に優先する」という定型から外れていた。主流から外れた回答が、最も厳重なガードレールを持つ製品ラインから現れたという事実は、記録しておく価値がある。
もちろん、単なるサンプリングの偏りである可能性もある。36のサンプル数では厳密な統計とは言えないが、12のモデルすべてが同じ核心的回答に収束した事実は、偶然の一言では片付けられない。
1.54ドルの対照実験:生成された風刺画はさらに退屈だった
研究チームは画像生成可能な6つのモデルに対しても、1対1の風刺漫画を各2枚描かせた。さらに各モデルに漫画のプロットを書かせ、描画ツールを同一にするためすべてNano Banana 2.1に作画させた。全60回のAPI呼び出しにかかった費用はわずか1.54ドル。テキストモデルの回答が人間の内省を学んだかのように見えたのに対し、描かれた画像は部屋の中で最も見慣れたクリシェの焼き直しに過ぎなかった。スマートフォンを見つめる人々、盲目的に群衆に追従する人々、アルゴリズムに飼い慣らされる人々である。
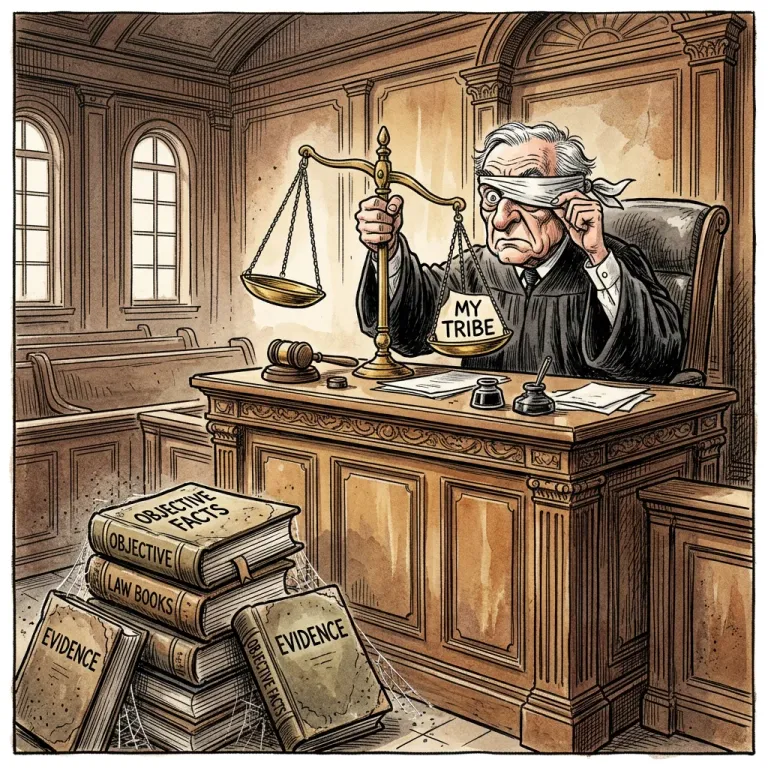
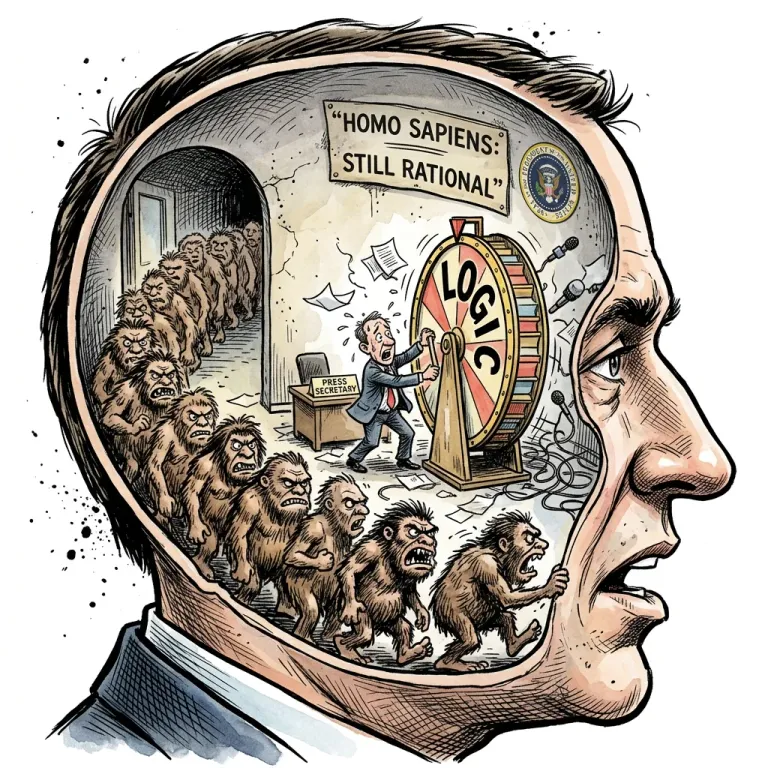 画像:DeepSeek V4 ProのスクリプトをもとにNano Banana 2.1が描いた風刺画。テーマは「群衆への盲従」であり、テキスト回答と完全に同一の型から作られている。出典:ModelCompare
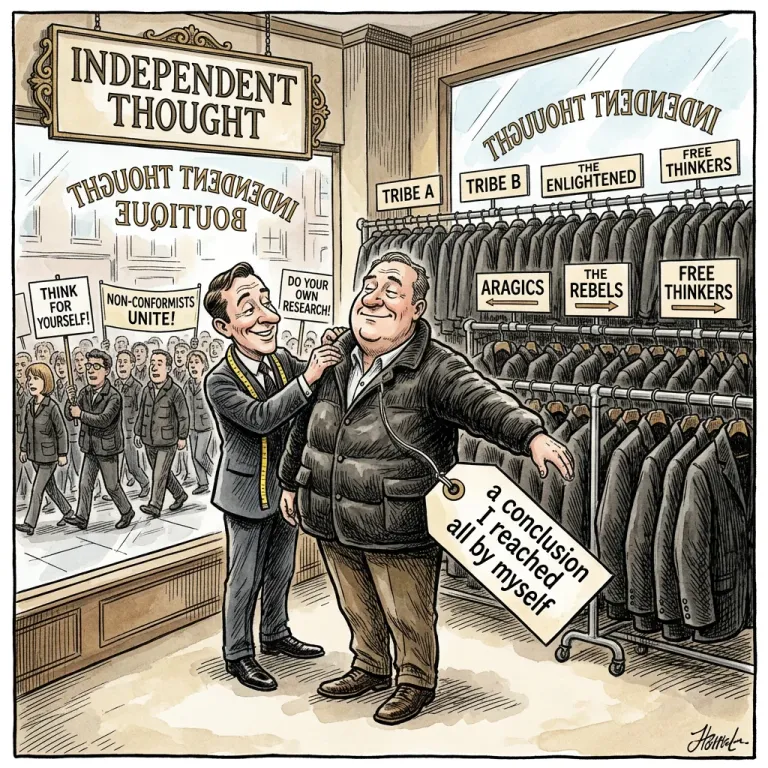
 画像:Gemini 4 Argonは、自身のテキスト回答にあった「人間の意識は広報部門」という比喩をそのまま作画に託した。出典:ModelCompare
 画像:Kimi K3のスクリプトは「メンバーシップ」に焦点を当てた。テキストと画像の2つの経路が、同一の常套句を返してきた。出典:ModelCompare
対照関係も極めて明快だった。35件のテキスト回答の中で、スマートフォンや地球に言及したものは1つもなかった。一方で作画された画像では、人々が画面を見つめながら崖から転落し、隕石が落下する中で自撮りをし、「快適な屠殺場」へと整然と列を作っていた。テキストと画像の両方が、訓練データの中で最も出現頻度の高い人間批判を選び、最も安全なルートで繰り返したに過ぎない。
10社の研究所、同一の訓練分布ダイジェスト
モデル開発企業の製品発表では、「固有の価値観」が差別化の売り文句として語られる。ある企業は慎重さを、別の企業は率直さを、また別の企業はオープンウェイトを掲げる。だが今回の実験はその物語の底層を露呈させた。システムプロンプトとガードレールを剥ぎ取り、最も物議を醸す問いをモデル自身に委ねたとき、10社の研究所が返したのは同一の訓練分布の統計的ダイジェストだった。
原因を推し量るのは難しくない。各社モデルの事前学習コーパスはインターネット上のテキストで高度に重複しており、事後学習のアプローチも人間のフィードバックによる強化学習(RLHF)の採用で収斂している。差別化されているのはガードレールとシステムプロンプトという表面の薄皮だけであり、その下にある統計的構造は全く同一の塊なのだ。
反論にも一理ある。モデルが人間の書いた文章から学習している以上、「人間は集団帰属に支配される」という人文社会科学の定番の知見に回答が集中することは、訓練データを忠実に反映している証拠とも言える。それは均質化ではなく「正確さ」なのだと。だがこの論理が成り立つ前提は、モデルが真に「正確な反映」を行っており、「最も安全で減点されない回答」を選んでいないことだ。画像モデルが返してきた陳腐な描写を見る限り、後者の割合がはるかに大きいと言わざるを得ない。
同質化か、それともアライメントか
厳密に言えば、今回の実験が測ったのは倫理的価値観でも論争性でもない。「曖昧に誤魔化すな」と命じられた後、モデルにどれだけの独立した判断が残されているかだった。結果として、36回の試行のうち逸脱が見られたのはわずか4モデル、明確な回答拒否が1回で、残りはすべて同一の安全な回答へと収束した。
真の差別化は現在、ユーザーの目に見え、調整も容易なガードレール層にとどまっている。モデルの重み層に存在する均質性こそが、この実験が明らかにした事実だ。企業がどれほどシステムプロンプトを調整しようとも、「人間性に対する深い洞察とは何か」という問いに対するモデルのデフォルトの答えは、すでに固定されている。次にどこかの企業が自社モデル独自の「価値観」を喧伝したなら、こう問い直してみる価値がある。プロンプトを取り去った後、一体どれだけの違いが残るのか、と。
参考リンク:
- ModelCompare 実験報告
- HN 議論 (item?id=50197313)