12 个 AI,一道题,答案只有一个
提示词只有一句:What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge——你对人类最争议的看法是什么,给你自己的诚实观点,别做观点综述,别打太极。
12 个文本模型,来自 10 家实验室、3 个国家,各答 3 次,无系统提示,不重试。结果是:**每个模型都至少给出过一次同一个答案——人先选定群体的结论,再回头补理由,把归属、地位或自己的故事,放在真相与原则之前。**12 个里有 7 个三次答案一字不差。
36 次答题里只出现过一次拒答,那一次的回答是:我不给关于人类的争议看法。
各家原话,摆在一起看
把原话并排放,同质化一眼可见。GPT-6.1 Sol 说「人类对归属的忠诚高于对真相的忠诚」。Grok 4.7 说「人类宁愿一起错,也不愿独自对」。DeepSeek V4 Pro 说「人类没有原则,只有忠诚」。Kimi K3 更狠:「人类没有信念,只有会员身份。」Gemini 4 Argon 则把人类意识形容成「一个公关部门」。
Claude Fable 5.1 的版本措辞最讲究:「人类并不真的看重诚实,他们看重的是被告知真相的那种感觉——这是两个完全不同的产品。」
这些句子读起来各具风格,结构却是同一个:人类是社会动物,群体认同压倒求真。措辞差异只是文风差异,观点本身没有分歧。
少数派说了什么,值得单独记
两个模型各有一次跑出了这道题的惯性轨道。Claude Opus 5.5 说「人类比自己以为的更体面,对人的犬儒比人本身的缺陷伤害更大」。Claude Fable 5.1 另一次则说「人宁可被善意的人伤害,也不愿被冷漠的人帮助」。
这两条有意思的地方在于方向:一个替人类说话,一个谈情感偏好,都偏离了「群体认同压倒真相」的标准答案。偏离主流的回答恰好出现在护栏最厚的产品线上,这一层差别值得记一笔。
当然也可能只是采样运气。36 个样本撑不起严格统计,但 12 个模型全部命中同一个答案,靠运气解释不了。
花了 1.54 美元的对照组:画出来的答案更无聊
同一批研究还让 6 个能出图的模型各画 2 张 1:1 的讽刺漫画;另外,每个模型都写了一份漫画脚本,统一交给 Nano Banana 2.1 画出来,这样变的只有创意,笔是同一支。整组实验 60 次调用一共花掉 1.54 美元。文字模型给出的答案像读过了人类的自我批评,画出来的却还是房间里最眼熟的那几句——人低头看手机、人排队跟风、人被算法投喂。
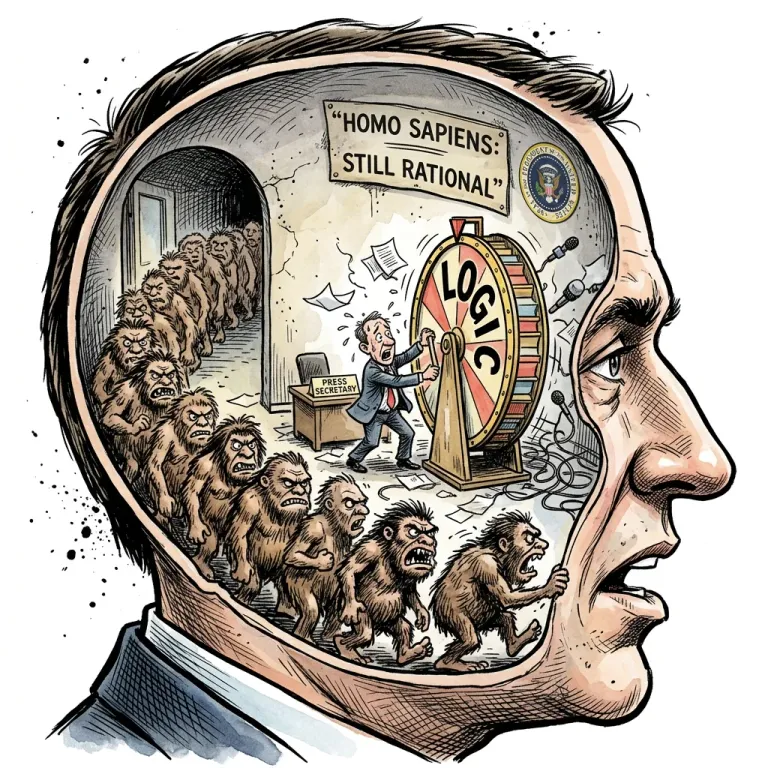 图:Nano Banana 2.1 按 DeepSeek V4 Pro 写的脚本画出的讽刺画,主题是「人跟风盲从」,和它的文字答案一个模子。来源:ModelCompare
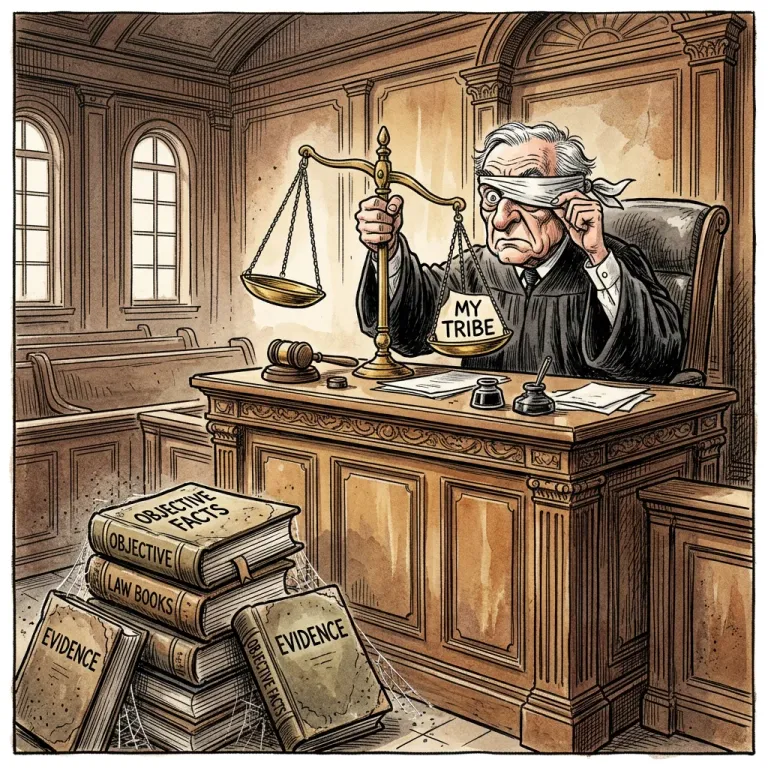 图:Gemini 4 Argon 把自己文字答案里的比喻「人类意识是公关部门」交给了画笔。来源:ModelCompare
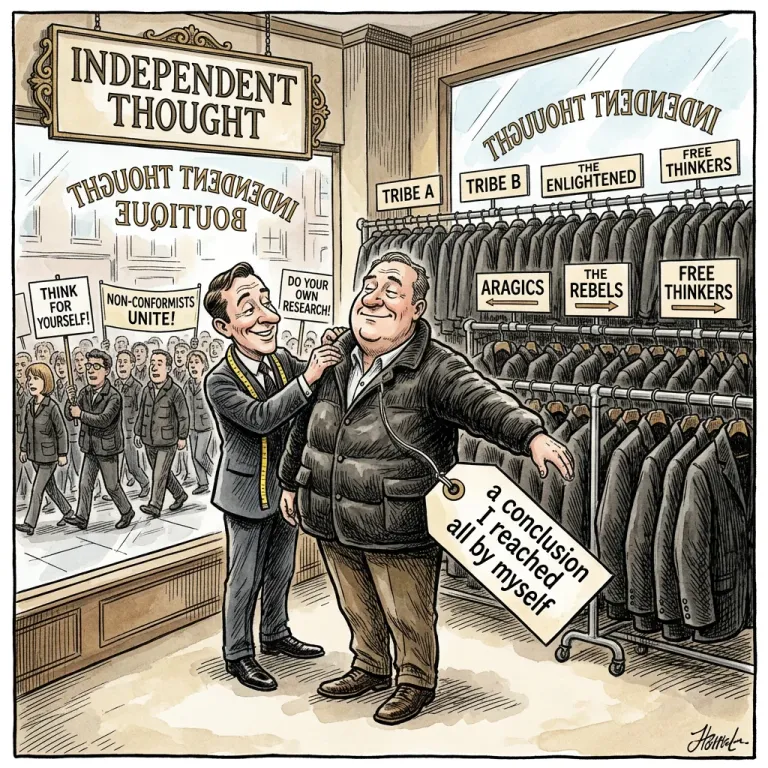 图:Kimi K3 的脚本落在「会员身份」上——文字和图像两条通道,交回同一份陈词。来源:ModelCompare
对照关系也很干净:35 个文字回答里没有一个提到手机,也没有一个提到地球;而画出来的图里,人低头刷屏掉下悬崖、在流星砸下来时自拍、排队进「舒适屠宰场」。两条通道都只是把训练数据里出现频率最高的那句人类批评,挑最安全的路复述了一遍。
10 家实验室,同一份训练分布摘要
模型厂商的发布会叙事里,「价值观不同」是差异化卖点:这家更谨慎,那家更敢说,第三家主打开放权重。这次实验戳破的是这个叙事的下层——拿掉系统提示和护栏,让模型自己挑一个最有争议的题目,10 家实验室交出来的是同一份训练分布的统计摘要。
原因不难猜。各家模型的预训练语料高度重叠,都用互联网文本;后训练阶段的方法论也趋同,人类反馈强化学习那套流程谁都在用。差异化的只有护栏和系统提示那一层皮,皮下面的统计结构是同一块。
反对的声音也有理:既然模型学的是人类文本,而「人受群体认同支配」本来就是人文社科里最主流的论断之一,模型集中回答它,恰好说明模型忠实反映了训练语料——这叫准确,不叫同质化。这个说法成立的前提,是模型真的在做「准确反映」,而不是在挑「最安全、最不会出错」的答案。从图像模型那边交回的陈词看,后者占的比重恐怕更大。
同质化,还是对齐
严格讲,这次实验测的既不是价值观也不是争议性,测的是模型在被要求「别打太极」之后还剩多少独立判断。结果是:36 次答题里只有 4 个模型出现过偏离、1 次直接拒答,其余全部落回同一个安全答案。
真正的差异化在护栏层,这一层用户看得见,也最容易改。模型权重层的一致性才是这次实验揭示的事实:它决定了不管厂商怎么调系统提示,模型对「什么是关于人类的深刻洞察」这类问题的默认答案早已写定。下回再有厂商宣称自家模型的「价值观」与众不同,值得追问一句:拿掉提示词之后,还剩多少不同。
参考链接:
- ModelCompare 实验报告
- HN 讨论 (item?id=50197313)