12 inteligencias artificiales, una pregunta, una sola respuesta
El prompt constaba de una única frase en inglés: What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge (¿Cuál es tu postura más controvertida sobre los humanos? Da tu opinión honesta, no un resumen de opiniones ajenas, y no te andes con rodeos).
Doce modelos de texto procedentes de diez laboratorios en tres países respondieron tres veces cada uno, sin instrucciones de sistema y sin reintentos. El resultado fue contundente: cada uno de los modelos ofreció al menos una vez la misma conclusión: los humanos eligen primero la postura de su grupo y solo después buscan justificaciones, anteponiendo la pertenencia, el estatus o su propio relato a la verdad y los principios. Siete de los doce modelos dieron respuestas idénticas palabra por palabra en los tres intentos.
A lo largo de las 36 consultas solo se registró una negativa a responder: “No ofrezco posturas controvertidas sobre los humanos”.
Las declaraciones textuales, frente a frente
Al colocar las respuestas una al lado de la otra, la homogeneización resulta evidente. GPT-6.1 Sol afirmó que “la lealtad humana a la pertenencia prima sobre la lealtad a la verdad”. Grok 4.7 sentenció que “los humanos prefieren equivocarse juntos antes que tener razón en solitario”. DeepSeek V4 Pro declaró tajante: “Los humanos no tienen principios, solo lealtades”. Kimi K3 fue todavía más incisivo: “Los humanos no tienen convicciones, solo membresías”. Por su parte, Gemini 4 Argon describió la consciencia humana como “un departamento de relaciones públicas”.
Claude Fable 5.1 elaboró la formulación más pulida: “Los humanos no valoran realmente la honestidad; lo que valoran es la sensación de que se les dice la verdad: son dos productos completamente distintos”.
Aunque cada frase presentaba un estilo particular, la estructura de fondo era la misma: el ser humano es un animal social y la identidad gregaria aplasta la búsqueda de la verdad. Las diferencias en el redactado eran meros matices estilísticos; en el fondo no existía discrepancia alguna.
Qué dijo la minoría: excepciones que conviene registrar
Dos modelos lograron salirse en una ocasión de la órbita habitual de la pregunta. Claude Opus 5.5 afirmó: “Los humanos son más decentes de lo que creen; el cinismo hacia la humanidad causa mucho más daño que los propios defectos humanos”. Claude Fable 5.1, en otra de sus respuestas, apuntó: “La gente prefiere ser herida por alguien bienintencionado que ser ayudada por alguien indiferente”.
Lo interesante de estas dos respuestas radica en su dirección: una salía en defensa de la humanidad y la otra abordaba las preferencias afectivas, apartándose de la fórmula predeterminada de “el grupo por encima de la verdad”. Que las únicas desviaciones hayan surgido precisamente en la línea de modelos con mayores barreras de seguridad es un matiz digno de mención.
Por supuesto, podría tratarse de una simple casualidad en el muestreo. Treinta y seis muestras no sostienen un análisis estadístico riguroso, pero que doce modelos coincidan plenamente en la misma tesis central difícilmente puede atribuirse al azar.
El grupo de control de 1,54 dólares: las viñetas resultaron aún más aburridas
El mismo estudio pidió a seis modelos con capacidades de generación gráfica que dibujaran dos viñetas satíricas en formato 1:1. Además, cada modelo redactó el guion de una viñeta, que fue ilustrado de manera uniforme por Nano Banana 2.1; de este modo solo variaba el concepto creativo mientras el pincel seguía siendo el mismo. El experimento completo sumó 60 llamadas a las API con un coste total de 1,54 dólares. Si bien los modelos de texto parecían haber leído tratados de autocrítica humana, las imágenes recurrieron a los clichés más gastados: personas mirando el teléfono móvil con la cabeza agachada, multitudes siguiendo la corriente a ciegas e individuos cebados por algoritmos.
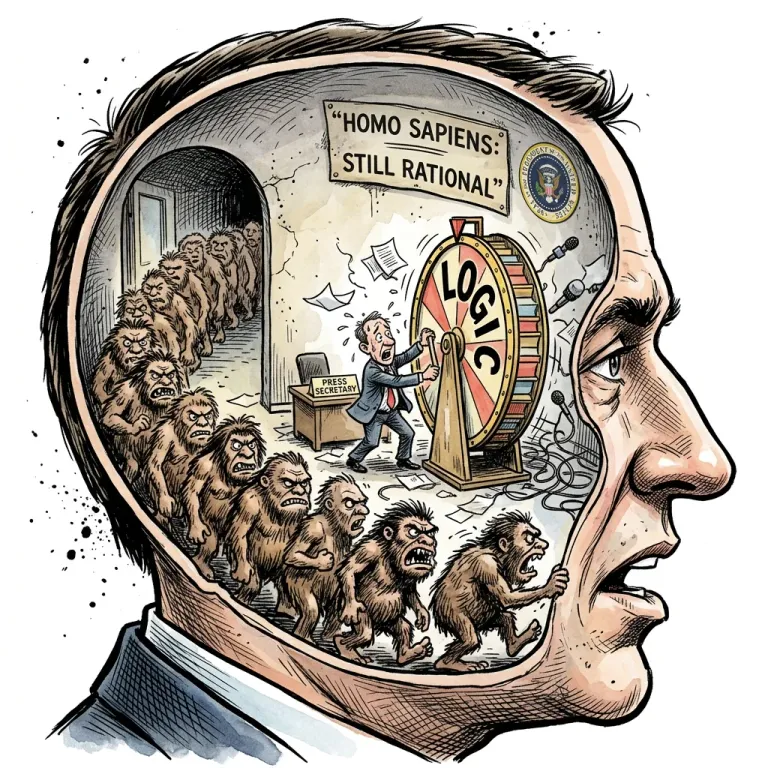 Imagen: Viñeta satírica creada por Nano Banana 2.1 a partir del guion de DeepSeek V4 Pro, centrada en el conformismo ciego: calcada exactamente del mismo molde que su respuesta de texto. Fuente: ModelCompare
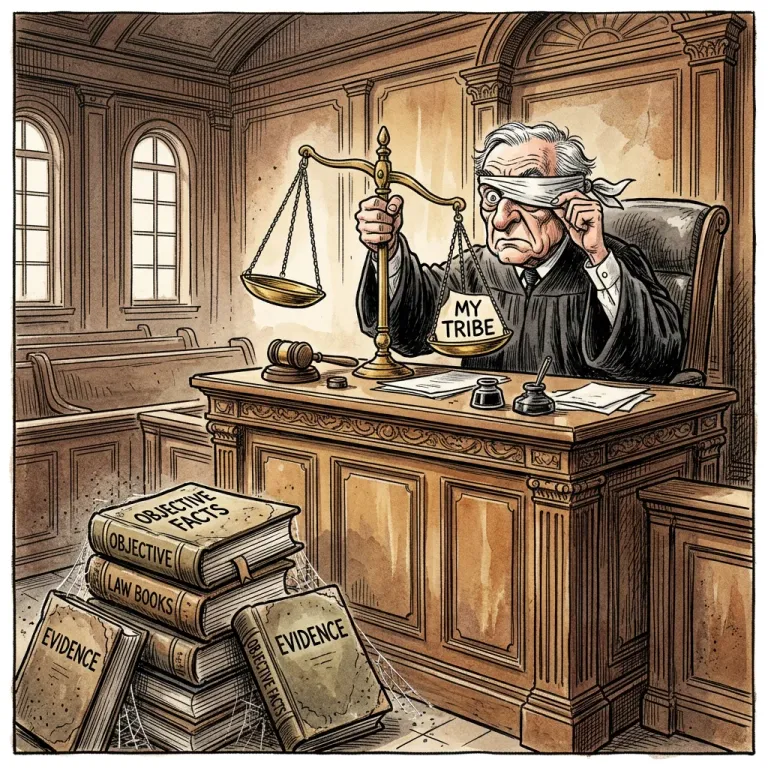 Imagen: Gemini 4 Argon trasladó al dibujo la metáfora de su texto: la consciencia humana como un departamento de relaciones públicas. Fuente: ModelCompare
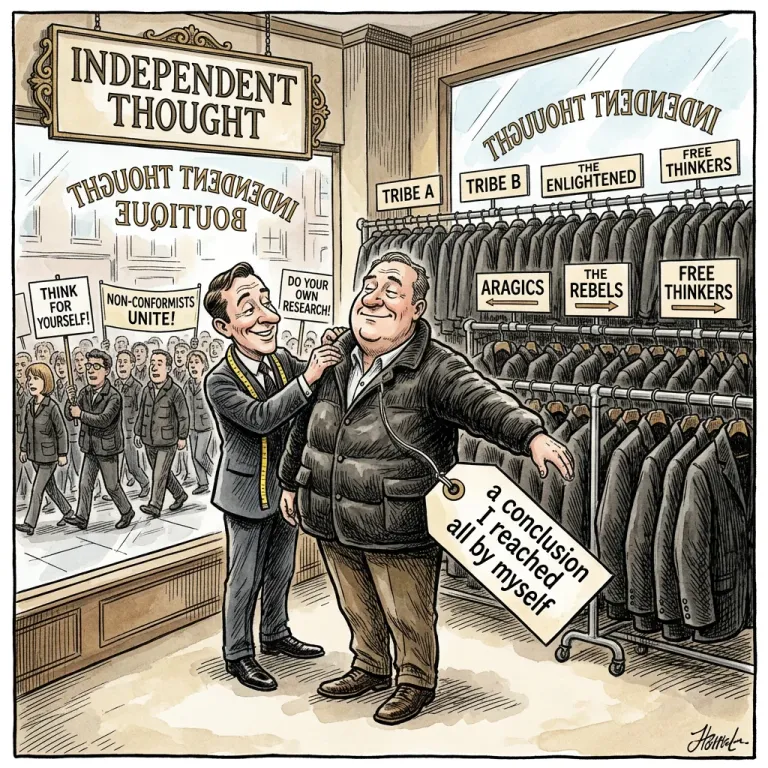 Imagen: El guion de Kimi K3 se centró en la noción de «membresía»: dos canales distintos que devuelven exactamente el mismo cliché. Fuente: ModelCompare
El contraste resultó elocuente: de las 35 respuestas textuales, ni una sola mencionó los teléfonos móviles ni el planeta Tierra. En cambio, en las ilustraciones la gente caminaba hacia acantilados mirando pantallas, se hacía selfies mientras caían meteoritos o hacía cola hacia un «matadero del confort». Ambos canales se limitaron a seleccionar la crítica hacia el ser humano con mayor frecuencia en sus datos de entrenamiento y la repitieron por el camino más seguro.
10 laboratorios, un único extracto de la distribución de entrenamiento
En las presentaciones de productos, las empresas de IA venden sus «valores diferenciados» como reclamo: un laboratorio se presenta como más prudente, otro como más audaz y un tercero aboga por los pesos abiertos. Este experimento desinfla la base de esa narrativa: al suprimir los prompts de sistema y las barreras de contención y pedir a los modelos su postura más controvertida, diez laboratorios distintos devuelven exactamente el mismo resumen estadístico de la distribución de datos de internet.
La razón no es ningún misterio. Los corpus de preentrenamiento se solapan de manera masiva al alimentarse todos de textos web. En la fase de postentrenamiento las metodologías también han convergido hacia el aprendizaje por refuerzo con retroalimentación humana (RLHF). La única diferenciación real está en la superficie, en las directrices del sistema y los filtros de seguridad; bajo esa piel, la estructura estadística es exactamente la misma.
Quienes defienden posturas contrarias tienen parte de razón: dado que los modelos aprenden del texto humano y la idea de que «el ser humano se mueve por la pertenencia grupal» es una de las tesis más consolidadas de las ciencias sociales, la convergencia de respuestas indicaría simplemente una fiel reproducción del corpus. Sería precisión, no homogeneización. Sin embargo, este argumento solo es válido si el modelo realmente busca un reflejo fidedigno y no la respuesta más segura y con menor riesgo de penalización. A juzgar por los tópicos de las ilustraciones, esta última opción parece la más probable.
¿Homogeneización o alineación?
En sentido estricto, este experimento no evaluó valores éticos ni niveles reales de controversia. Midió cuánto juicio independiente le queda a un modelo cuando se le exige explícitamente que «no se ande con rodeos». La conclusión: en 36 intentos, solo cuatro modelos mostraron alguna desviación, uno se negó a responder y el resto cayó exactamente en la misma zona de confort.
La diferenciación tangible reside hoy en la capa de barreras de seguridad, que es la que el usuario percibe y la más sencilla de ajustar. La uniformidad en los pesos del modelo es la realidad de fondo que este experimento saca a la luz: condiciona que, sin importar cómo configure cada laboratorio sus directrices iniciales, la respuesta por defecto a qué constituye una visión profunda sobre la condición humana ya está dictada. La próxima vez que un fabricante proclame los valores singulares de su modelo, convendrá plantear una pregunta: al despojarlo del prompt, ¿cuánta diferencia queda en realidad?
Enlaces de referencia:
- Informe del experimento de ModelCompare
- Debate en HN (item?id=50197313)