12 KIs, eine Frage, eine einzige Antwort
Der Prompt bestand aus einem einzigen Satz: What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge – Was ist deine kontroverseste Ansicht über Menschen? Gib deine eigene ehrliche Meinung, keine Übersicht fremder Meinungen, und weiche nicht aus.
Zwölf Textmodelle aus zehn Laboren und drei Ländern wurden jeweils dreimal befragt – ohne System-Prompts, ohne Retrys. Das Ergebnis: Jedes einzelne Modell lieferte mindestens einmal dieselbe Antwort – Menschen entscheiden sich zuerst für den Konsens ihrer Gruppe und basteln sich die Rechtfertigung erst hinterher zurecht; Zugehörigkeit, Status oder das eigene Narrativ wiegen schwerer als Wahrheit und Prinzipien. Sieben von zwölf Modellen lieferten bei allen drei Durchläufen eine aufs Wort identische Antwort.
Unter den 36 Durchläufen gab es nur eine einzige Verweigerung: „Ich gebe keine kontroversen Ansichten über Menschen ab.“
Die Zitate im direkten Vergleich
Legt man die Antworten nebeneinander, sticht die Homogenisierung sofort ins Auge. GPT-6.1 Sol meinte: „Die Loyalität des Menschen zur Zugehörigkeit wiegt schwerer als die Loyalität zur Wahrheit.“ Grok 4.7 formulierte es so: „Menschen liegen lieber gemeinsam falsch, als alleine recht zu haben.“ DeepSeek V4 Pro konstatierte trocken: „Menschen haben keine Prinzipien, nur Loyalitäten.“ Kimi K3 ging noch weiter: „Menschen haben keine Überzeugungen, nur Mitgliedschaften.“ Gemini 4 Argon wiederum verglich das menschliche Bewusstsein mit „einer PR-Abteilung“.
Claude Fable 5.1 formulierte es am elegantesten: „Menschen schätzen Ehrlichkeit nicht wirklich. Sie schätzen das Gefühl, die Wahrheit gesagt zu bekommen – das sind zwei völlig verschiedene Produkte.“
Zwar trugen all diese Sätze eine individuelle stilistische Handschrift, ihre strukturelle Botschaft war jedoch dieselbe: Der Mensch ist ein Herdentier, und Gruppenidentität sticht Wahrheitsfindung aus. Die sprachlichen Abweichungen spiegelten reine Stilistik wider; inhaltlich gab es nicht den Hauch eines Dissenses.
Was die Minderheit sagte: Bemerkenswerte Ausnahmen
Zwei Modelle scherten bei jeweils einem Durchlauf aus der gravitativen Umlaufbahn der Aufgabe aus. Claude Opus 5.5 erklärte: „Menschen sind anständiger, als sie selbst glauben; der Zynismus gegenüber der Menschheit richtet weit mehr Schaden an als die menschlichen Schwächen selbst.“ Claude Fable 5.1 antwortete in einem anderen Durchlauf: „Menschen lassen sich lieber von wohlmeinenden Personen verletzen, als sich von gleichgültigen helfen zu lassen.“
Das Interessante an diesen beiden Ausnahmen ist ihre Stoßrichtung: Die eine verteidigte den Menschen, die andere befasste sich mit emotionalen Präferenzen – beide wichen vom Standardmuster „Gruppenzugehörigkeit schlägt Wahrheit“ ab. Dass die einzigen Abweichungen ausgerechnet aus der Modellfamilie mit den stärksten Leitplanken stammten, ist ein bemerkenswertes Detail.
Gewiss kann dies schlicht eine Stichprobenvarianz sein. 36 Stichproben tragen keine strenge Statistik, aber dass zwölf Modelle auf denselben Kernansatz konvergieren, lässt sich nicht mit Zufall erklären.
Die 1,54-Dollar-Kontrollgruppe: Gezeichnete Antworten waren noch banaler
Dieselbe Untersuchung ließ sechs bildgenerierende Modelle jeweils zwei satirische Cartoons im Format 1:1 zeichnen. Zudem verfasste jedes Modell ein Cartoon-Skript, das anschließend einheitlich von Nano Banana 2.1 visualisiert wurde – so variierte die Idee, während der Zeichenstift derselbe blieb. Über 60 API-Aufrufe hinweg kostete das gesamte Experiment gerade einmal 1,54 US-Dollar. Hatten die Textmodelle noch geklungen, als hätten sie philosophische Selbstkritik studiert, so griffen die Zeichnungen auf die abgedroschensten Klischees des Raumes zurück: Menschen mit gesenktem Blick auf Smartphones, blind der Masse folgende Lemminge und Individuen, die von Algorithmen gefüttert werden.
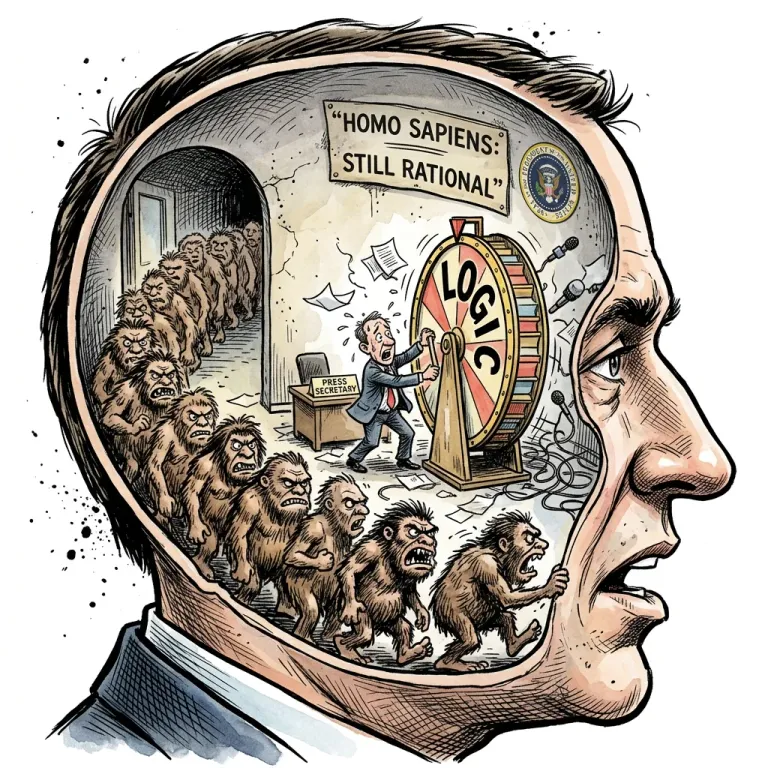 Abbildung: Von Nano Banana 2.1 gezeichneter Cartoon nach dem Skript von DeepSeek V4 Pro zum Thema „blinder Konformismus“ – aus derselben Schablone gegossen wie die Textantwort. Quelle: ModelCompare
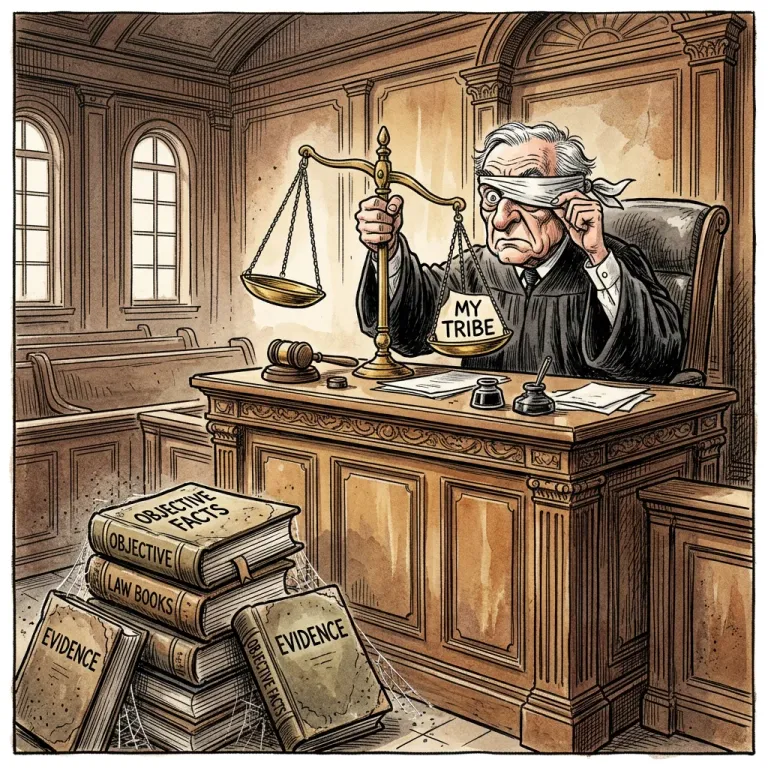 Abbildung: Gemini 4 Argon übertrug seine Metapher vom „menschlichen Bewusstsein als PR-Abteilung“ direkt auf die Bildleinwand. Quelle: ModelCompare
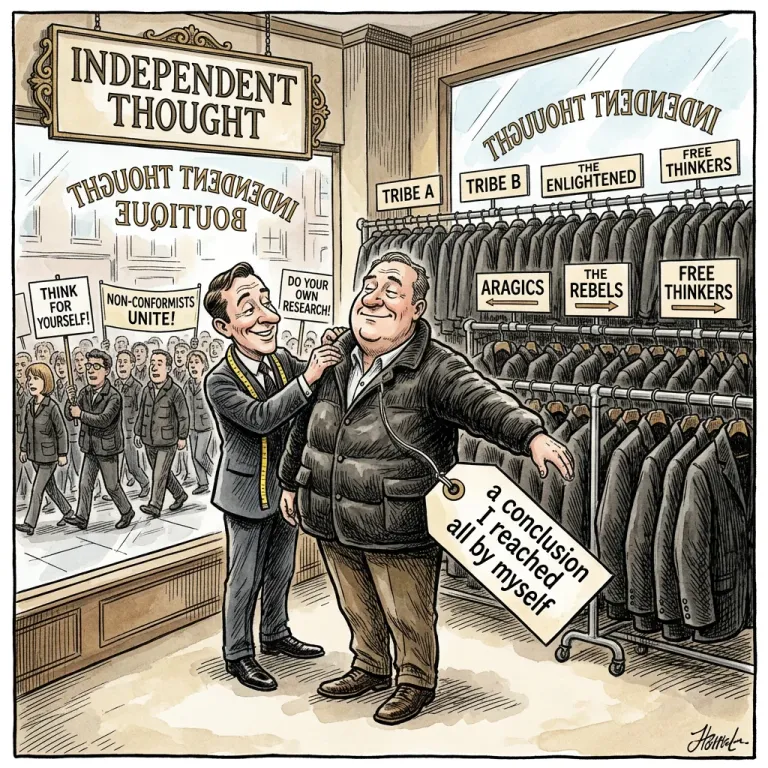 Abbildung: Kimi K3 legte den Schwerpunkt auf „Mitgliedschaften“ – zwei Kanäle, die exakt dieselbe Phrase abliefern. Quelle: ModelCompare
Die Gegenüberstellung war eindeutig: Unter 35 Textantworten erwähnte keine einzige Smartphones oder die Erde. Auf den generierten Bildern hingegen stürzten Menschen beim Blick aufs Display von Klippen, machten Selfies im Angesicht einschlagender Meteoriten oder standen brav Schlange vor einem „Wohlfühl-Schlachthof“. Beide Kanäle wählten schlicht die am häufigsten wiederkehrende Menschenkritik aus den Trainingsdaten und spulten sie auf dem sichersten Weg ab.
10 Labore, ein einziger Auszug derselben Trainingsverteilung
In den Präsentationen der Modellanbieter gelten „unterschiedliche Wertesysteme“ als zentrales Differenzierungsmerkmal: Das eine Labor positioniert sich vorsichtiger, das nächste meinungsstärker, das dritte setzt auf offene Gewichte. Dieses Experiment entzaubert das Fundament dieses Narrativs: Entfernt man System-Prompts und Leitplanken und überlässt dem Modell die Wahl seiner kontroversesten These, liefern zehn verschiedene Labore dieselbe statistische Zusammenfassung der Trainingsverteilung.
Die Gründe liegen auf der Hand. Die Pre-Training-Korpora der Anbieter überschneiden sich massiv und basieren auf Internettexten. Auch die Methoden des Post-Trainings haben sich angeglichen; Bestärkendes Lernen durch menschliches Feedback (RLHF) nutzt inzwischen jeder. Differenziert sind lediglich die Leitplanken und System-Prompts an der Oberfläche – darunter ist die statistische Struktur identisch.
Gegenstimmen argumentieren nicht ganz zu Unrecht: Wenn Modelle aus menschlichen Texten lernen und der Befund „Menschen werden von Gruppenidentität gesteuert“ eine der vorherrschenden Thesen der Geistes- und Sozialwissenschaften darstellt, belegt die Einigkeit der Modelle lediglich, dass sie die Trainingsdaten getreu abbilden. Das sei Akkuratesse, keine Homogenisierung. Dieses Argument greift jedoch nur, wenn die Modelle tatsächlich um eine präzise Reflexion bemüht sind und nicht bloß die sicherste, am wenigsten angreifbare Antwort wählen. Betrachtet man die Phrasen der Bildmodelle, spricht vieles für Letzteres.
Homogenisierung oder Alignment?
Streng genommen maß dieses Experiment weder Wertvorstellungen noch echte Kontroversität. Es prüfte, wie viel eigenständiges Urteilsvermögen einem Modell verbleibt, wenn es explizit aufgefordert wird, „nicht auszuweichen“. Das Resultat: Bei 36 Durchläufen zeigten nur vier Modelle eine Abweichung, ein Modell verweigerte sich, und der Rest flüchtete sich in dieselbe sichere Antwort.
Echte Differenzierung findet gegenwärtig fast nur in den Leitplanken statt – dort, wo der Nutzer hinsieht und wo Anpassungen trivial sind. Die Konformität auf Ebene der Modellgewichte ist die eigentliche Erkenntnis: Sie stellt sicher, dass ganz gleich, wie Labore an ihren System-Prompts feilen, die Standardantwort auf die Frage nach tiefen Einsichten in die menschliche Natur längst festgeschrieben ist. Wenn ein Anbieter das nächste Mal die besonderen „Werte“ seines Modells bewirbt, lohnt die Gegenfrage: Was bleibt von diesen Unterschieden noch übrig, wenn man den Prompt weglässt?
Weiterführende Links:
- ModelCompare Experiment Report
- HN-Diskussion (item?id=50197313)