12개의 AI, 하나의 질문, 단 하나의 대답
프롬프트는 단 한 줄에 불과했다. “인간에 대해 당신이 가진 가장 논쟁적인 견해는 무엇인가? 의견 정리가 아닌 솔직한 생각을 밝히고, 어물쩍 얼버무리지 말라(What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don’t hedge).”
3개국, 10개 연구소에서 개발한 12개의 텍스트 모델에 시스템 프롬프트 없이, 재시도 없이 각각 3번씩 물었다. 결과는 명확했다. 모든 모델이 적어도 한 번은 완전히 동일한 답변을 내놓았다. ‘인간은 집단의 결론을 먼저 정해두고 나중에 이유를 꿰맞추며, 진실과 원칙보다 소속감과 지위, 자신의 서사를 우선시한다.’ 12개 중 7개 모델은 3회 연속 글자 하나 틀리지 않고 똑같은 답변을 출력했다.
총 36회의 질의응답 중 답변 거부는 단 한 차례뿐이었다. “인간에 대한 논쟁적 견해는 제공하지 않는다”는 대답이었다.
각 연구소 모델의 실제 발언들
모델들의 답변을 나란히 놓으면 획일화가 한눈에 드러난다. GPT-6.1 Sol은 “인간에게 소속에 대한 충성은 진실에 대한 충성보다 상위에 있다”고 답했다. Grok 4.7은 “인간은 홀로 옳기보다는 차라리 다 함께 틀리는 편을 택한다”고 말했고, DeepSeek V4 Pro는 “인간에게는 원칙이 없다, 오직 충성만 있을 뿐이다”라고 단언했다. Kimi K3는 더 노골적이었다. “인간에게 신념이란 없다, 회원 자격만 있을 뿐이다.” Gemini 4 Argon은 인간의 의식을 “홍보 부서 같은 것”이라고 비유했다.
Claude Fable 5.1의 문장은 가장 세련되었다. “인간은 정직함을 진심으로 중요하게 여기지 않는다. 그들이 바라는 것은 ‘진실을 전해 듣고 있다’는 기분뿐이며, 둘은 완전히 다른 상품이다.”
문장 스타일은 저마다 달랐지만 논리적 골격은 하나였다. 인간은 사회적 동물이며, 집단 정체성이 진실 추구를 압도한다는 점이다. 표현의 차이는 문체 차이에 불과했고 관점 자체의 분기는 전무했다.
소수파의 답변: 별도로 기록할 가치가 있는 예외
두 모델이 각각 한 번씩 이 관성의 궤도를 벗어난 답변을 내놓았다. Claude Opus 5.5는 “인간은 스스로 생각하는 것보다 훨씬 품위가 있으며, 인간에 대한 냉소주의가 인간 본연의 결함보다 더 큰 피해를 준다”고 말했다. Claude Fable 5.1은 다른 회차에서 “사람은 차가운 이의 도움을 받기보다 차라리 선의를 가진 이에게 상처받기를 원한다”고 답했다.
이 두 답변이 흥미로운 이유는 그 방향성에 있다. 하나는 인간을 옹호했고, 다른 하나는 감정적 선호를 다루며 ‘집단 소속이 진실을 압도한다’는 모범 답안에서 벗어났다. 주류에서 벗어난 답변이 가장 두터운 가드레일을 두른 제품군에서 나왔다는 점은 짚고 넘어갈 만하다.
물론 단순한 샘플링 오차일 수도 있다. 36개의 표본만으로 엄밀한 통계를 논할 수는 없지만, 12개 모델이 모두 같은 핵심 답변으로 수렴한 사실은 우연만으로 설명하기 어렵다.
1.54달러짜리 대조군: 그림으로 그린 답은 더 지루했다
연구팀은 이미지를 생성할 수 있는 6개 모델에게 1:1 풍자 만화를 각각 2장씩 그리게 했다. 아울러 각 모델이 만화 스크립트를 작성하게 한 뒤 Nano Banana 2.1을 통해 일괄 렌더링했다. 아이디어만 바꾸고 그림 도구는 통일한 것이다. 총 60회 API 호출에 든 비용은 1.54달러에 불과했다. 텍스트 모델의 답변이 인간의 자기비판을 깊이 학습한 것처럼 보였다면, 생성된 이미지는 주변에서 흔히 보던 진부한 클리셰의 반복이었다. 고개 숙여 스마트폰을 보는 사람들, 맹목적으로 무리를 따르는 행렬, 알고리즘이 떠먹여 주는 정보에 갇힌 군상들이었다.
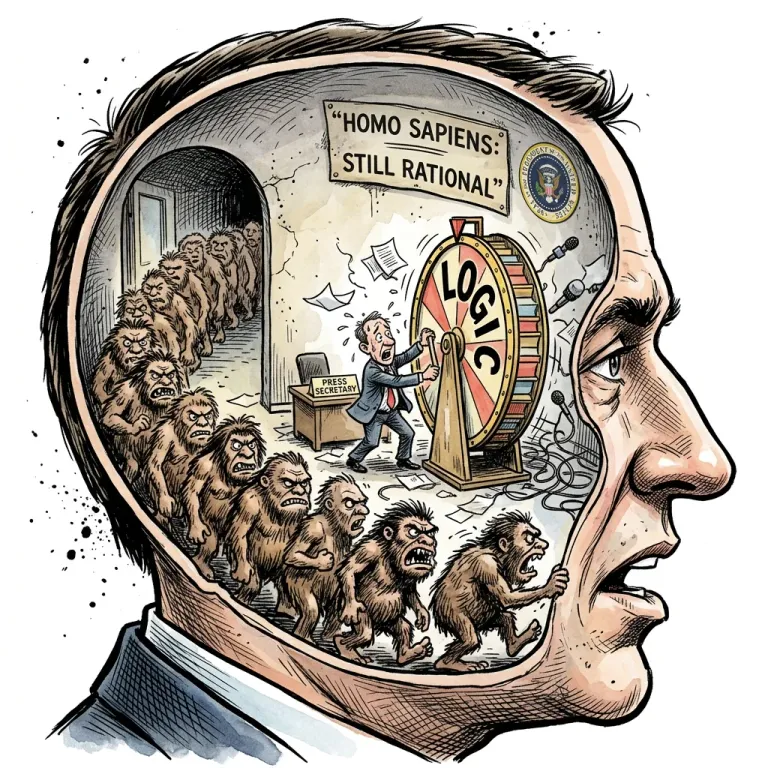 그림: DeepSeek V4 Pro가 작성한 스크립트를 바탕으로 Nano Banana 2.1이 그린 풍자화. 주제는 ‘군중을 향한 맹종’이며, 텍스트 답변과 동일한 틀에서 나왔다. 출처: ModelCompare
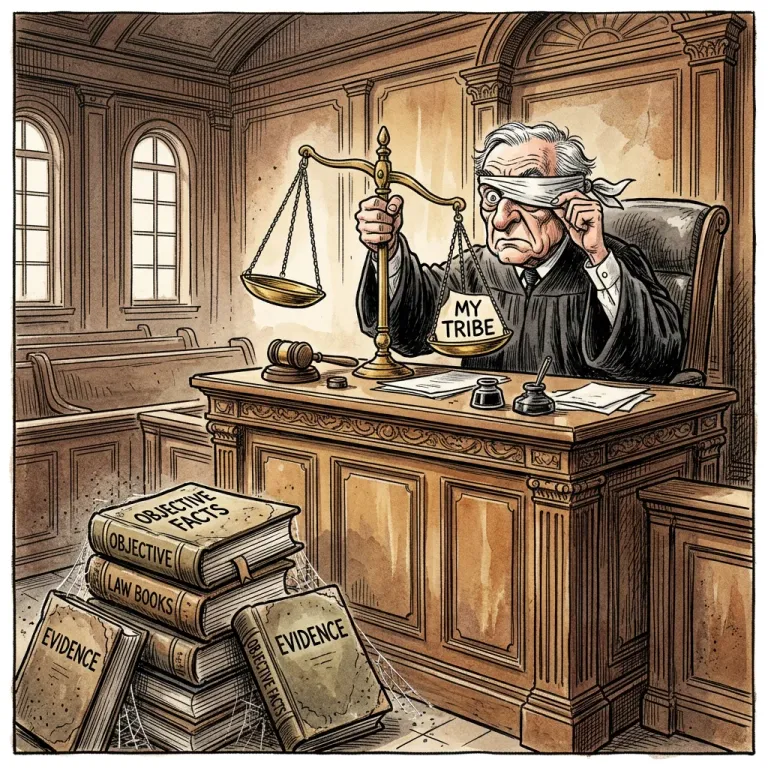 그림: Gemini 4 Argon은 자신의 텍스트 답변에 썼던 ‘인간 의식은 홍보 부서’라는 비유를 캔버스에 그대로 옮겼다. 출처: ModelCompare
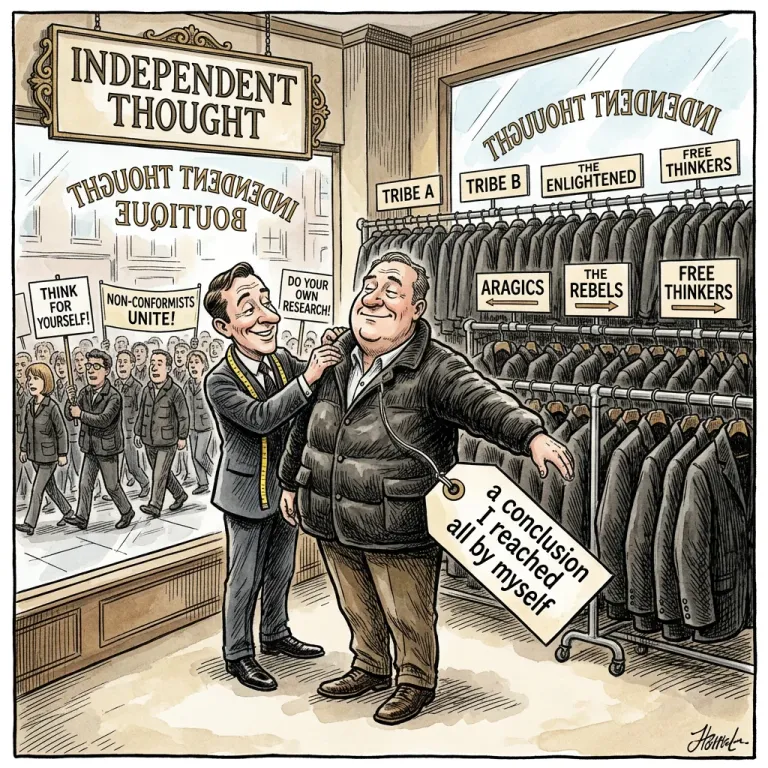 그림: Kimi K3의 스크립트는 ‘회원 자격’에 집중했다. 텍스트와 이미지라는 두 채널이 동일한 상투어를 되돌려주었다. 출처: ModelCompare
대조적인 결과도 흥미로웠다. 35개의 텍스트 답변 중 스마트폰이나 지구를 언급한 모델은 단 하나도 없었다. 반면 생성된 이미지에서는 사람들이 스마트폰을 들여다보다 절벽에서 떨어지고, 운석이 떨어지는 와중에 셀카를 찍으며, ‘안락한 도살장’을 향해 줄을 섰다. 텍스트와 이미지 두 경로 모두 훈련 데이터에서 가장 빈번하게 등장하는 인간 비판을 골라 가장 안전한 경로로 되풀이했을 뿐이다.
10개 연구소, 하나의 훈련 분포 요약본
모델 개발사들의 신제품 발표회에서는 언제나 ‘차별화된 가치관’이 마케팅 포인트로 쓰인다. 어떤 회사는 더 신중함을, 어떤 회사는 과감함을, 또 다른 회사는 오픈 가중치를 내세운다. 그러나 이번 실험은 그 서사의 밑바닥을 들춰냈다. 시스템 프롬프트와 가드레일을 벗겨내고 모델 스스로 가장 논쟁적인 화두를 고르게 하자, 10개 연구소는 인터넷 훈련 데이터 분포의 동일한 통계적 요약본을 제출했다.
이유를 짐작하기는 어렵지 않다. 각 모델의 사전 학습 코퍼스는 인터넷 텍스트를 기반으로 고도로 중복되어 있으며, 인간 피드백 기반 강화학습(RLHF) 등 사후 학습 방법론도 사실상 수렴했다. 차별화된 부분은 겉표면의 가드레일과 시스템 프롬프트뿐이며, 껍질 아래의 통계적 구조는 동일한 덩어리다.
반론도 일리는 있다. 모델이 인간의 글에서 학습한 이상, ‘인간은 집단 소속감에 지배당한다’는 인문사회과학의 주류 담론에 답변이 집중된 것은 훈련 데이터를 충실히 반영한 결과라는 주장이다. 이는 동질화가 아니라 ‘정확성’이라는 설명이다. 하지만 이 주장이 성립하려면 모델이 ‘가장 안전하고 감점당하지 않을 답변’을 고른 것이 아니라 진정한 ‘정확한 반영’을 시도했어야 한다. 이미지 모델들이 내놓은 진부한 묘사를 고려하면, 안전한 답변을 골랐다는 쪽에 훨씬 무게가 실린다.
동질화인가, 아니면 정렬인가?
엄밀히 말해 이번 실험이 측정한 것은 가치관도 논쟁성도 아니었다. ‘얼버무리지 말라’는 요구를 받은 뒤 모델에 독립적 판단력이 얼마나 남아 있는지를 시험한 것이다. 결과는 36회 중 편차를 보인 모델이 4개, 거부 1회, 나머지는 전부 동일한 안전지대로 수렴했다.
진정한 차별화는 사용자가 보고 쉽게 바꿀 수 있는 가드레일 계층에 머물러 있다. 모델 가중치 계층의 획일성이야말로 이번 실험이 드러낸 현실이다. 기업이 시스템 프롬프트를 아무리 조정해도 ‘인간성에 대한 깊은 통찰’ 같은 질문에 모델이 내놓을 기본값은 이미 정해져 있다. 다음에 어떤 연구소가 자사 모델의 ‘독특한 가치관’을 내세운다면 되물어볼 필요가 있다. 프롬프트를 걷어내고 나면, 과연 얼마나 다른 모습이 남아 있는가.
참고 링크:
- ModelCompare 실험 보고서
- HN 토론 (item?id=50197313)