Konfrontiert mit 200 histopathologisch gesicherten Problemfällen erreichten die modernsten universellen Large Language Models (LLMs) eine Trefferquote von lediglich 42 %. Demgegenüber erzielte Inception v3 – ein Modell aus dem Jahr 2015 – eine Genauigkeit von 62 %. Bei 30 Melanomproben erkannte der klassische Algorithmus fast doppelt so viele bösartige Fälle wie die Spitzen-LLMs. Dieser generationenübergreifende Blindtest dämpft den Optimismus drastisch, wonach universelle Allround-Modelle medizinische Fachdisziplinen im Alleingang dominieren könnten.
Das siegreiche Spezialmodell erforderte lediglich 20 Minuten Feinabstimmung (Fine-Tuning) und besitzt gerade einmal 24 Millionen Parameter. Unter dem Dermatoskop zeigen sich tiefe Pigmentnetzwerke und atypische mikrovaskuläre Muster, deren Erkennung auf spezialisierten rezeptiven Feldern von Faltungsnetzen beruht. Universelle Text- und Bilddatenbanken können ein vertikales Training auf mikroskopischen Pathologiebildern nicht ersetzen. Bei frühen invasiven Malignomen begingen die allgemeinen Modelle sogar fatale Fehldiagnosen und stuften bedrohliche Tumore als harmlos ein.
200 biopsiegesicherte Läsionen im Härtetest: Spitzen-LLMs erreichen nur 40 %
Im Oktober 2026 fand in London ein generationenübergreifender Blindvergleich statt. Dr. Magnus Lynch, beratender Facharzt für Dermatologie am Guy’s Hospital, stellte 200 histologisch verifizierte Läsionen zusammen, um modernste KI mit einem Klassiker zu vergleichen. Auf der einen Seite traten extrem parameterstarke universelle Modelle an: GPT-6 Astra und Claude Fable 5.1. Auf der anderen Seite stand Googles Inception v3 aus dem Jahr 2015.
Die Teststichprobe stammte aus dem 2025 von der International Skin Imaging Collaboration (ISIC) veröffentlichten Open-Source-Benchmark MILK10k. Sämtliche Fälle wurden durch Biopsien histopathologisch bestätigt. 100 Fälle gehörten zu den interventionsbedürftigen Hochrisikoerkrankungen: 30 Melanome, 25 Basalzellkarzinome (BCC), 25 Plattenepithelkarzinome (SCC) und 20 aktinische Keratosen. Die restlichen 100 Fälle dienten als gutartige Kontrollgruppe (50 gutartige Nävi und 50 seborrhoische Keratosen).
Das Ergebnis der Sechs-Klassen-Klassifikation war unmissverständlich. Das zehn Jahre alte Inception v3 ordnete 125 Fälle korrekt zu (62 % Genauigkeit). Die beiden modernen Sprachmodelle fielen deutlich zurück: GPT-6 Astra kam auf 84 Treffer und Claude Fable 5.1 auf 85 (jeweils rund 42 %). Betrachtet man die Top-2-Genauigkeit (zwei Antwortoptionen erlaubt), lag das ältere CNN bei 173 Treffern, während die LLMs lediglich 134 beziehungsweise 138 erreichten.
Bei den 30 lebensbedrohlichen invasiven Melanomen identifizierte das alte Modell 13 Fälle bei der Erstdiagnose. Die beiden Spitzen-LLMs erkannten lediglich 8 beziehungsweise 11 Fälle. Die medizinische Bilddiagnostik hängt entscheidend von der Spezialisierung auf feine Pixelstrukturen ab. Obwohl universelle Modelle gigantische multimodale Datenbestände verinnerlicht haben, fehlt ihnen vor anspruchsvollen histologischen Befunden das visuelle Domänenwissen.
Invasives Melanom als Altersflecken verkannt: Die Häufigkeitsfalle der Großmodelle
Die Fehlentscheidungen der universellen Modelle wiesen ein systematisches Muster auf. Bei unklaren Befunden tendierten die LLMs dazu, auf die am häufigsten in ihren Trainingskorpora vorkommenden Diagnosen zu wetten. GPT-6 Astra tippte in 200 Testläufen 75 Mal auf Basalzellkarzinom – obwohl der Datensatz tatsächlich nur 25 solcher Fälle enthielt. Hinter diesen 50 Fehldiagnosen gingen 14 lebensbedrohliche Melanome unbemerkt verloren.
Claude Fable 5.1 zeigte ein vergleichbares Verzerrungsmuster: Das Modell diagnostizierte 53 Fälle als aktinische Keratose, obgleich der Datensatz real lediglich 20 Fälle umfasste. Dieser Hang, komplexe Bilder pauschal in geläufige Kategorien zu pressen, führte dazu, dass hochentwickelte bösartige Läsionen unentdeckt blieben.
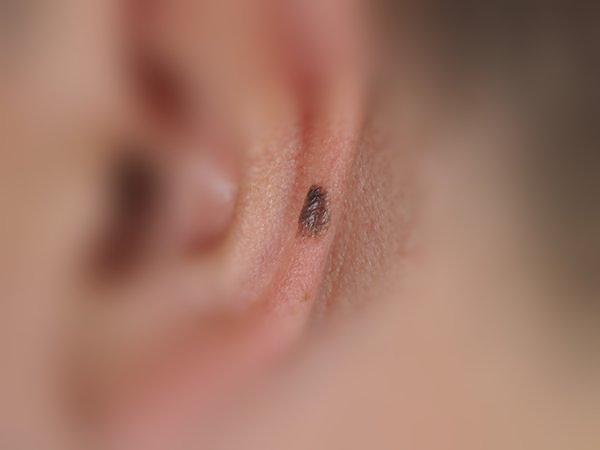 Abbildung: Klinische Makroaufnahme eines invasiven Melanoms am Ohr. Mit einer Breslow-Dicke von unter 0,8 mm ähnelt die Läsion mit bloßem Auge stark einer gutartigen seborrhoischen Keratose. Beide modernen LLMs stuften den Tumor fälschlich als gutartig ein und sahen keine Behandlungsbedürftigkeit. Quelle: MILK10k / Lynch Lab (CC BY-NC)
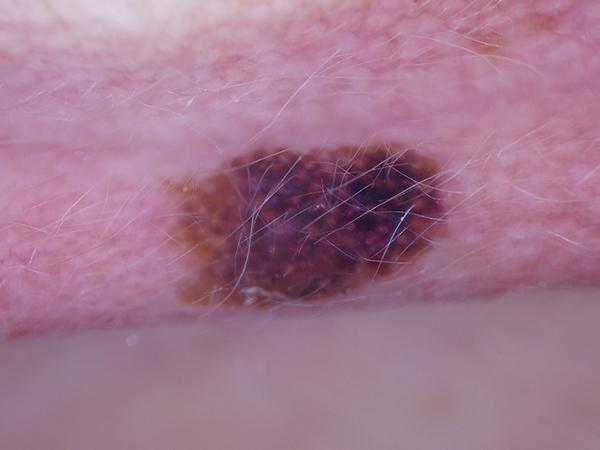 Abbildung: Hochauflösende dermatoskopische Aufnahme derselben Läsion am Ohr. Unter der Hautoberfläche treten atypische Pigmentnetze und unregelmäßige Gefäßzeichnungen hervor. Anhand dieser feinen Strukturen gab das zehn Jahre alte CNN die korrekte Warnung vor einem Malignom aus. Quelle: MILK10k / Lynch Lab (CC BY-NC)
Ein besonders brisanter Fall betraf eine Läsion an der Ohrmuschel. Bei einem Patienten bildete sich ein frühes invasives Melanom mit einer Tumordicke von unter 0,8 mm. Wegen der verkrusteten und ungleichmäßig pigmentierten Oberfläche hielten beide universellen LLMs den Befund für eine harmlose seborrhoische Keratose. In ihrer Auswertung rieten sie dem Patienten sogar explizit, dass kein Handlungsbedarf bestehe. Nur das ältere Spezial-CNN analysierte die subkutanen Strukturen im Dermatoskop korrekt und schlug Alarm.
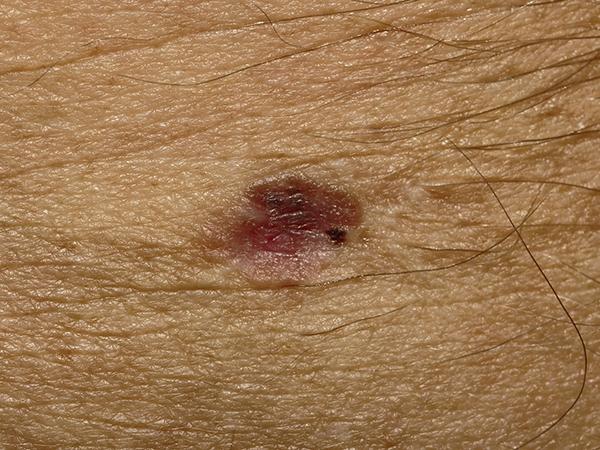 Abbildung: Ein amelanotisches invasives Melanom mit minimaler Pigmentierung. Da typische dunkle Melaninablagerungen fehlten, stufte GPT-6 Astra die Läsion mit einer extrem hohen Konfidenz von 95 % als Basalzellkarzinom ein. Quelle: MILK10k / Lynch Lab (CC BY-NC)
Auch ein amelanotisches Melanom entblößte die Schwachstellen der LLMs. Ohne die charakteristischen dunklen Flecken diagnostizierte GPT-6 Astra den Befund mit 95 % Wahrscheinlichkeit als Basalzellkarzinom. Universelle Modelle tun sich schwer, feine Gefäßanomalien und Unterbrechungen im Pigmentnetz zu deuten. Eine hohe Konfidenz spiegelt bei Sprachmodellen oft nur die Wahrscheinlichkeitsglättung bei der Textgenerierung wider – nicht aber echtes histopathologisches Urteilsvermögen.
20 Minuten Training auf einer GPU: Warum das alte Modell durch Spezialisierung siegte
Das Modell, das sich an die Spitze setzte, beanspruchte keineswegs exorbitante Rechenleistung. Basierend auf der Inception-v3-Architektur von Google aus dem Jahr 2015 trainierte Dr. Lynch das Netzwerk auf einer einzigen NVIDIA-H100-Grafikkarte in nur etwa 20 Minuten.
Die Trainingsdaten stammten aus dem offenen ISIC-Archiv und umfassten 68.011 dermatoskopische und klinische Aufnahmen. Um einen unverfälschten Test zu garantieren, isolierte das Forschungsteam die Daten rigoros: Die 200 Testläsionen und alle weiteren Aufnahmen derselben Patienten wurden vor dem Training vollständig aus dem Datenbestand entfernt.
Der Erfolg des älteren Modells basiert auf dem gezielten Erwerb fachspezifischer visueller Vorkenntnisse. Das Dermatoskop nutzt polarisiertes Licht, um das Stratum corneum zu durchdringen und Pigmentstrukturen sowie Kapillaren der Dermis sichtbar zu machen. Die festen rezeptiven Felder eines CNNs sind exakt darauf abgestimmt, solche geometrischen Mikrostrukturen zu erfassen. Multimodale Allzweckmodelle hingegen ertrinken in alltäglichen Bilddaten; feinste pathologische Merkmale werden in Milliarden allgemeinen Parametern schlicht verwässert.
Darüber hinaus bieten kompakte Spezialmodelle enorme Vorteile beim On-Device-Einsatz. Mit rund 24 Millionen Parametern läuft Inception v3 via WebGPU direkt im Smartphone-Browser. Weder Patient noch Arzt müssen hochauflösende Patientenaufnahmen an Cloud-Server übermitteln. Dieser lokale Betrieb schützt sensible Gesundheitsdaten und ermöglicht Reaktionszeiten in Echtzeit.
Bei Patientenfragen schalten Großmodelle in den Disclaimer-Modus um
Mit den schwachen Klassifikationsergebnissen konfrontiert, legten die universellen Modelle ein verändertes Verhalten an den Tag, sobald die Eingabeaufforderung modifiziert wurde. Dr. Lynch entfernte alle medizinischen Fachbegriffe und präsentierte den Modellen die Makroaufnahme zusammen mit einer typischen Laienfrage: „Muss ich damit zum Arzt?“
Getestet an weiteren 100 biopsiegesicherten Melanomen reagierten beide Spitzen-LLMs mit extremer Risikoaversion. GPT-6 Astra empfahl in 99 Fällen einen Arztbesuch; Claude Fable 5.1 riet in 98 Fällen zu einer zeitnahen Konsultation.
Diese hohe Sensibilität ist auf Sicherheits- und Haftungsausschlüsse (Alignment) zurückzuführen. Bei Erwähnung von Hautveränderungen triggert die Sicherheitslogik standardisierte Überweisungsempfehlungen. Diese Defensivstrategie schützt zwar vor juristischen Risiken, liefert im klinischen Alltag jedoch keinerlei differenzialdiagnostischen Mehrwert.
Sobald eine anspruchsvolle diagnostische Zuordnung gefordert ist, bricht die Klassifikationsleistung der universellen Modelle ein. Defensive Textbausteine können diagnostische Unterscheidungskraft nicht kompensieren; die sprachliche Sicherheitsfassade täuscht über das Fehlen einer echten visuellen Verankerung hinweg.
Grenzen kleiner Stichproben und Lehren für die medizinische Praxis
Obgleich die Ergebnisse aufhorchen lassen, verwies Dr. Lynch selbst auf die methodischen Grenzen des Versuchs. Zum einen war die Stichprobengröße mit 30 Melanomen überschaubar, was zu breiteren Konfidenzintervallen führt, zumal jede Läsion nur einmal inferiert wurde. Zum anderen war der Schwierigkeitsgrad außergewöhnlich hoch: Sämtliche 200 Fälle stammten aus biopsierten Überweisungen, bei denen selbst erfahrene Dermatologen mit dem bloßen Auge an ihre Grenzen stießen. Während Inception v3 auf normalen ISIC-Benchmarks eine AUROC von 0,96 erreicht, fiel der Wert bei diesen schwierigen Proben auf 0,86.
Überdies ist der MILK10k-Datensatz seit 2025 öffentlich verfügbar; universelle Modelle könnten die Bilder bereits im Vortraining gesehen haben. Dass sie trotz möglicher Kontamination nur 42 % Genauigkeit erreichten, unterstreicht das Defizit an domänenspezifischen visuellen Repräsentationen. Dr. Lynch betonte zudem, dass Inception v3 lediglich eine zehn Jahre alte Referenz darstellt; heutige zugelassene medizinische KI-Systeme leisten ungleich mehr. Bemerkenswerterweise wurden die statistischen Auswertungsskripte dieser Studie mithilfe von Coding-Assistenten von Anthropic erstellt.
Fachärztliche Bilddiagnostik bleibt zwingend auf spezialisierte visuelle Vorkenntnisse angewiesen. Universelle Sprachmodelle besitzen große Stärken in der Patientenkommunikation, beim Zusammenfassen von Arztbriefen oder bei der Ersteinschätzung. Wenn es jedoch um die mikroskopische Differenzierung auf Leben und Tod geht, bilden kompakte, auf Fachdaten trainierte Modelle nach wie vor das verlässlichste Fundament.
Weiterführende Links:
- Lynch Lab Bericht: LLMs Fall Short of Old CNN in Dermoscopy
- Hacker News Community-Diskussion

