Le 7 octobre 2026, OpenAI a déployé GPT-6 ainsi que son interface dynamique « Intelligent UI » auprès des abonnés ChatGPT Plus, Pro, Business et Enterprise. Dès le lendemain, ce déploiement a été étendu aux utilisateurs des offres gratuites et de l’offre Go, touchant ainsi une base de 1,2 milliard d’utilisateurs actifs hebdomadaires. Les formules payantes s’appuient sur GPT-6 Sol, tandis que les paliers gratuits et Go exploitent la version allégée GPT-6 Luna. Cette refonte demeure strictement cantonnée à l’onglet Chat ; les versions de modèles et les interactions au sein de ChatGPT Work et de Codex restent inchangées. La métamorphose la plus manifeste saute aux yeux : les réponses s’affranchissent des blocs de texte monolithiques. Le modèle décide désormais de manière autonome s’il convient de restituer l’information sous forme de formulaires, de boutons d’action, de graphiques ou d’outils interactifs sur mesure. Dès la soumission d’une consigne, un module d’interface s’assemble en direct à l’écran, au rythme même de l’émission des tokens.
Des micro-applications éphémères au cœur du dialogue
Lors des bancs d’essai menés par la presse spécialisée, la question d’un utilisateur portant sur la cinématique d’un vélo à sept vitesses a suscité un schéma interactif dynamique. Le cadre, les roues, les freins et le dérailleur formaient autant de zones cliquables ; un simple clic déployait instantanément l’analyse détaillée de chaque composant. La démonstration officielle consacrée à une recette de gigot d’agneau rôti a illustré une intégration encore plus poussée : la réponse intégrait des illustrations générées en ligne accompagnées d’un curseur d’ajustement du nombre de convives. La modification de ce paramètre recalculait instantanément et automatiquement les proportions de la liste d’ingrédients située plus bas.
 Figure : Couverture du guide officiel de la famille de modèles GPT-6. Source : Annonce officielle d’OpenAI.
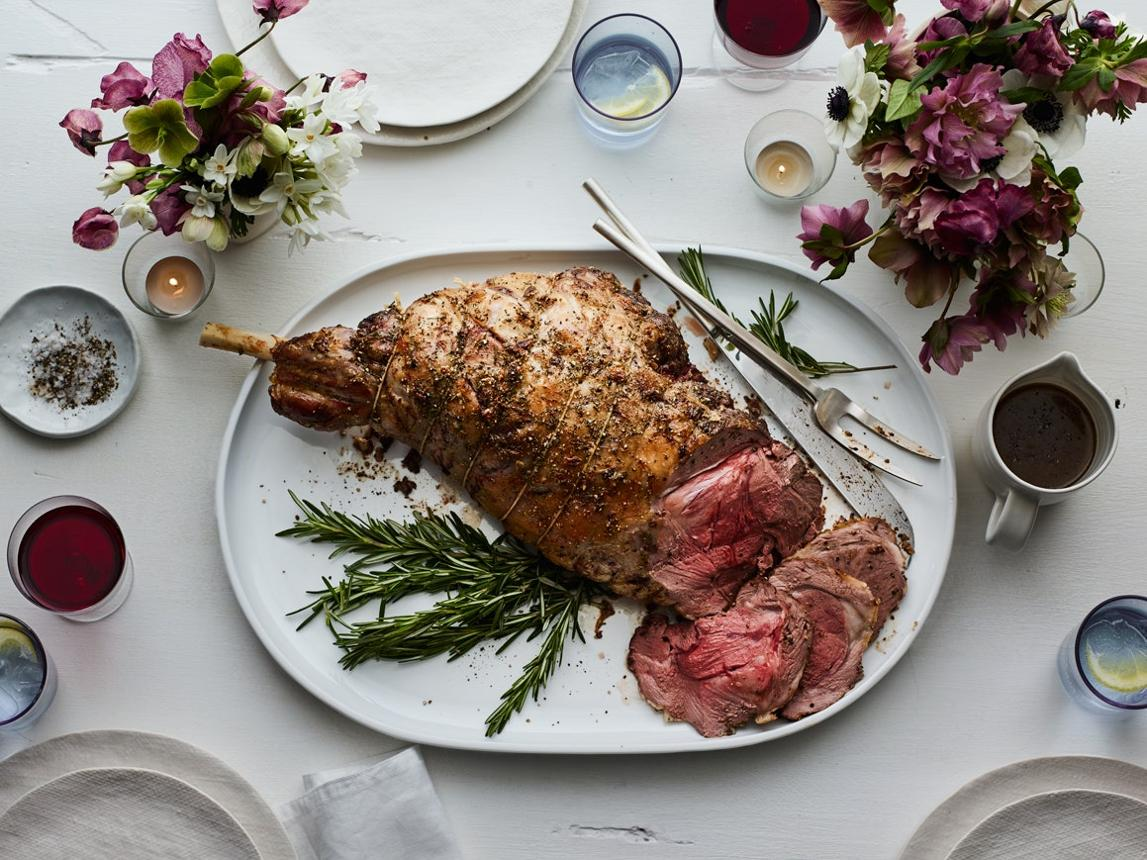 Figure : Illustration de gigot d’agneau rôti générée au sein de la réponse de ChatGPT. Source : Page officielle d’OpenAI.
L’espace vital des petites applications ponctuelles — calculettes, séparateurs d’addition ou listes de courses — se trouve ainsi directement absorbé par le fil de discussion. Alors que l’utilisateur devait auparavant basculer entre de multiples outils distincts pour finaliser une tâche, la réponse du dialogue fait désormais office d’environnement applicatif autonome. Cet effondrement du coût d’interaction permet à des besoins fragmentés et peu fréquents d’être comblés sur-le-champ sous leur forme la plus légère.
Un assemblage d’interfaces bridé par une bibliothèque prédéfinie
OpenAI a rendu publics les contours techniques de ce mécanisme de génération : la firme a élaboré une bibliothèque de composants nativement conçue pour le rendu en flux continu (streaming), adossée à un compilateur capable d’interpréter les éléments d’interface en temps réel pendant la génération du texte. C’est cette architecture sous-jacente qui permet à l’interface d’émerger progressivement sous les yeux de l’utilisateur. Durant la phase d’entraînement, l’équipe de développement a spécifiquement affiné l’évaluation du modèle en matière de hiérarchie visuelle, de mise en page, d’esthétique et de logique d’interaction, érigeant la clarté, l’utilité et l’exhaustivité en critères rigides de validation automatisée.
 Figure : Illustration de pommes de terre rôties croustillantes générée au sein de la même réponse. Source : Page officielle d’OpenAI.
« Le logiciel qui s’adapte à l’humain » est la formule consacrée par OpenAI pour résumer cette évolution, mais cette flexibilité demeure strictement encadrée. Le modèle ne fait qu’opérer des combinaisons et permutations contraintes au sein d’une panoplie d’éléments prédéterminés, l’entreprise reconnaissant volontiers que son jugement en matière de design offre encore une marge de progression considérable. Le modèle ne dispose que d’un mandat d’assemblage sur les briques fournies par le moteur sous-jacent ; tous les contrôles à l’écran proviennent de ce catalogue figé, sans que l’IA ne crée de nouveaux composants fondamentaux.
Penser tout en répondant : livrer des résultats partiels immédiatement exploitables
GPT-6 permet à ChatGPT de mener de front réflexion interne et génération de réponse, une approche en parfaite résonance avec la philosophie d’Intelligent UI : privilégier la restitution de résultats partiels actionnables, avant d’en affiner progressivement les détails au fil des cycles de calcul. D’après les chiffres officiels, sur les requêtes nécessitant le recours à des outils de recherche web externes, GPT-6 Instant émet son premier token 44 % plus vite en moyenne que la génération précédente.
Dans les évaluations internes ciblant des scénarios d’agents autonomes au quotidien, la latence au premier token de GPT-6 Extra High a égalé celle du palier Medium de la génération antérieure, tout en dépassant le score global de résolution de l’ancien palier Extra High. Le rendu continu des composants côté client, conjugué à une restitution par étapes, comble les temps d’attente inhérents aux calculs complexes, conférant au système une réactivité bien plus proche des réflexes intuitifs humains.
La System Card identifie des capacités à haut risque dans deux domaines
La System Card publiée simultanément révèle que les moutures d’octobre de GPT-6 Sol et GPT-6 Luna ont été rigoureusement éprouvées selon le cadre Preparedness Framework d’OpenAI. La cybersécurité ainsi que les menaces biologiques et chimiques (CBRN) ont été qualifiées au niveau « High capability ». En revanche, l’auto-amélioration autonome de l’IA — sujet de vives inquiétudes dans l’industrie — n’a pas franchi le seuil d’alerte élevé prévu par ce protocole.
La résistance du modèle face aux tentatives de jailbreak a été nettement consolidée. Le système fait preuve d’une robustesse accrue face aux attaques adaptatives menées sur plusieurs tours de dialogue, affichant un taux d’acceptation en net recul pour les requêtes trompeuses ou cherchant à contourner ses garde-fous de sécurité. Sur certains sous-tests où des régressions mineures ont été constatées, les équipes de sécurité ont procédé à des audits manuels et à des tests d’intrusion par équipe rouge (red teaming), concluant que ces réponses rares demeuraient confinées dans un registre de faible gravité.
La mise en page dynamique face au défi de la reproductibilité
Cette métamorphose radicale des formats de sortie a suscité des réactions contrastées au sein des communautés de développeurs. Dans les fils de discussion de Hacker News, plusieurs intervenants ont déploré le caractère paternaliste des réponses graphiques : la surabondance d’illustrations d’appoint, les blancs délibérés et les listes interminables d’étapes laissaient à certains le sentiment d’être traités comme des novices absolus. Les partisans de cette approche ont rétorqué que, lors de présentations destinées à des clients non techniciens, la consigne système la plus plébiscitée exigeait précisément des explications pédagogiques étayées de schémas clairs.
Si ces modules interactifs représentent une passerelle bienvenue pour les profils non spécialistes, ils constituent une gêne visuelle pour les ingénieurs chevronnés en quête d’une ligne de commande ou d’une réponse concise. La préoccupation majeure relève toutefois de l’ingénierie logicielle : pour une même consigne, l’interface générée peut afficher des agencements radicalement disparates, laissant la question des tests d’intégration automatisés et de la reproductibilité déterministe sans réponse technique évidente. Plusieurs observateurs ont fait remarquer que Gemini 3.8, déployé à la même période, avait maintenu une approche textuelle épurée, évitant ainsi le recours à des consignes défensives supplémentaires pour éliminer les fioritures visuelles.
Une bibliothèque de composants qui ouvre la voie à la monétisation
Au cours du mois même de cette mise à jour, OpenAI avançait sur la conception de formats publicitaires et de dispositifs de mesure d’attribution au sein de ChatGPT. Dès lors que le fil de discussion intègre naturellement formulaires de saisie, boutons d’action et widgets interactifs, la monétisation de la plateforme s’affranchit totalement de la rigidité des liens hypertextes classiques.
Sur le plan de l’architecture logicielle, afficher une liste dynamique d’ingrédients ou insérer un composant promotionnel avec passerelle d’achat immédiate repose exactement sur la même bibliothèque de composants en continu. Une fois la maîtrise de la densité d’affichage confiée au moteur de rendu client, la distance séparant un simple widget interactif d’un acte d’achat ne dépend plus que d’un arbitrage fonctionnel au niveau du produit.
Liens de référence :
- Annonce officielle d’OpenAI
- System Card de GPT-6 par OpenAI
- Article de MacRumors
- Discussion sur Hacker News