El 7 de octubre de 2026, OpenAI desplegó GPT-6 junto con Intelligent UI para los usuarios de ChatGPT Plus, Pro, Business y Enterprise. Al día siguiente, la actualización se extendió a los planes gratuitos y Go, cubriendo una base de 1.200 millones de usuarios activos semanales. Los planes de pago están respaldados por GPT-6 Sol, mientras que las cuentas gratuitas y Go acceden a una versión más ligera, GPT-6 Luna. La modificación se limita estrictamente a la pestaña Chat; las versiones del modelo y los patrones de interacción en ChatGPT Work y Codex permanecen sin cambios. La transformación más evidente salta a la vista en pantalla: las respuestas han dejado de ser meros bloques estáticos de texto. Ahora, el modelo determina sobre la marcha si presenta el resultado mediante formularios, botones de acción, gráficos interactivos o herramientas funcionales. Al introducir una instrucción, los módulos de la interfaz se ensamblan en tiempo real conforme se generan los tokens.
Microaplicaciones de un solo uso en la ventana de chat
En las pruebas realizadas por medios tecnológicos, cuando un usuario preguntó por la mecánica de una bicicleta de siete velocidades, el modelo devolvió un diagrama esquemático dinámico. El cuadro, las ruedas, los frenos y la transmisión se comportaban como áreas interactivas desplegables: al pulsar sobre cualquiera de ellas, se desglosaba en detalle su estructura interna. La demostración oficial con una receta de pierna de cordero asada evidenció un nivel funcional todavía mayor: la respuesta incorporaba imágenes generadas en línea junto a un control deslizante para ajustar el número de comensales. Al modificar la cantidad de invitados, la lista de compra de ingredientes recalculaba automáticamente sus proporciones.
 Figura: Portada de la «Guía de la familia de modelos GPT-6» de OpenAI. Fuente: Anuncio oficial de OpenAI.
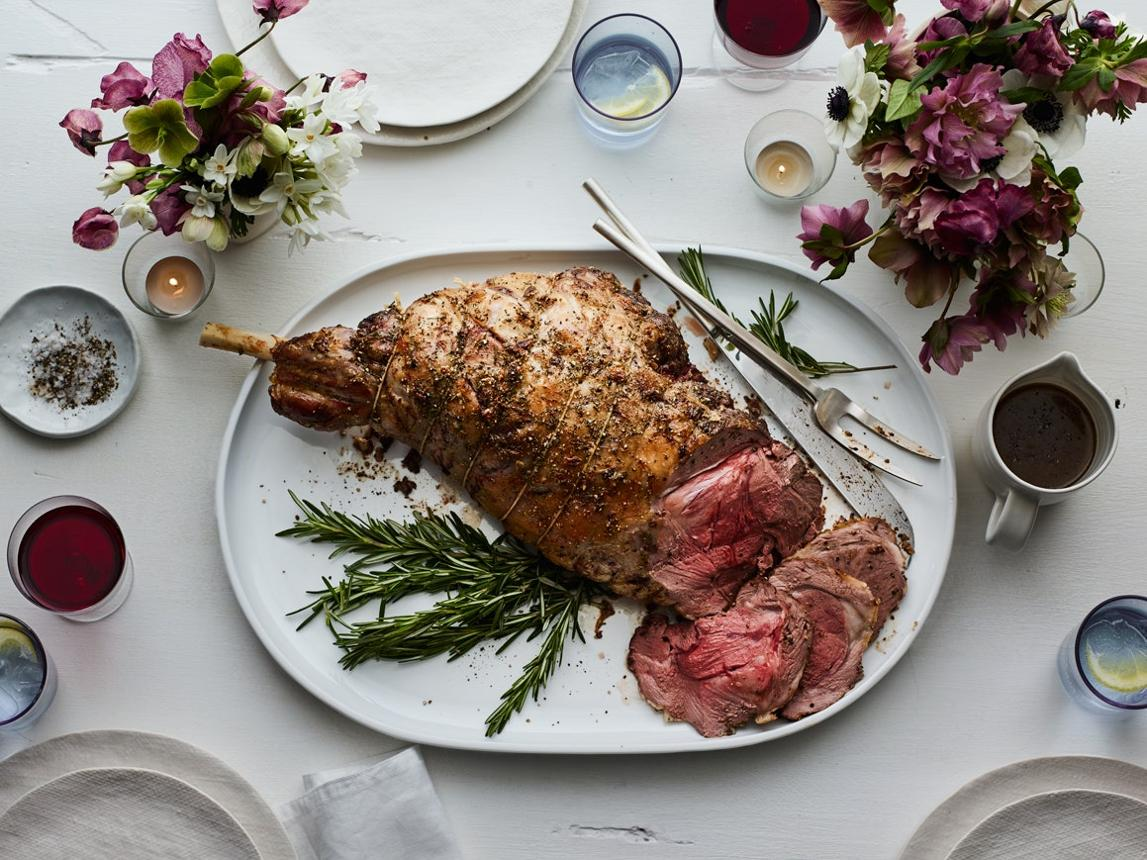 Figura: Imagen de pierna de cordero asada generada dentro de la respuesta de ChatGPT. Fuente: Publicación oficial de OpenAI.
El espacio tradicional de las aplicaciones desechables —calculadoras, divisores de cuentas o listas de tareas— queda absorbido directamente por el propio flujo conversacional. Si antes el usuario saltaba entre distintas aplicaciones independientes para completar una tarea, ahora la propia respuesta del chat asume la funcionalidad de la aplicación. La drástica reducción del coste de interacción permite resolver demandas fragmentadas y de baja frecuencia en su formato más ligero.
Ensamblaje restringido a una biblioteca de componentes predefinida
OpenAI ha detallado las fronteras de ingeniería de este mecanismo: un catálogo de componentes con soporte nativo para renderizado en streaming, vinculado a un compilador que procesa elementos de interfaz de manera concurrente con la emisión de texto. La interfaz emerge gradualmente en pantalla gracias al diseño de esta arquitectura subyacente. Durante el entrenamiento del modelo, los ingenieros reforzaron sus criterios sobre jerarquía de contenidos, maquetación, estilo visual y lógica interactiva, fijando la claridad, la utilidad y la exhaustividad como métricas indispensables de evaluación automatizada.
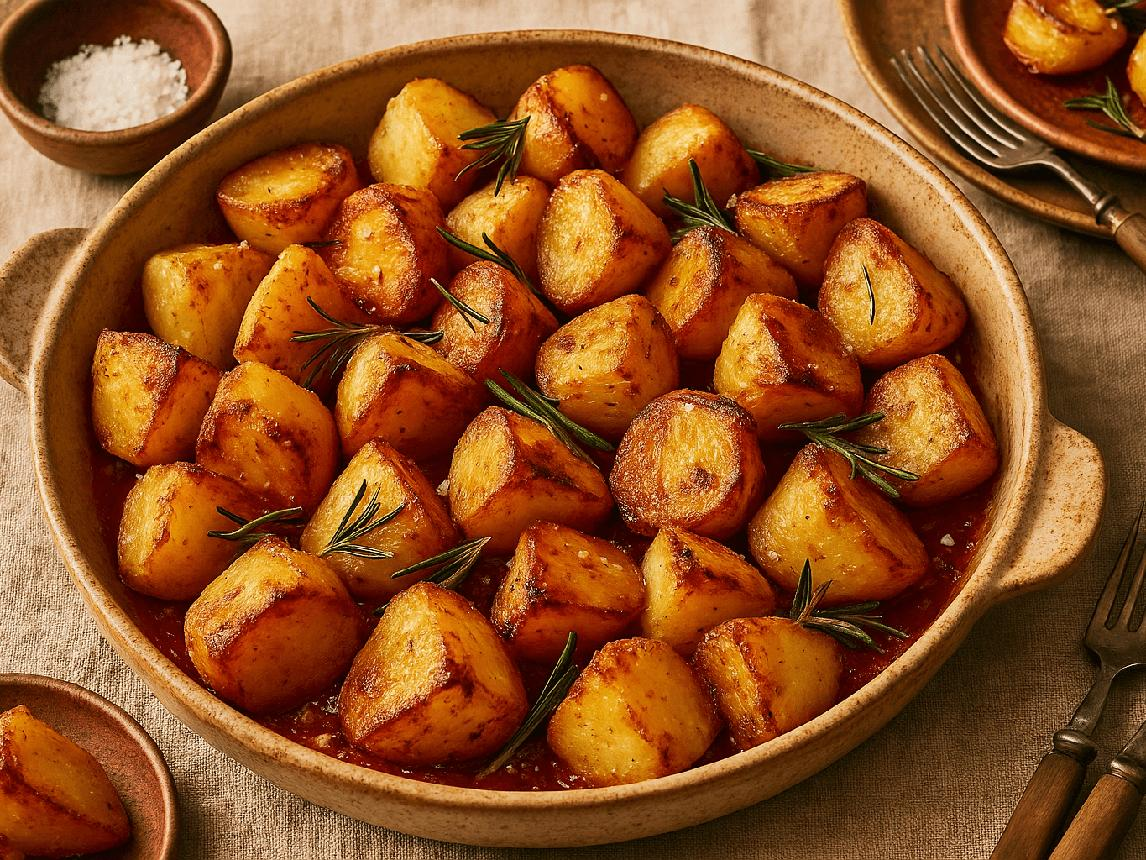 Figura: Imagen de patatas asadas crujientes generada en la misma respuesta. Fuente: Publicación oficial de OpenAI.
«El software adaptándose al ser humano» fue la frase utilizada oficialmente para resumir este cambio, pero dicha adaptación opera bajo reglas estrictas. El modelo solo combina y permuta piezas dentro de un catálogo cerrado, y OpenAI admite abiertamente que su criterio de diseño aún cuenta con amplio margen de mejora. El sistema cuenta con la facultad de ensamblar los bloques que le proporciona el motor base; todos los controles en pantalla provienen de dicha biblioteca preconfigurada. El modelo no inventa nuevos componentes de interfaz por su cuenta.
Pensar mientras responde: entrega incremental de resultados parciales
GPT-6 permite a ChatGPT razonar y emitir respuestas simultáneamente, una dinámica alineada con la filosofía de Intelligent UI: entregar en primer lugar resultados parciales inmediatamente aprovechables y completar los detalles a medida que avanza el cómputo. Datos oficiales señalan que, en consultas que exigen búsquedas web y herramientas externas, GPT-6 Instant entrega su primer token un 44 % más rápido de media que la generación anterior.
En las evaluaciones internas enfocadas en flujos agénticos cotidianos, la latencia inicial de respuesta de GPT-6 Extra High igualó los tiempos del nivel Medium previo, superando al mismo tiempo la tasa de resolución final del anterior nivel Extra High. La renderización continua de componentes en el cliente, combinada con la entrega fraccionada de resultados, llena el vacío de cálculo durante razonamientos complejos y aproxima el ritmo del sistema a los reflejos intuitivos humanos.
La System Card marca alto riesgo en dos áreas críticas
La System Card publicada en paralelo confirma que las versiones de octubre de GPT-6 Sol y GPT-6 Luna se sometieron a una evaluación exhaustiva bajo el marco Preparedness Framework. Las áreas de ciberseguridad y capacidades biológicas y químicas (CBRN) alcanzaron el nivel de clasificación «High capability». Por el contrario, la capacidad de automejora autónoma de la IA —foco de gran inquietud en el sector— todavía no ha cruzado el umbral de alto riesgo del protocolo.
La resistencia ante ataques de jailbreak también ha mejorado de manera notable. El modelo mantiene una mayor solidez ante agresiones adaptativas multironda, reduciendo la tasa de acatamiento de instrucciones engañosas o diseñadas para eludir las barreras de contención. En subpruebas específicas donde se detectaron ligeros retrocesos en puntuación, los equipos de seguridad ejecutaron verificaciones manuales y pruebas de penetración de equipo rojo (red teaming), concluyendo que dichas respuestas anómalas se sitúan en niveles de baja severidad.
La salida visual desata el dilema de la reproducibilidad
El brusco cambio en el formato de salida desató opiniones encontradas en la comunidad técnica. En los debates de Hacker News, varios usuarios manifestaron incomodidad ante las respuestas gráficas: ilustraciones auxiliares de página completa, espacios en blanco excesivos y listas interminables generaron la sensación de estar siendo tratados con condescendencia. Sus defensores argumentaron que, a la hora de presentar proyectos a clientes sin perfil técnico, el prompt de sistema más recurrente consistía precisamente en exigir explicaciones visuales y didácticas.
Si bien las interfaces interactivas representan un avance para perfiles no técnicos, introducen fricción visual para ingenieros que solo buscan una línea de código o un dato concreto. No obstante, la mayor inquietud se centra en la ingeniería: ante una misma instrucción, el modelo puede generar componentes con distribuciones totalmente dispares, y las pruebas automáticas de extremo a extremo junto con la reproducibilidad determinista carecen aún de soluciones técnicas claras. Varios desarrolladores señalaron que Gemini 3.8 ha optado por mantener un formato textual compacto, evitando la necesidad de añadir instrucciones defensivas adicionales para limpiar elementos visuales no deseados.
Las bibliotecas de componentes acortan la distancia hacia la monetización
En el mismo mes en que vio la luz esta actualización, OpenAI avanzaba en el desarrollo de formatos publicitarios y modelos de atribución dentro de ChatGPT. La posibilidad de integrar formularios de captura, botones de acción y widgets interactivos directamente en la ventana de chat permite trascender los enlaces de texto convencionales a la hora de monetizar el servicio.
Desde una perspectiva técnica, generar una lista interactiva de ingredientes o mostrar un módulo publicitario con enlace directo de compra involucra exactamente la misma biblioteca de componentes en streaming. Con el control de la densidad visual delegado en el motor de renderizado del cliente, la distancia entre un widget dinámico y una transacción completada queda supeditada únicamente a una decisión de producto.
Enlaces de referencia:
- Anuncio oficial de OpenAI
- System Card de GPT-6 de OpenAI
- Cobertura de MacRumors
- Discusión en Hacker News