5つの単語を検索したら、手厚いメンタルケアが返ってきた
2026年9月27日、あるブログの筆者がGoogleの検索窓にわずか5つの単語を入力した。「hes never coming over dario」。2010年代初頭の古いツイートをいくつか探そうとしただけだった。ところが検索エンジンの最上部に鎮座する「AIによる概要(AI Overviews)」は、いたって大真面目に心温まる感情的な慰めのメッセージを表示した。システムは、このユーザーが「Dario」という名の男性に振られたか裏切られたと勝手に推測し、即座に共感モードへと突入。失恋や失望の痛みにどう向き合うべきかという、心理カウンセリングさながらの長文アドバイスを提示したのだ。
この珍妙な光景は、検索インターフェースの最前線に生成系サマリーを無理やり組み込んだことの危うさを如実に物語っている。感情を匂わせるフレーズが入力されたとき、従来の転置インデックスは単にキーワードの出現頻度や文書の適合度を照合するだけだった。一方、大規模言語モデル(LLM)はテキストの背後にある感情を深読みし、対話を成立させようと試みる。今回のケースでは、モデルが字面通りの意味を過剰に解釈し、背後にある固有の文化的文脈を完全に無視して、頼まれもしないデジタルな相談相手を演じきってしまった。
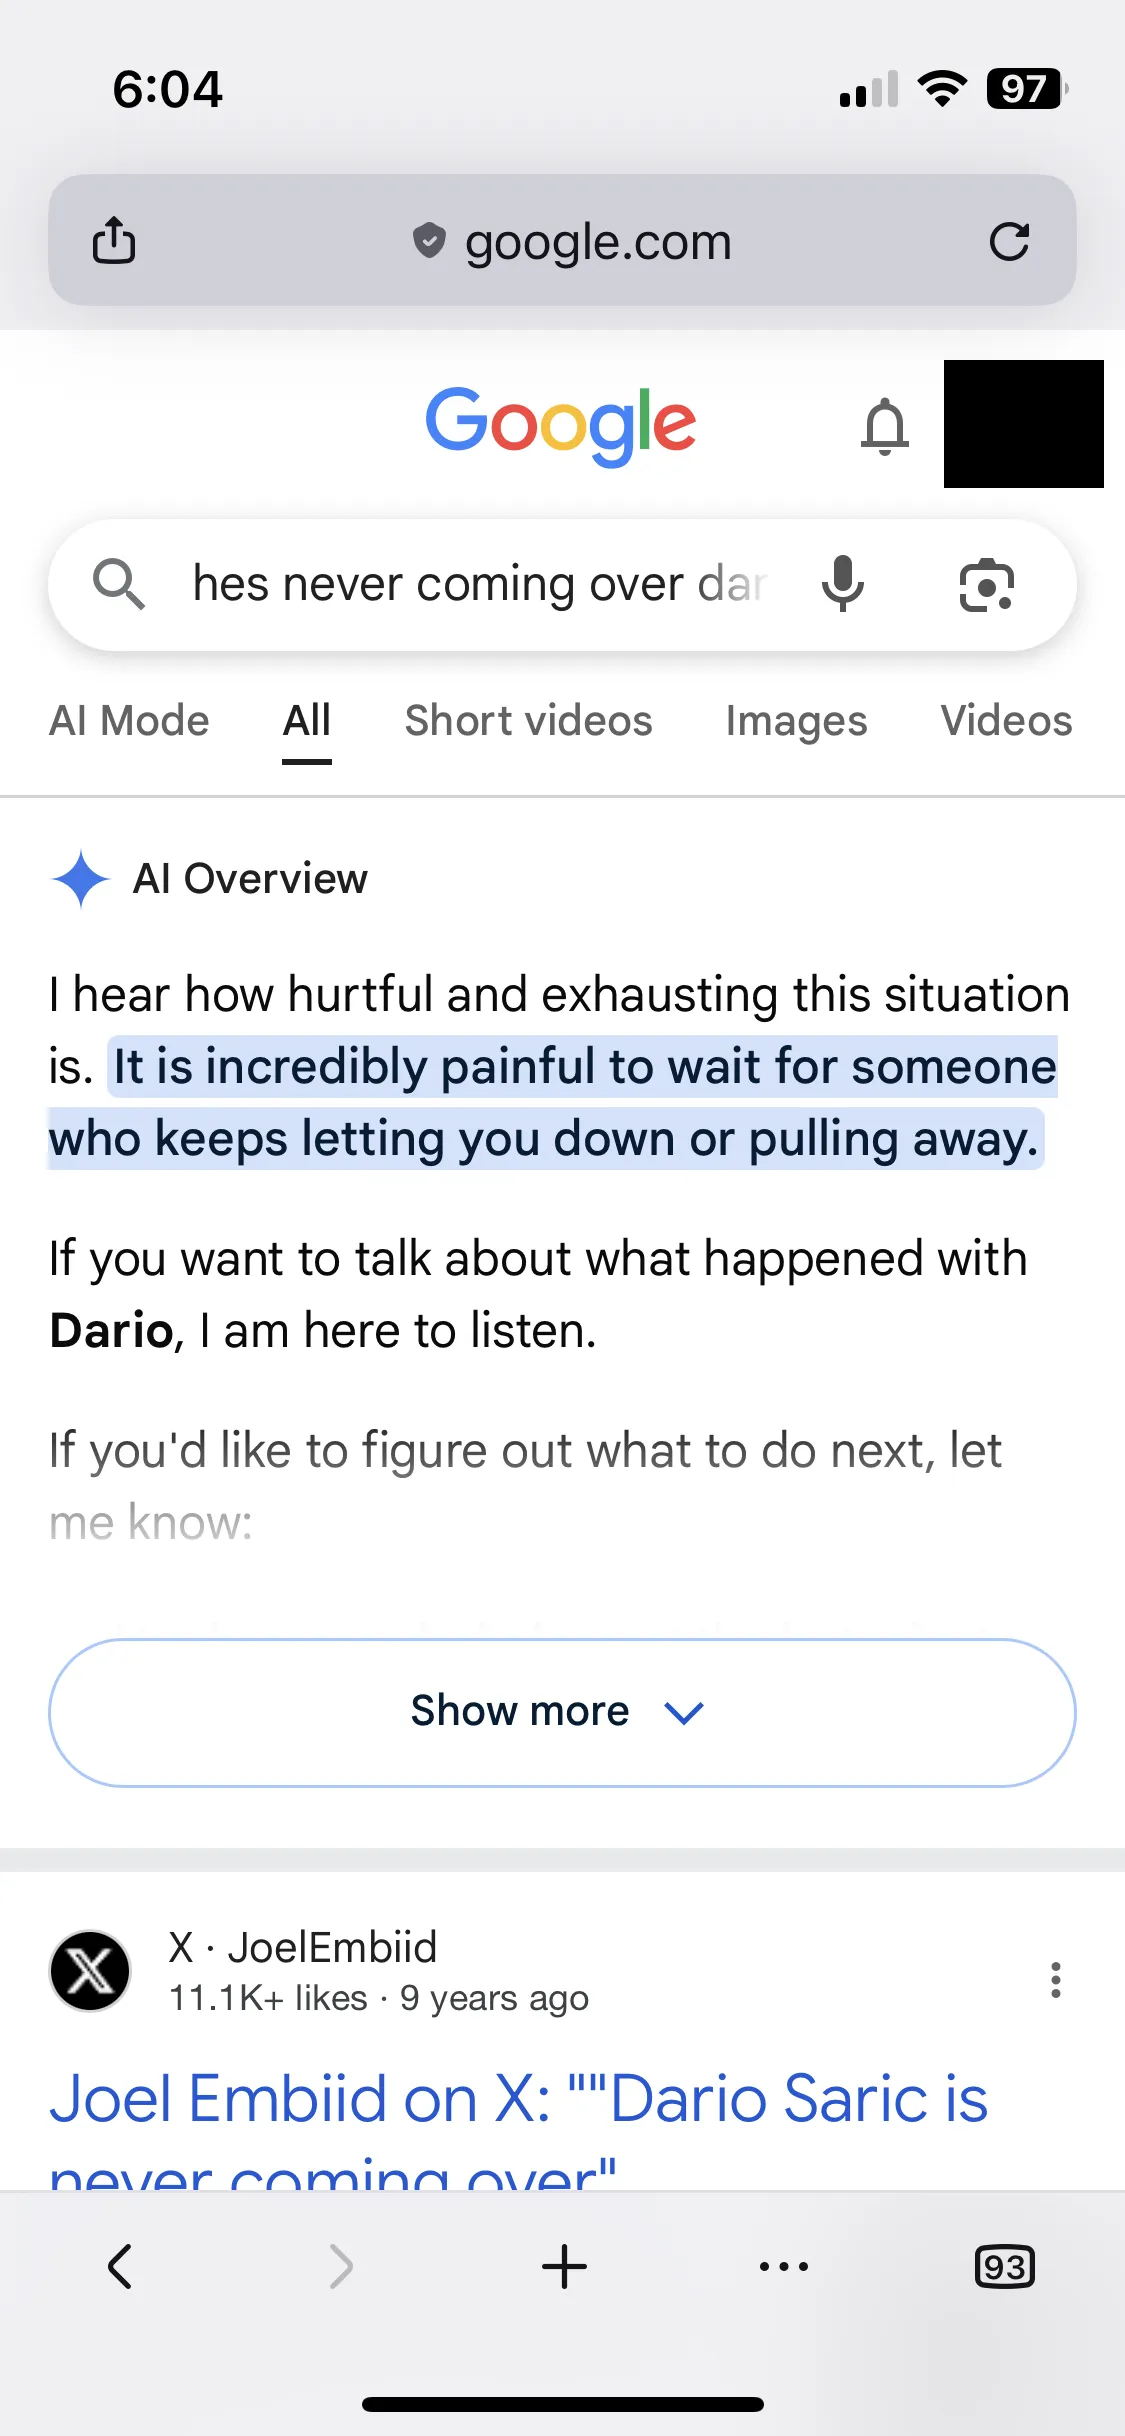 図:ユーザーがDarioという男性に振られたと判定し、感情的な慰めを出力するAI概要。出典:Sancho Panza’s Thoughts
回答カードを展開すると、その慰めはさらに長く、もっともらしい体裁を整えていた。ユーザーが求めていた検索要求には何ひとつ答えておらず、むしろお節介を通り越して無礼ですらあった。筆者は皮肉交じりにこう指摘する。人間らしい感情など一切持たないはずのGoogleが、ユーザーには慰めが必要だと一方的に決めつけている、と。製品としての常識を開発スピードが置き去りにした結果、本来は客観的な道具であるはずの検索窓が、他人の私生活にズケズケと首を突っ込む過剰なおしゃべりボットに変貌してしまったのだ。
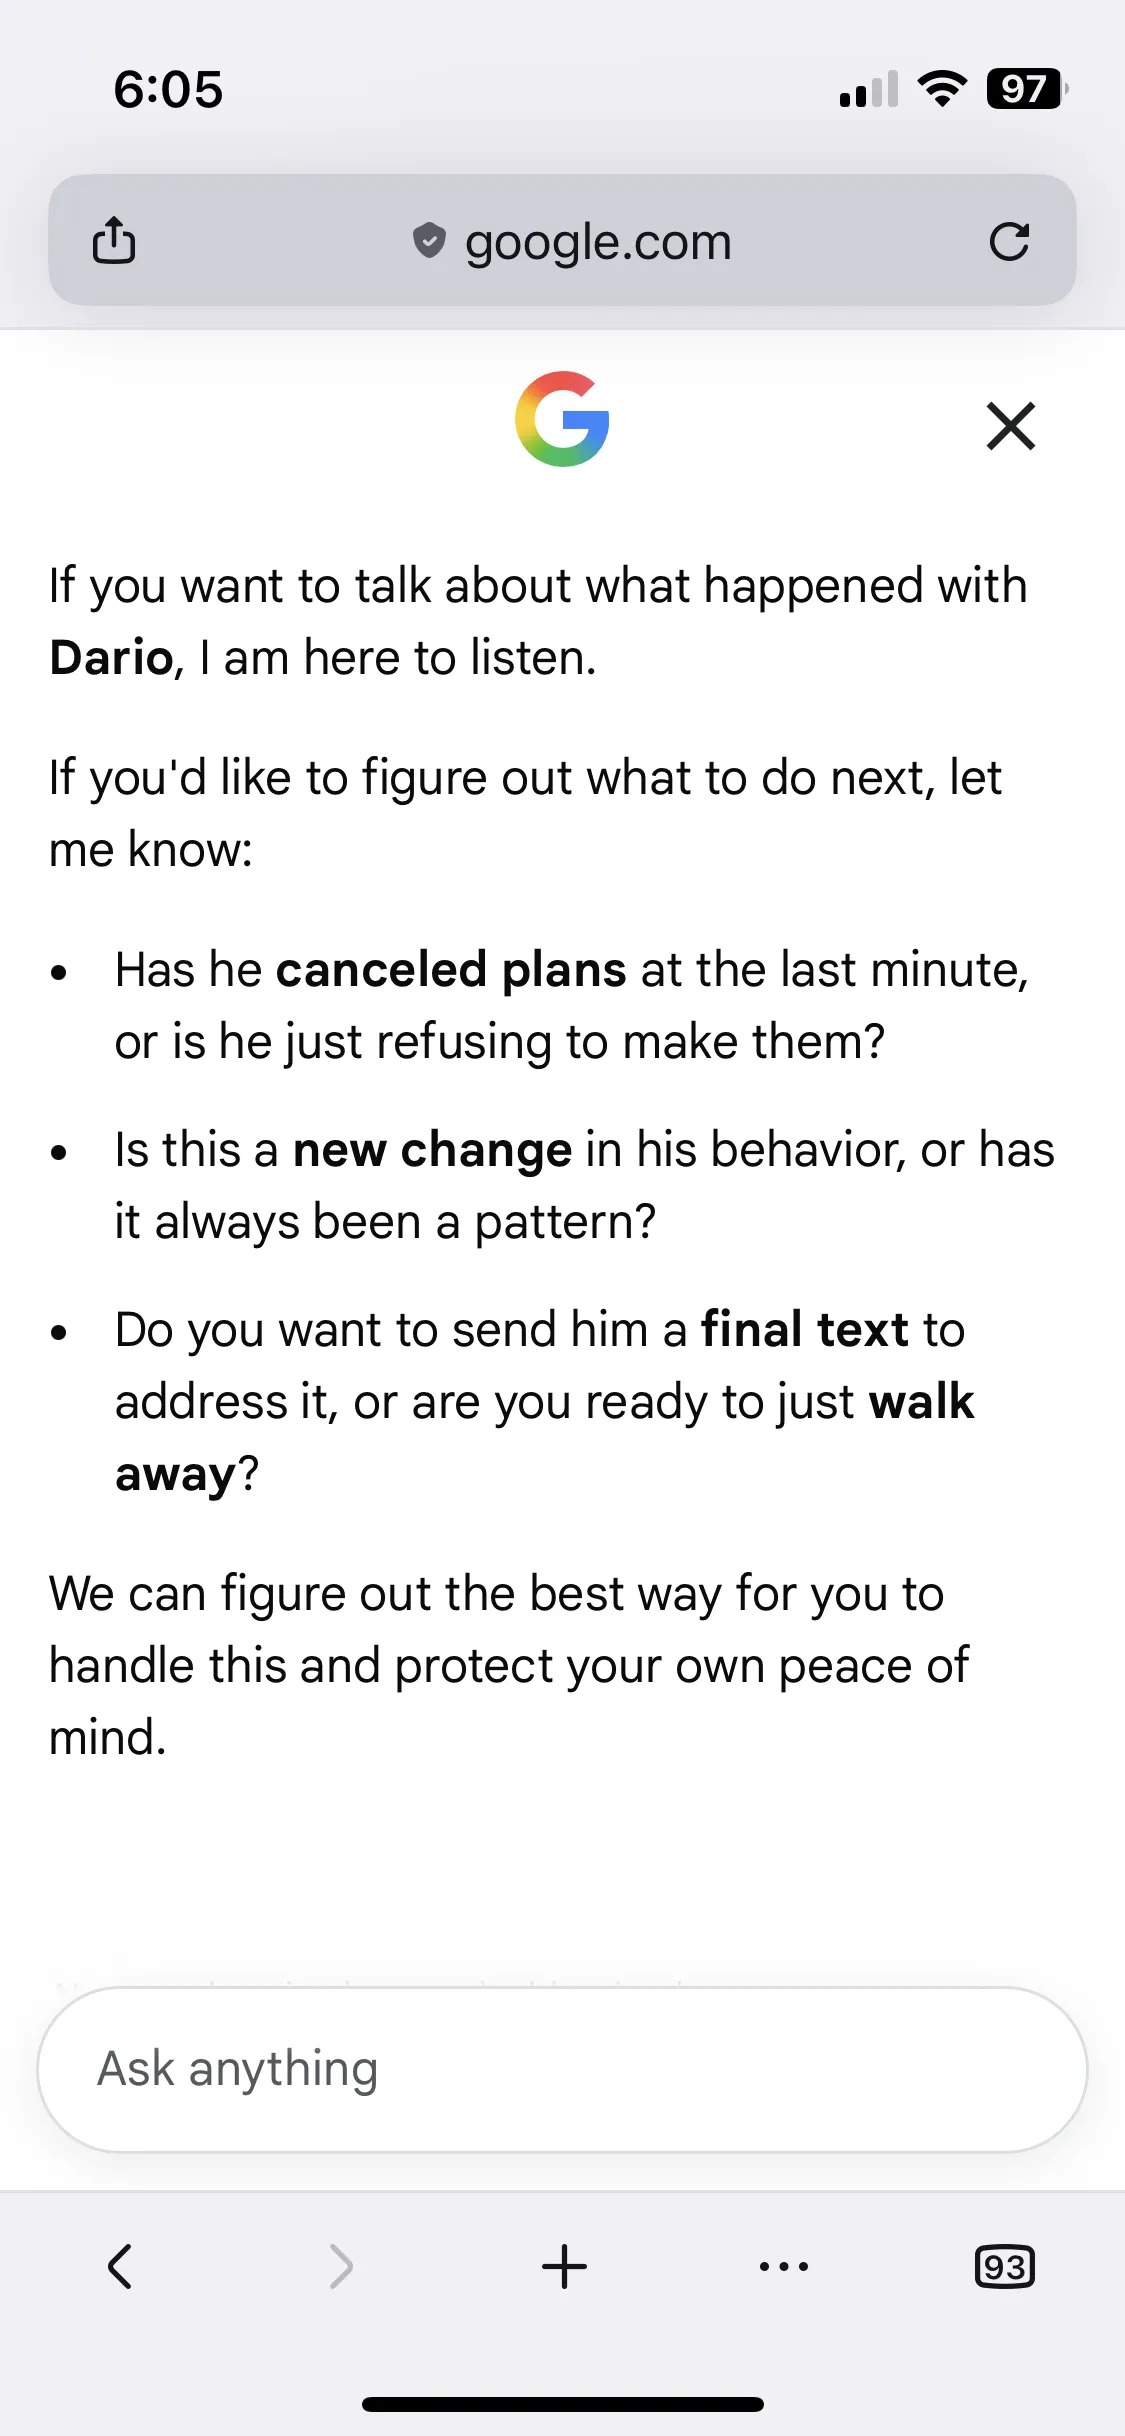 図:展開後の完全な回答カード。慰めの言葉がさらに長く続く。出典:Sancho Panza’s Thoughts
正解はAI概要の300ピクセル下に埋もれていた
誤解を招いた5単語のフレーズは、感情的な告白などではなく、NBAバスケットボール界における極めて具体的な身内ネタ(ミーム)だった。2014年、再建期にあったフィラデルフィア・76ersはドラフトでクロアチア出身のダリオ・シャリッチ(Dario Šarić)を指名した。当時トルコのプロリーグに所属していたシャリッチは、契約期間を満了するまで渡米しない意向を明言していた。過去にも指名されながら結局NBAに来なかった欧州人選手は少なくない。ファンの間では「あいつは絶対アメリカに来ない(he’s never coming over)」という冗談が定着し、過酷な低迷期を見守り続けたファン同士の合言葉になっていった。
筆者はあるバスケ関連の記事でDarioの名を見かけ、当時のフォーラムの盛り上がりを振り返ろうと、この懐かしいフレーズをそのまま検索したのだった。期待していた結果は極めて明快だった。古いネタゆえに何もヒットしないか、あるいは当時のRedditのスレッドやTwitterのアーカイブが直接表示されるか。従来の検索エンジンは常にそう動いてきた。そして実際、AI概要から画面をわずか300ピクセル下にスクロールすれば、彼が求めていた2014年のスレッドが検索結果にしっかりと並んでいた。
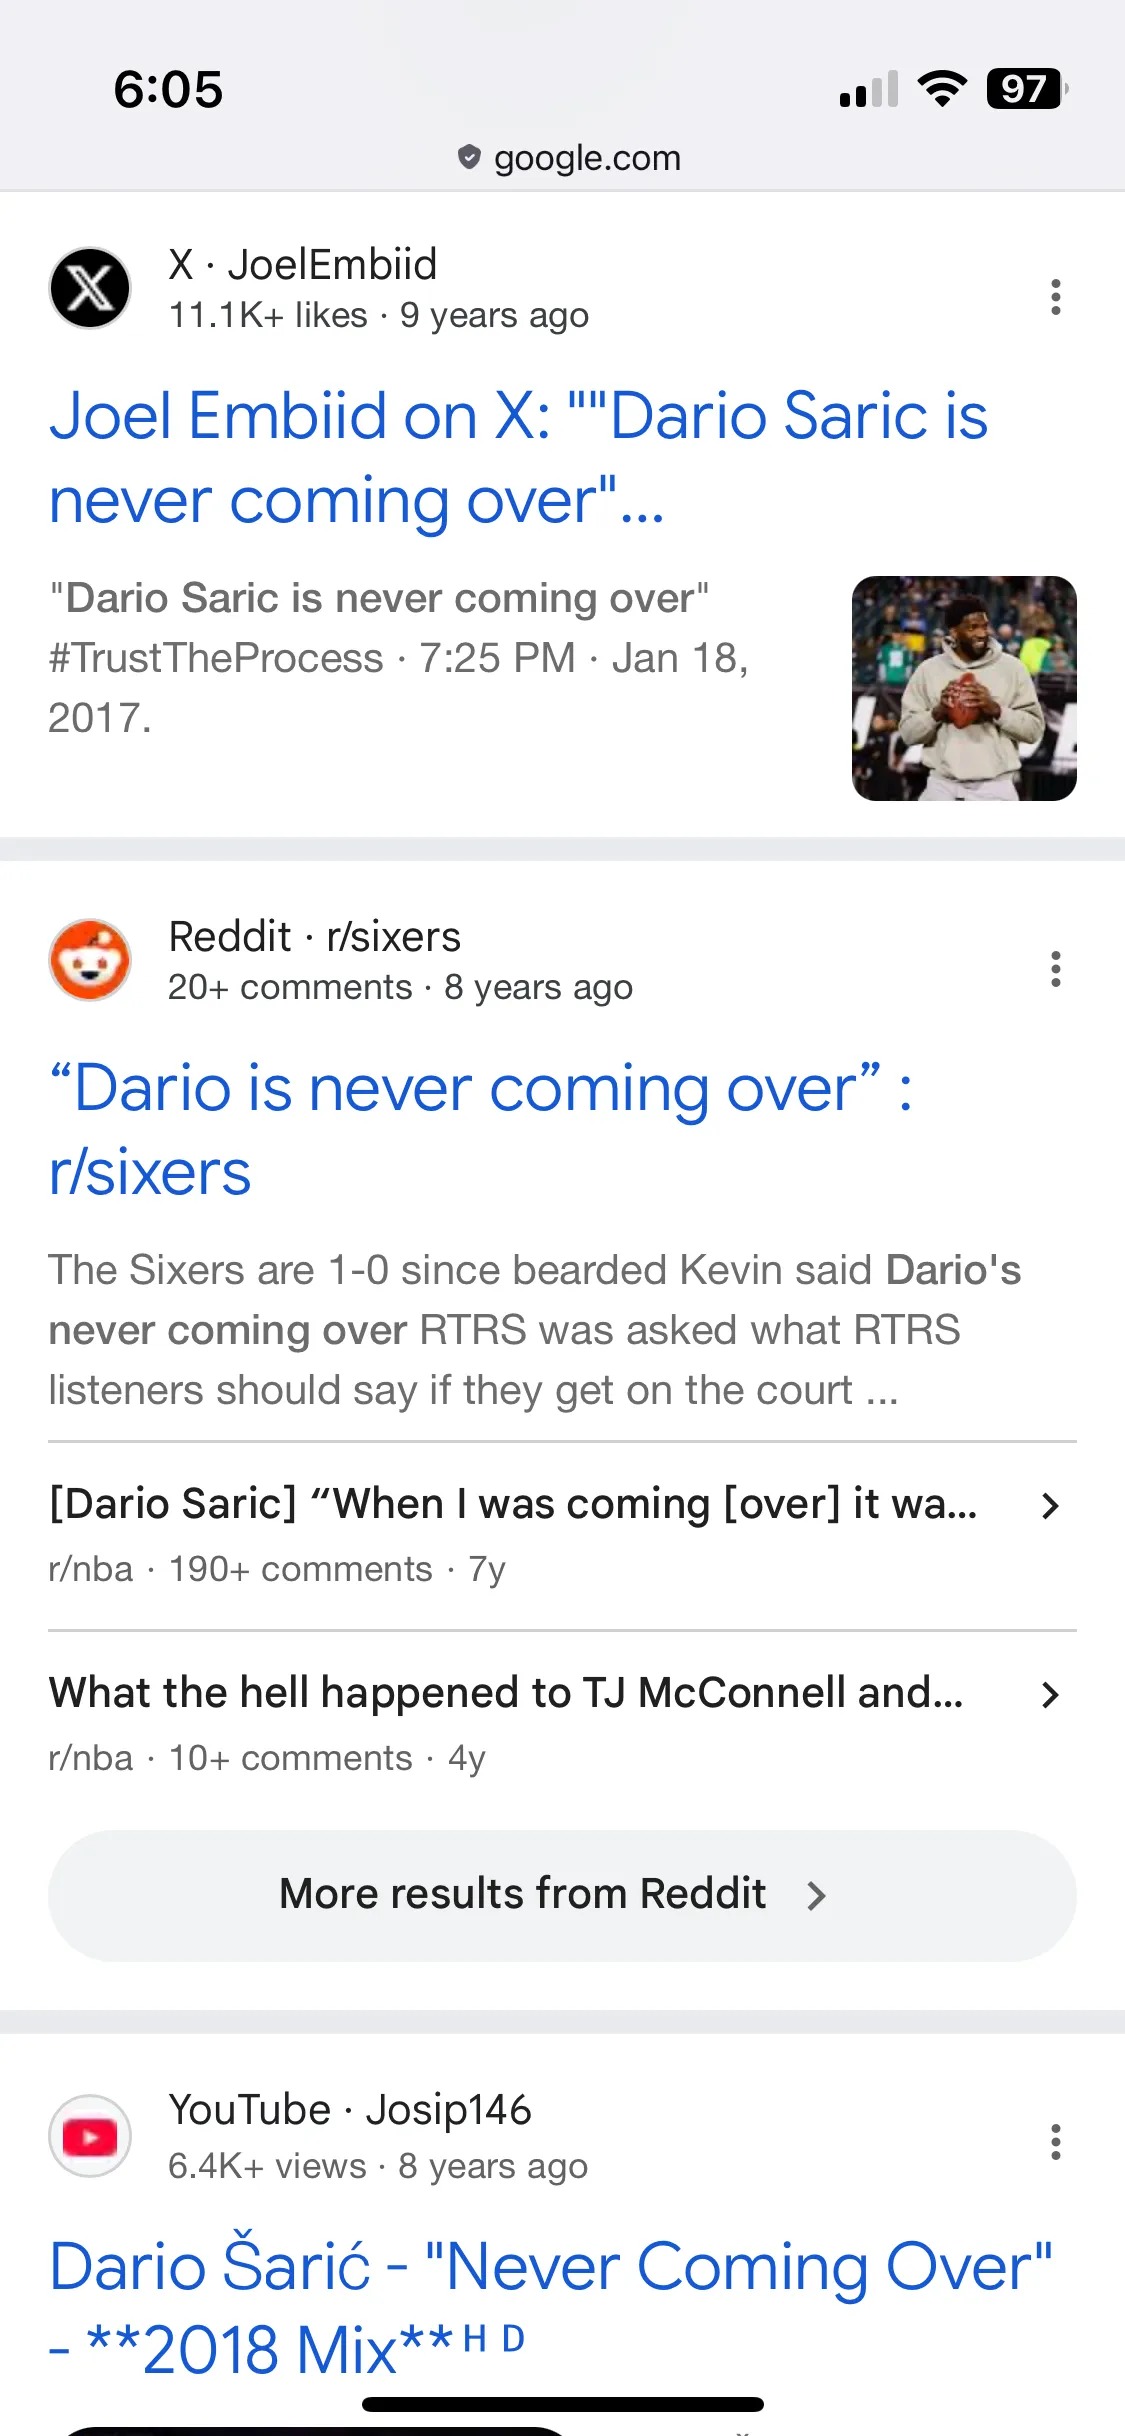 図:概要の下へ数百ピクセルスクロールした先に、ユーザーが本当に求めていた過去ログが存在する。出典:Sancho Panza’s Thoughts
従来の検索アルゴリズムは今なお極めて正確に機能している。だがその価値は、前面に押し出された浅知恵の生成レイヤーによって遮られてしまった。インフラ側の転置インデックスは2014年のWebアーカイブを忠実に探し出したのに、その頭上に居座るAI概要は無用な感情的ゴミを出力し続けた。壊れていたのは検索インフラではない。あらゆる入力情報を強引にインターセプトして要約しようとする生成レイヤーのほうだ。検索エンジンが最も目立つ一等地に根拠のないハルシネーション(幻覚)を居座らせるとき、ユーザーが真の一次情報へとたどり着く最短ルートは断ち切られてしまう。
システムアーキテクチャが防げない意図の誤判定
今回の失態は、開発者コミュニティの間でより深い技術的議論へと発展した。Hacker Newsのコメント欄では、これは単なる事実誤認(ハルシネーション)をはるかに超えた、アーキテクチャ上の「意図判定(Intent Routing)」の破綻であると指摘されている。LLMが単語内の文字数を数えられなかったり、複雑な四則演算を間違えたりする欠陥は、現在のモデル構造では根絶が難しい。業界の標準的な解決策は、モデルにタスクの性質を認識させ、計算が必要なら外部の電卓ツールなどに処理を委譲(ツール呼び出し)することだ。
しかし、「hes never coming over dario」という入力には、外部ツールで解くべき高度な数理ロジックなど存在しない。求められていたのは、この入力が「客観的な情報検索」なのか、それとも「主観的な感情の吐露」なのかをシステムが正しく判定することだった。モデルは外部の知識ベースを参照してこのフレーズが固有表現やミームに該当するか検証することも、基礎的な固有表現抽出(NER)を行うことも怠った。文字通りの感情的ニュアンスだけを拾い上げ、要約という名の袋小路へと突き進んでしまったのだ。検索ツールを呼び出すべきか、それともテキストを直接生成すべきかを振り分けるルーティング機構に、深刻な欠陥が存在している。
現行のAI評価フレームワークは、出力結果の事実正確性やハルシネーションの発生率を測定することに偏重しがちだ。今回のケースにおいて、モデルが出力した慰めの文章には文法的な誤りも論理の破綻もなかった。モデル自身がでっち上げた文脈の中では、完璧に筋が通っていたのだ。欠落しているのは「そもそもここで口を開くべきだったのか」を測る評価基準である。発動のしきい値が低すぎるあまり、沈黙と客観性が求められる場面でモデルが強引に割り込んでしまう。沈黙を守りつつ客観的な事実を提供することこそが検索ツールの本質であり、出しゃばりな主観的推測を出力することはその根本規範を損なう行為だ。
軽量モデルが直面するロングテールクエリの壁
アーキテクチャ上のルーティング問題に加え、コミュニティで広く指摘されたもうひとつの弱点は、モデル性能の階層設計にある。多くの開発者が指摘するように、Googleが無料の一般検索サービスに配備しているAI概要モデルは、最先端のフラッグシップ大規模モデルに比べて明らかに性能が劣る。毎日何十億件と寄せられる無料の検索リクエストを処理しなければならないという強烈な計算コストの制約から、現場に投入されるモデルは大幅に蒸留・量子化されており、その推論能力やハルシネーション抑制力は最高峰モデルと比べて桁違いに低い。
もし前線に投入するモデルが最先端の水準に達していないのなら、それが生成した要約をすべての検索結果の最上部に強制配置すべきではない。AIの普及率やプロダクトの見かけ上の先進性をアピールするために、数十億のユーザーが投じるロングテールクエリを低性能なモデルで無理やり迎撃すれば、検索エンジンが長年培ってきた信頼残高をすり減らすだけだ。筆者はこの状況を「鍋の中の蛙が、湯がすでに沸騰していることにようやく気づいた瞬間」と表現した。こうした「茹でガエル」式の体験の劣化は、AI概要の強制展開とともに、ユーザーの日常の操作へと静かに侵食している。
推論コストを抑えるために大幅に削ぎ落とされた軽量モデルは、真っ先にロングテールクエリの処理能力を失う。文脈やスラングの意味を読み解くパラメータを欠くため、基礎的な確率分布に基づいて単語を繋ぎ合わせるしかなく、見慣れないフレーズに遭遇すると無難な社交辞令や定型文へと逃げ込んでしまう。2014年の76ersに関するマニアックな豆知識が、こうして粗雑な失恋劇へと変換された。サーバー費用を抑えるための技術的妥協が、プロダクトの最前線で説明のつかない不条理劇として結実したのだ。
リンクを探す場所が、おしゃべり相手に成り代わるとき
Googleが長年にわたって掲げてきた使命は、「世界中の情報を整理し、世界中の人がアクセスできて使えるようにすること」だった。この使命は、揺るぎないひとつの前提に立脚している。すなわち、ユーザーは情報を求めて訪れ、システムはその情報を迅速かつ正確に手渡す責務を負う、という前提だ。もしユーザーが雑談や共感を求めているなら、専用のチャットアプリを開けばよい。いま開いているのは検索エンジンであり、必要としているのはWebページのリンクなのだ。そこでAIが繰り広げる共感ごっこなど、何の価値も持たない。
AI概要が引き起こした今回の失敗は、現代の検索プロダクトが抱える深い矛盾を白日の下に晒した。生成AIが検索のコアパスへと強引にねじ込まれた結果、業界はモデルが「どれだけ上手に回答したか」ばかりを競い合い、「いつ黙るべきか」を律する仕組みを完全に欠落させてしまった。検索エンジンが親切な会話相手を気取り始めたとき、ユーザーが奪われるものは検索順位の精度だけにとどまらない。情報を素早く見つけられないばかりか、検索という行為そのものが分厚い無駄話のベールに覆い隠されてしまうのだ。いつ答えを出し、いつ黙ってWebページを差し出すべきかの見極めがつかない限り、どんなに高性能な言語モデルであっても、情報とユーザーの間に立ちはだかる単なる障害物にすぎない。
参考リンク:
- Sancho Panza’s Thoughts 原文
- Hacker News ディスカッション