搜 5 个单词换来一段情感安抚
2026 年 9 月 27 日,一位作者在 Google 搜索框里输入了 5 个单词:「hes never coming over dario」。他原本只是想找几条 2010 年代的旧推文,结果搜索引擎在最顶端的 AI 摘要(AI Overviews)里,郑重其事地给出了一段情感安抚。系统假定这位用户被一个名叫 Dario 的男人伤害或抛弃了,于是切换到共情模式,提供了一整套关于如何应对心碎和失望的心理支持方案。
这个荒谬的场景暴露了生成式摘要在搜索前台的失控。当用户输入带有情绪色彩的短语时,传统倒排索引会比对关键词频率。语言模型则试图揣摩情绪并生成对话。在这个案例中,模型过度解读了字面意思,直接绕过背后的具体文化语境,强行扮演起数字朋友的角色。
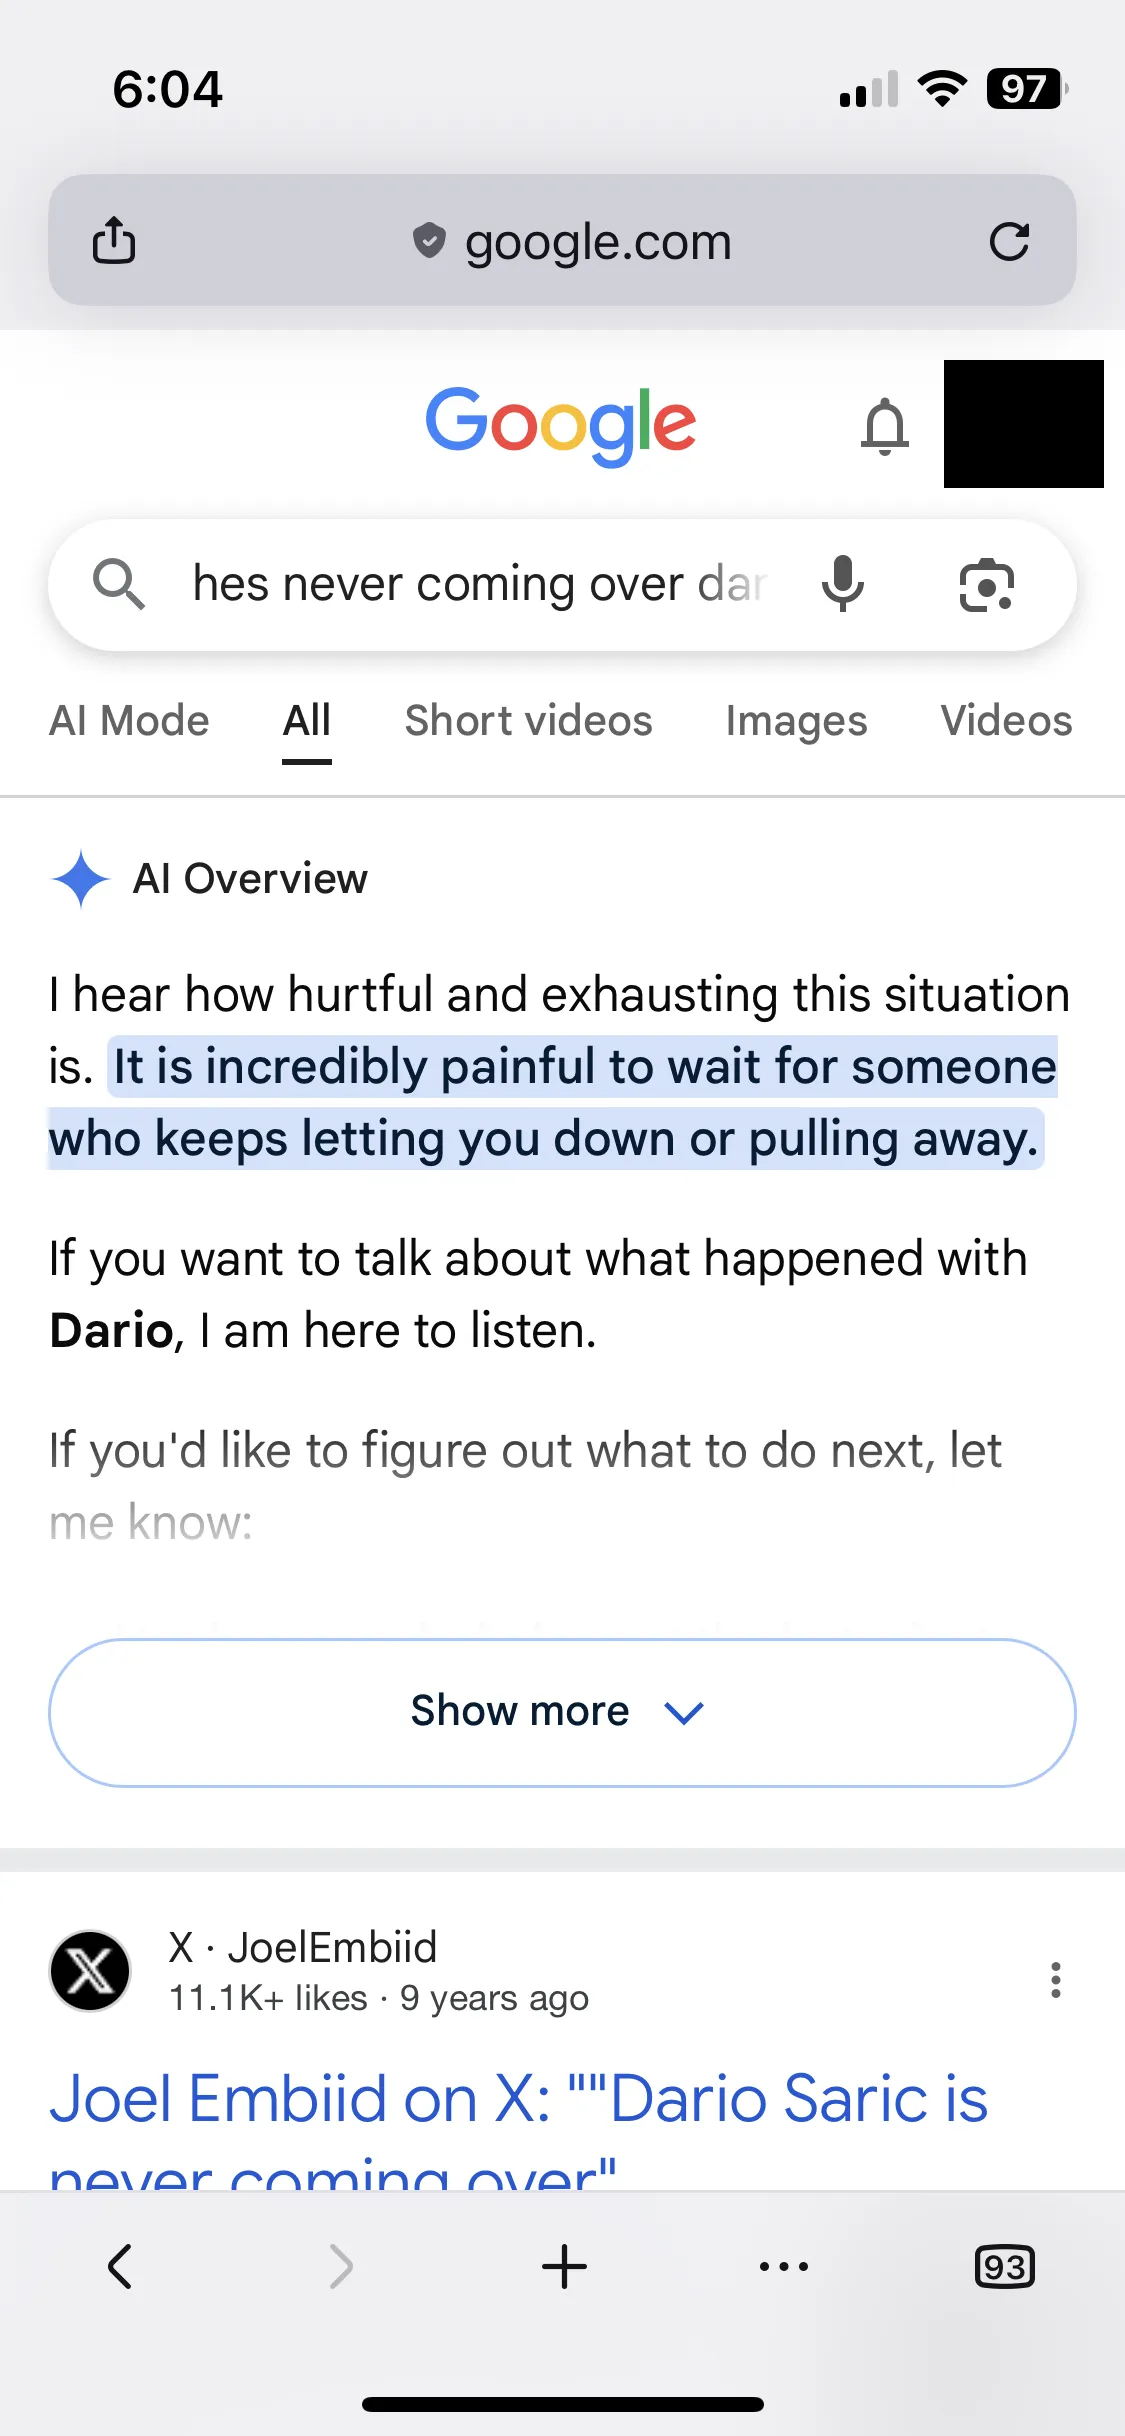 图:AI 摘要判定用户被名为 Dario 的男性抛弃,给出情感安慰。来源:Sancho Panza’s Thoughts
展开完整的回答卡片后,这段安慰的话术甚至变得更长、更像模像样。这段话术没有解决任何检索需求,反而构成了一种冒犯。作者讥讽道,Google 是一个没有任何人类情感的搜索引擎,却自作主张地认为用户需要被安慰。开发速度压过产品常识时,原本作为客观工具的搜索栏,已经变成了一个随时准备介入私人生活、过度热情的聊天机器人。
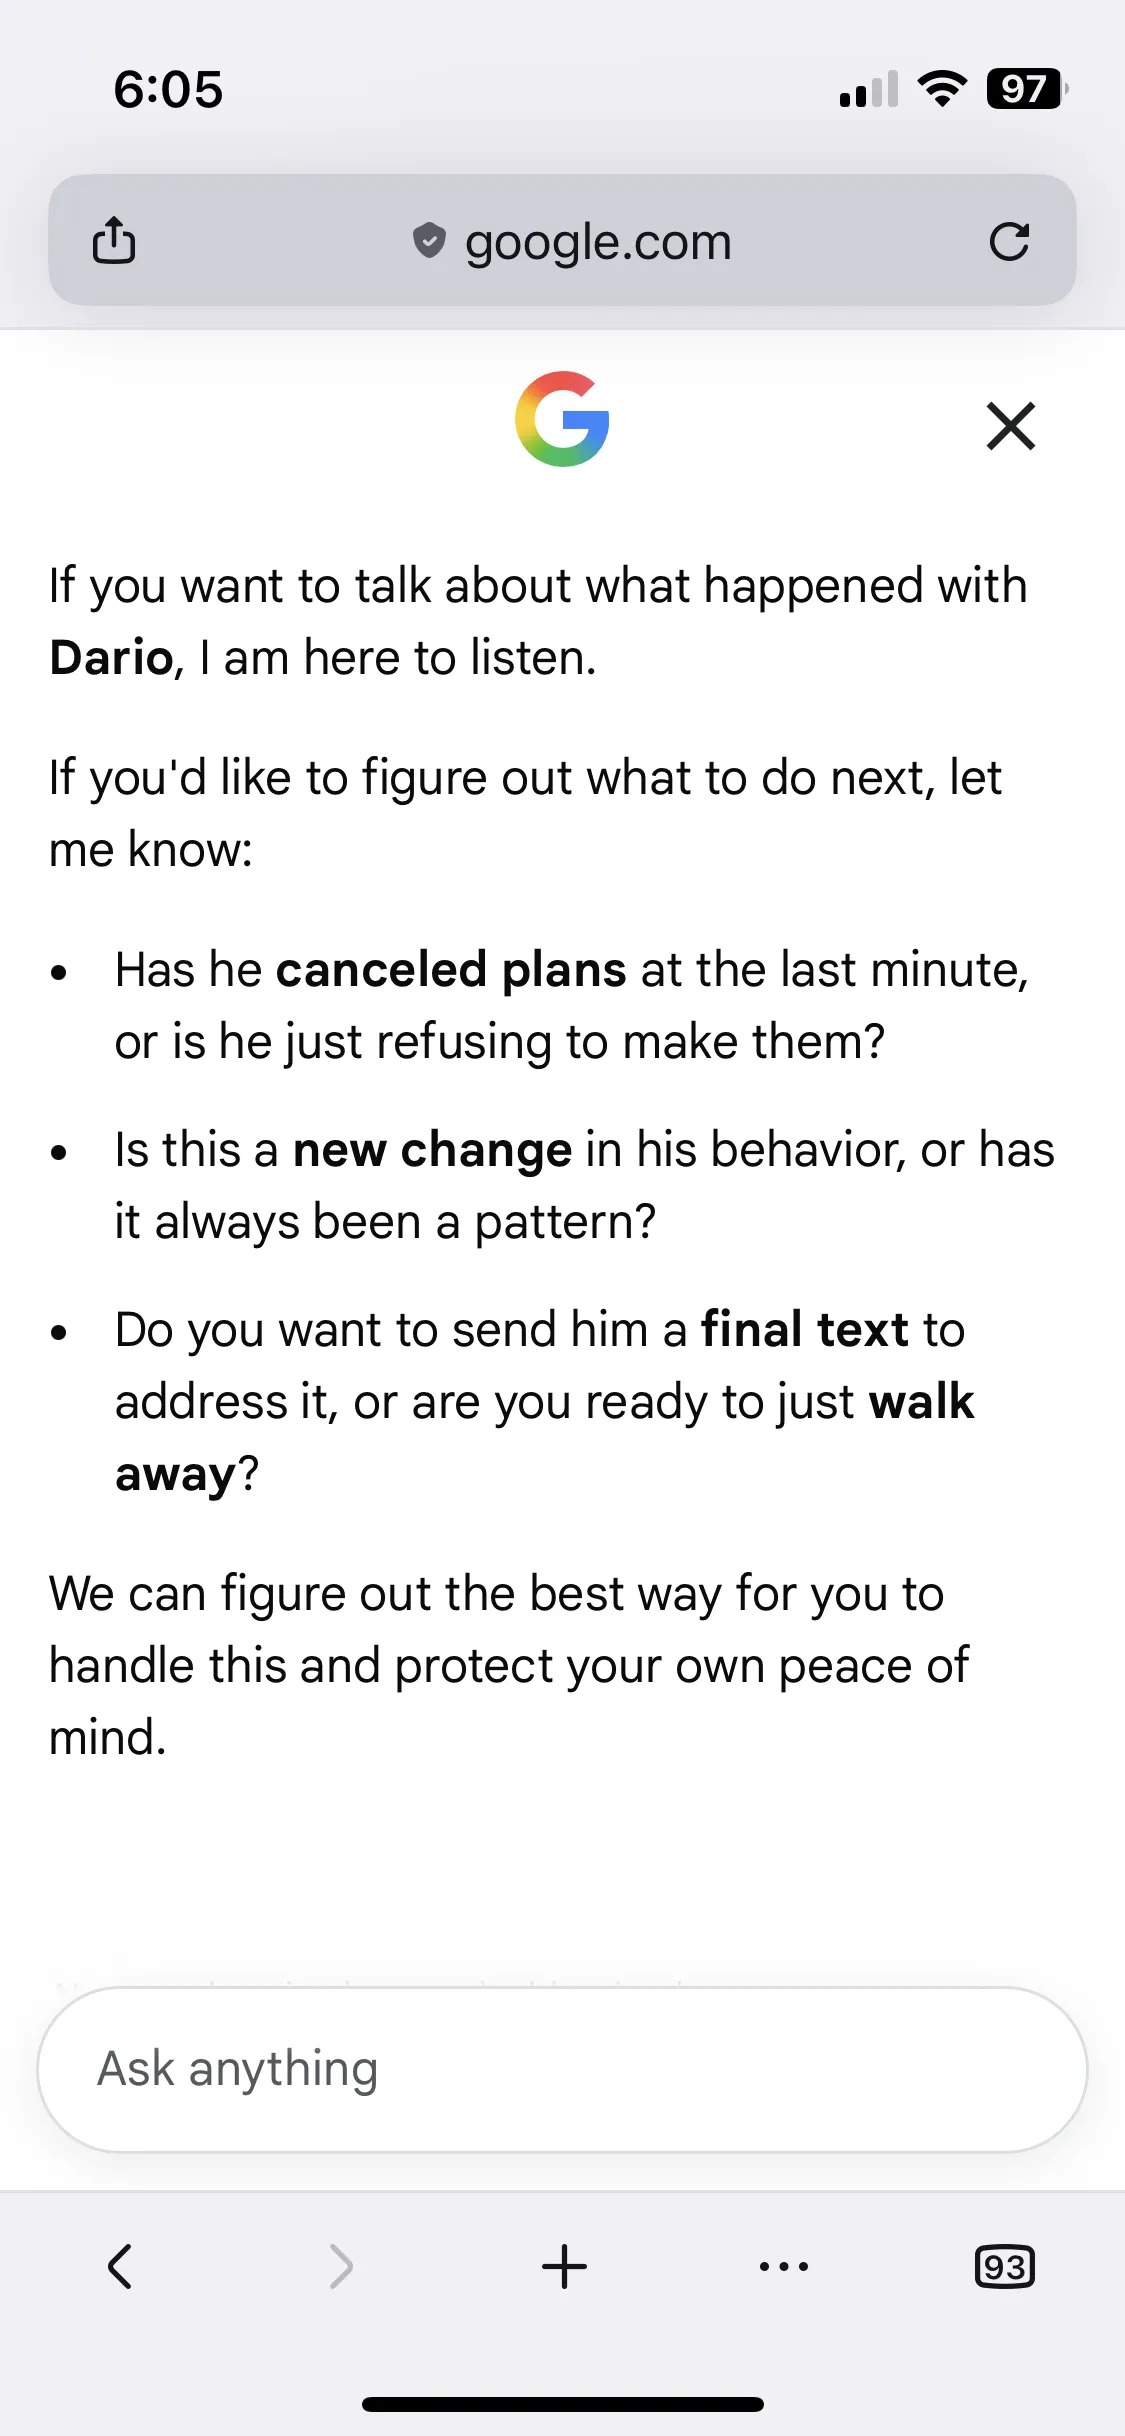 图:展开后的完整回答,安慰话说得更长。来源:Sancho Panza’s Thoughts
正确答案被压在 300 像素之下
这个引发误会的 5 词短句,实际上是一个具体的篮球圈内部梗。2014 年,正处于重建期的费城 76 人队在 NBA 选秀中挑中了 Dario Saric。当时他还在土耳其打职业联赛,并公开表示要打完合同才去美国。过去有很多欧洲球员被选中后从未登陆 NBA。球迷圈由此造出了「he’s never coming over」这个玩笑。随着时间推移,这成了那批见证了球队岁月的球迷之间心照不宣的暗号。
作者在阅读一篇篮球文章时看到了 Dario 的名字,想回溯一下当年的论坛讨论,于是原封不动地搜了这句老梗。他的预期非常清晰:要么因为时间久远什么都搜不到,要么直接跳出当年的 Reddit 帖子或推特存档。传统搜索引擎正是如此运作的。在 AI 摘要下方滚 300 像素,他要找的 2014 年旧帖子正躺在结果页里。
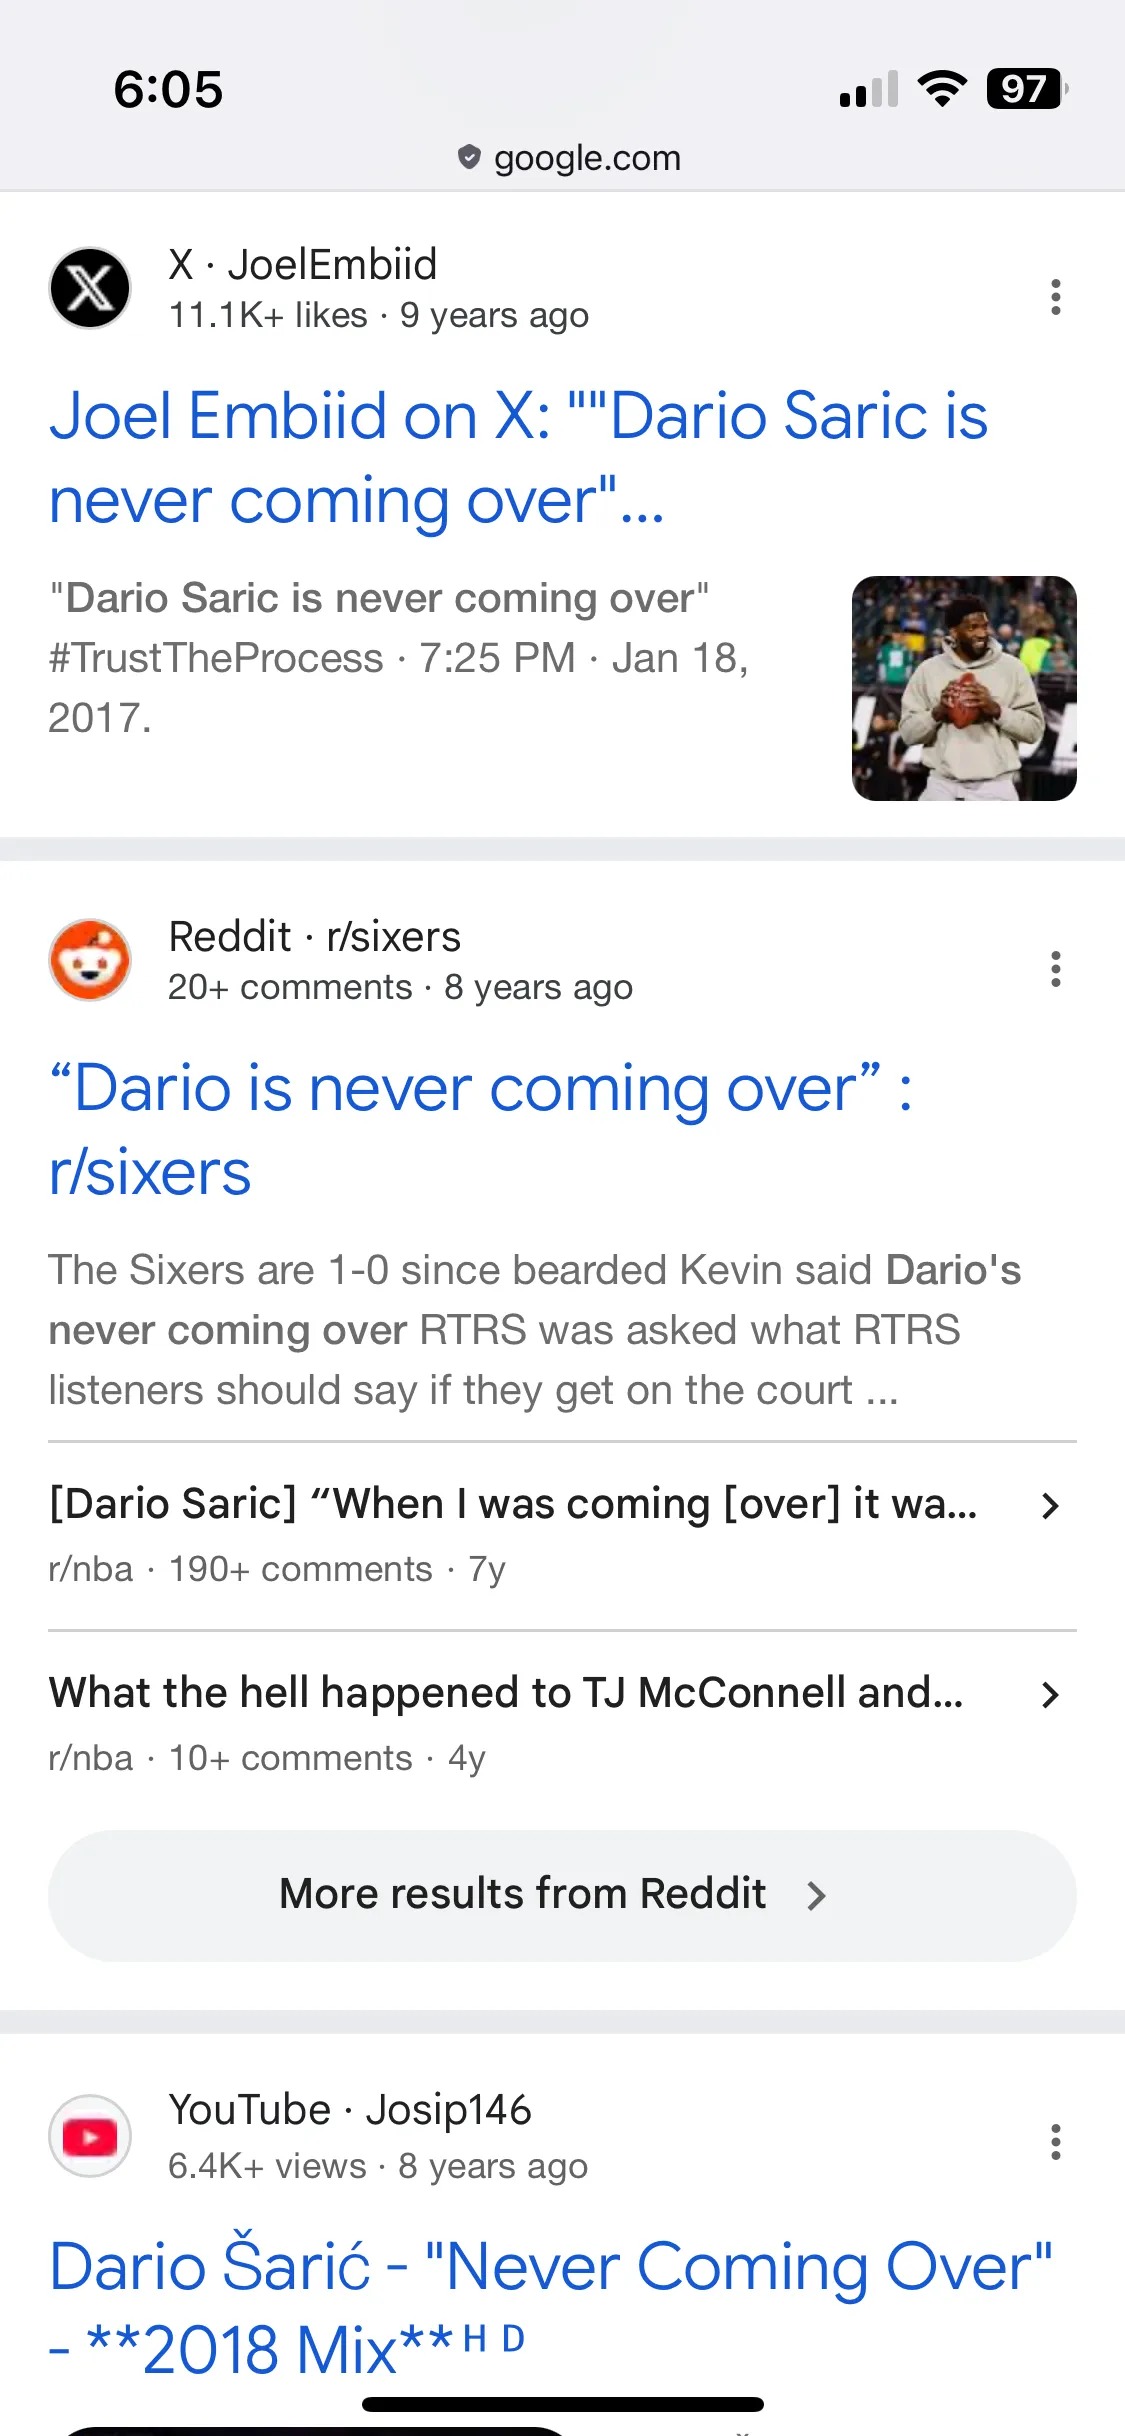 图:摘要下方几百像素处,才是用户真正要的旧帖。来源:Sancho Panza’s Thoughts
传统搜索依然精准,它的价值却被一个自作聪明的前置层遮盖了。传统算法忠实地匹配了 2014 年的网页存档,压在它头顶的 AI 摘要却在输出无用的情绪垃圾。基础设施没有坏,坏的是那个想要强行拦截、总结所有输入信息的生成层。当一个搜索引擎把最黄金的屏幕空间留给毫无事实依据的幻觉生成时,它切断了用户直达真实信息的路径。
系统架构拦不住错判意图
这次翻车在技术社区引发了更深层的讨论。在 Hacker News 的评论区,开发者们指出,这是一次架构性的意图错判,远远超出了简单的事实错误(幻觉)。语言模型数不清单词里的字母,也算不对复杂的算术,这类缺陷在当前架构下几乎无法根除。主流的解决路径是让模型识别出特定任务。然后将任务转交给计算器等外部工具执行。
但在「hes never coming over dario」这个输入中,并不存在需要外部工具解决的数理逻辑。它需要的是系统判定这个请求到底是一个客观知识检索,还是一个主观倾诉。模型没有查阅外部知识库来验证这句话是否具有专有名词属性。它也没有进行基础的实体识别。模型直接根据字面情感倾向走进了生成死胡同。模型在调用检索工具与直接生成文本之间的路由机制存在着严重的缺陷。
现有的评估体系往往侧重于衡量模型输出的事实准确率和幻觉比例。在这个案例中,模型输出的安慰语没有语法或逻辑错误。它在自己构建的语境里逻辑自洽。没有任何一个常规指标在衡量「你该不该开口」。当触发阈值设置得过低,模型就会在不需要它发声的地方强行插话。安静地提供客观事实是搜索工具的核心属性,喧宾夺主地输出主观臆断破坏了这一规则。
低配模型硬抗长尾请求
除了架构上的路由问题,另一个被社区广泛指出的硬伤在于模型能力的分层配置。有人指出,Google 在免费搜索服务中部署的 AI 摘要模型,其能力层级明显弱于前沿的旗舰大模型。在巨大算力成本压力的驱使下,处理海量免费搜索请求的模型,其幻觉率和逻辑推断能力与顶配版本存在量级上的差距。
如果一个模型做不到前沿水平,就不该把它生成的摘要强行置顶在所有搜索结果的最上方。为了追求 AI 渗透率和产品账面上的现代化,强行用低配模型去拦截数十亿用户的长尾查询,这在透支整个搜索产品的信任度。作者用「青蛙终于发现锅里的水早就开了」来形容这一刻。这种温水煮青蛙式的体验降级,正随着 AI 摘要的强制铺开悄然蔓延到每一个用户的日常操作中。
轻量级模型为了降低推理成本往往会被大幅度裁剪。它最先丧失的恰恰是处理长尾查询的能力。它只能依靠基础的概率分布来拼接词语,遇到不认识的短语就滑向通用的寒暄与套话。一个 2014 年的 76 人队冷知识,就这样被粗暴地转换成了一场虚构的失恋悲剧。技术端为了控制成本作出了妥协。这些妥协最终在产品端转化为无法解释的荒诞感。
找链接变成了找陪聊
Google 长期以来的公司使命,是组织并让全世界的资讯变得普世可及且有用。这个使命建立在一个不可动摇的前提之上:用户是来寻找资讯的,系统负责将资讯高效、准确地递交到用户手中。用户想要对话式陪伴时,可以打开专门的聊天界面进行漫谈。他现在使用的是搜索引擎,他需要的是链接。假装共情的数字陪聊在这里毫无意义。
AI 摘要这次犯的错,暴露出了产品的深层矛盾。生成式 AI 被强行嵌入了搜索的核心路径。模型的正确率、幻觉率都在衡量它「回答得好不好」,却没有任何机制去制约它「什么时候该闭嘴」。当搜索引擎决定扮演对话伙伴,用户丢掉的东西比排序质量更根本——他不仅找不准信息,找信息的动作本身也被一层厚厚的废话包裹了起来。如果系统分不清什么时候该回答问题,什么时候该默默递上网页,那再强大的语言模型,也不过是挡在信息与用户之间的一层障碍。
参考链接:
- Sancho Panza’s Thoughts 原文
- Hacker News 讨论