法律案卷逼出私有算力:单卡消费旗舰装不下MoE大模型
2026 年 11 月 20 日,美国律师 Nick Mermiges 展示了一套自建 AI 服务器。他采购 12 张二手英伟达 Tesla V100 显卡,总开销 9450 美元。折合人民币约 6.3 万元。系统负责运行 DeepSeek-V4.1-Flash 大模型。实测单流代码生成达每秒 184 个 token,表现强于商业级 DGX Spark 方案。
法律业务对数据隐私要求严格。诉讼案卷动辄数百页,且包含商业机密。把机密文本上传至公有云端 API,存在合规隐患。Nick Mermiges 需要在本地消化 128K 至 256K token 的上下文。模型参数一旦遭遇大幅度稀疏剪裁,分析推理的准确度就会下滑。
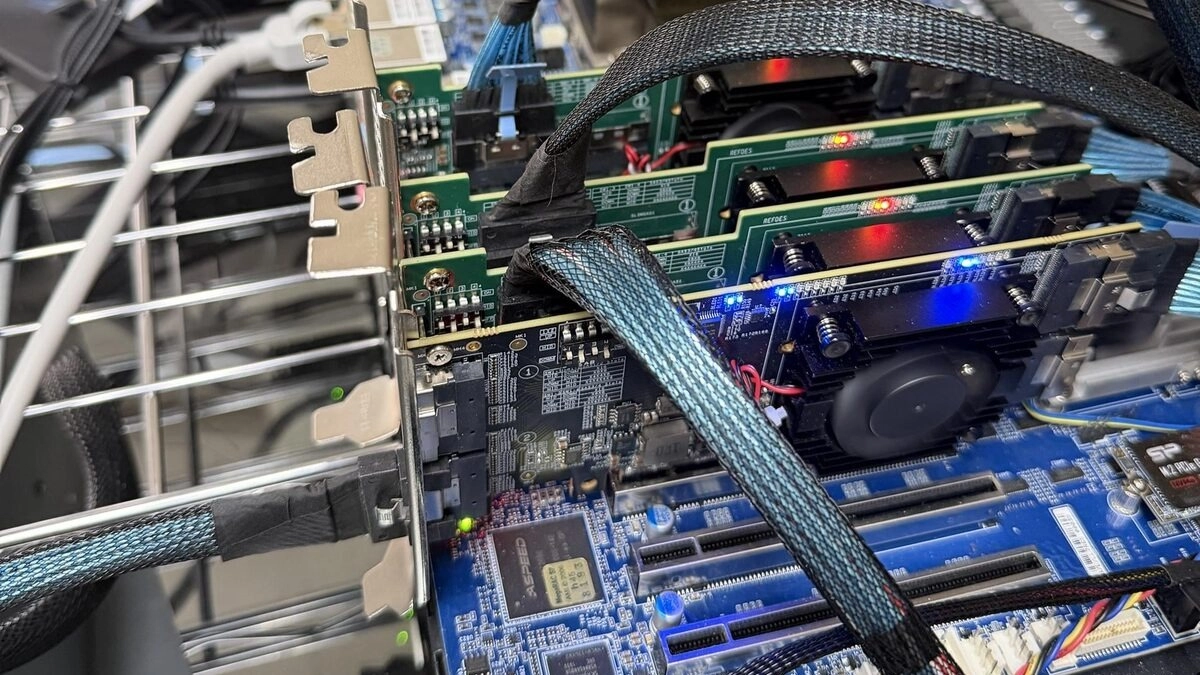 图:由三块背板共 12 张 Tesla V100 SXM2 显卡组成的开放式机架推理服务器实物。来源:Tom’s Hardware / Reddit。
消费级显卡在此类场景下遇到容量上限。市售消费旗舰单卡显存仅 24GB 至 32GB,单卡售价达 1600 至 2000 美元。DeepSeek 拥有 15360 个专家网络。在 4-bit 精度下,模型仍需占用 278.9 GiB 显存。若采用多张消费卡拼装,由于英伟达移除了硬件 NVLink,各卡只能通过 PCIe 插槽低速交换。总线瓶颈让长文本交互失去实用价值。
企业级旧卡提供了差异化的替代路径。二手 Tesla V100 SXM2 单卡配备 32GB HBM2 显存,双向 NVLink 具备 300GB/s 互联带宽。单卡二手价格已跌至数百美元。12 张旧卡组装后提供 384GB 显存池。庞大的模型得以常驻显存,解除了本地运行的容量限制。
软件解包NVFP4:老旧HBM2跑通Blackwell时代权重
这套硬件面临微架构的技术代差。NVFP4 是随 Blackwell 架构推出的 4-bit 浮点格式。而 Tesla V100 产自 2017 年的 Volta 时代。V100 核心并未集成针对 FP4 或 FP8 的硬件计算单元。
计算代差被软件内核拉平。Nick Mermiges 编写了解包逻辑,数据进入运算核心前由 CUDA 核心实时解包成半精度。大语言模型生成属于显存带宽受限任务。瓶颈在于显存向核心传输权重的吞吐量,运算核心本身并未跑满。
**权重压缩的目标是减少总线传输的数据量。**NVFP4 让权重体积缩小四分之三。12 张 V100 具备单卡 900GB/s 的显存带宽,较低的字节读取负荷即可喂饱管线。老芯片借此跨过了代际门槛。
充足的显存也保全了模型精度。早期 8 卡系统仅有 254 GiB 显存,大部分专家只能退回 2-bit,仅 38.7% 专家保留 NVFP4。扩容至 12 卡后,全部 15360 个专家均以 NVFP4 载入。数值与官方版本一致。模型的长程语义理解能力得以保持完整。
板内NVLink加板间PCIe:三级流水线拆解40层网络
集群采用了混合并行拓扑。系统划分为 3 个流水线阶段,每个阶段内包含 4 张显卡做张量并行。DeepSeek 的 40 个网络层依次切分。首块背板承担 0 至 13 层,次块背板承载 14 至 27 层,末块背板处理 28 至 39 层。
这种布局兼顾了不同总线的传输特性。背板内部的 4 张显卡通过 NVLink 实现全互联。**张量并行中频繁的高吞吐同步局限在板内完成。**通信不会挤占外置通道。
板间的数据传递由 PCIe 交换芯片接管。前两块背板共用 Broadcom PEX88096 交换芯片,传输在交换网络内完成。第三块背板挂载在 PLX 8749 芯片后方,需要走主机总线桥接。端到端虽增加额外等待,但流水线分段交叠执行淡化了通信惩罚。
整机供电需要精细微调。Nick Mermiges 将单卡功率上限调至 175W,核心频率限制在 1452MHz。这种主动降频压制了功耗尖峰。早前测试推至 200W 时,四路长文本并发曾引发电源保护关机。调低频率换来了整机持续稳定的电气工况。
长文本首字缩短一半:旧卡吞吐反超DGX旗舰集群
跑分数据体现了架构组合的成效。处理代码任务时,1K 上下文生成速度达每秒 184 个 token。256K 上下文仍有每秒 153 个 token。法律与普通文本生成分别落在每秒 92 与 85 个 token 左右。
 图:自建 12 卡 V100 集群与 DGX Spark 在不同上下文长度下的推理速度与首字延迟实测对比。来源:Tom’s Hardware / Reddit。
性能超越了商业级新卡集群。**在单流推理测试中,12 卡 V100 领先四卡堆叠的 DGX Spark 约 15% 至 45%。**针对 256K 极长上下文,冷启动的首字等待从先前 8 卡方案的 108.4 秒降至 58.0 秒。响应耗时缩减近半。
长提示词的读取能力得到大幅提升。上下文超出 32K 后,预填充速度维持在每秒 4500 至 4700 个 token。相较初始方案翻倍。在文本完成缓存后,首字延迟压缩至 0.2 至 0.6 秒区间。长篇案卷能迅速获得响应。
并发测试界定了架构边界。在 3 路并发处理 128K 代码时,集群总吞吐为每秒 360 个 token。不过流水线结构缺乏弹性批处理支持,多路请求超出阶段数后吞吐难以成倍增长。系统专注服务单人独占的高吞吐交互。
2100瓦功耗换隐私:二手工业算力重构本地部署边界
极客方案伴随着高昂的运行门槛。整套平台满载功耗达到 2100W。伴随而来的是暴力工业风扇的刺耳噪音。这类机架设备无法摆放在日常桌面,必须依靠独立供电与散热的隔音空间安放。
系统的调试维护同样繁复。Nick Mermiges 尝试过会话持久化存储与精简阶段传输等四项优化,但均因收益未达标或出现兼容问题而回滚。自建集群要求使用者承担系统工程的排障职责。
对于专业领域的重度用户,二手企业级硬件展现了突出的替代价值。个人部署无需局限在昂贵且缺乏互联的消费显卡上。通过搜罗折旧企业级加速卡,配合适配量化与分层组网,万元预算足以搭建出满足深度分析的本地推理节点。
老旧硬件与开源生态的联动改变了算力供给模式。**大模型本地化不必紧跟旗舰硬件的换代节奏。**精准匹配显存带宽与互联拓扑,数年前的旧时代计算卡依然能支撑起独立私有的 AI 阵地。
参考链接:
- Tom’s Hardware 报道 (Lawyer’s $9,450 private AI server with 12 used Nvidia V100s runs DeepSeek V4.1 Flash)
- Reddit 硬件社区讨论 (Lawyer with too many GPUs: DeepSeek-V4.1-Flash on 12x V100)