2026 年 10 月 1 日,Cloudflare 正式发布了两款开源多模态决策模型 Clef 与 Clef-flash。它们没有选用 Llama 或 Mistral 作为底座,而是直接基于阿里通义的 Qwen3.8-27B 和 Qwen3.5-9B 进行联合训练优化。一个主打边缘计算和 CDN 的云厂商,亲自下场训练决策分类器。
过去企业习惯把业务判断全抛给云端大模型。每次内容审核或恶意流量清洗,都伴随着昂贵的首包延时。让千亿参数模型做二选一分类,在成本结构上是一种浪费。Cloudflare 的解法是直接给边缘侧配上专属的决策引擎。
视觉编码器打通读图判别
在 Clef 登场前,TypeSafe 发布的 Jev 是开源决策模型的性能标尺。Jev 仅支持纯文本分类,上下文窗口死死卡在 32k。面对带截图的审核请求,系统必须外挂 OCR 组件。视觉信息被强行转译成文本后,才能喂给模型做判断。
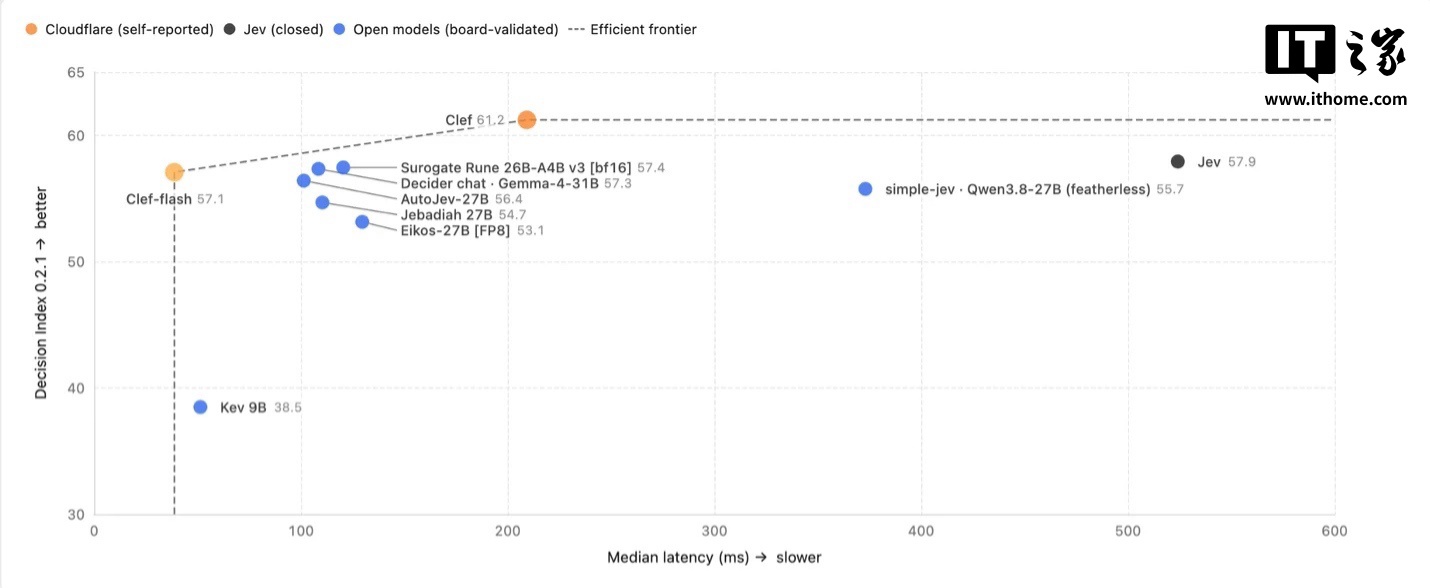 图:Clef 模型的执行逻辑示意。来源:Cloudflare Blog
Clef 原生自带了视觉编码器,输入上限被推至 64k。模型直接具备解析图像输入的能力,省去了中间的文本转换损耗。开发者现在能把更密集的系统状态数据塞进 64k 窗口内。看图做决定的链路在端侧被物理打通,视觉理解不再是通用大模型的专权。
封死生成能力换取校准精度
为了把 Qwen 调教成高频分类器,Cloudflare 的开发团队做出了严格的架构取舍。他们冻结了 Qwen3.8-27B 与 Qwen3.5-9B 的核心层,仅加入 rank-256 的低秩适配器(LoRA)进行微调。团队动用 Brier loss 细化概率校准,配合标签平滑的交叉熵损失,锁死了 Clef 的文本生成功能。
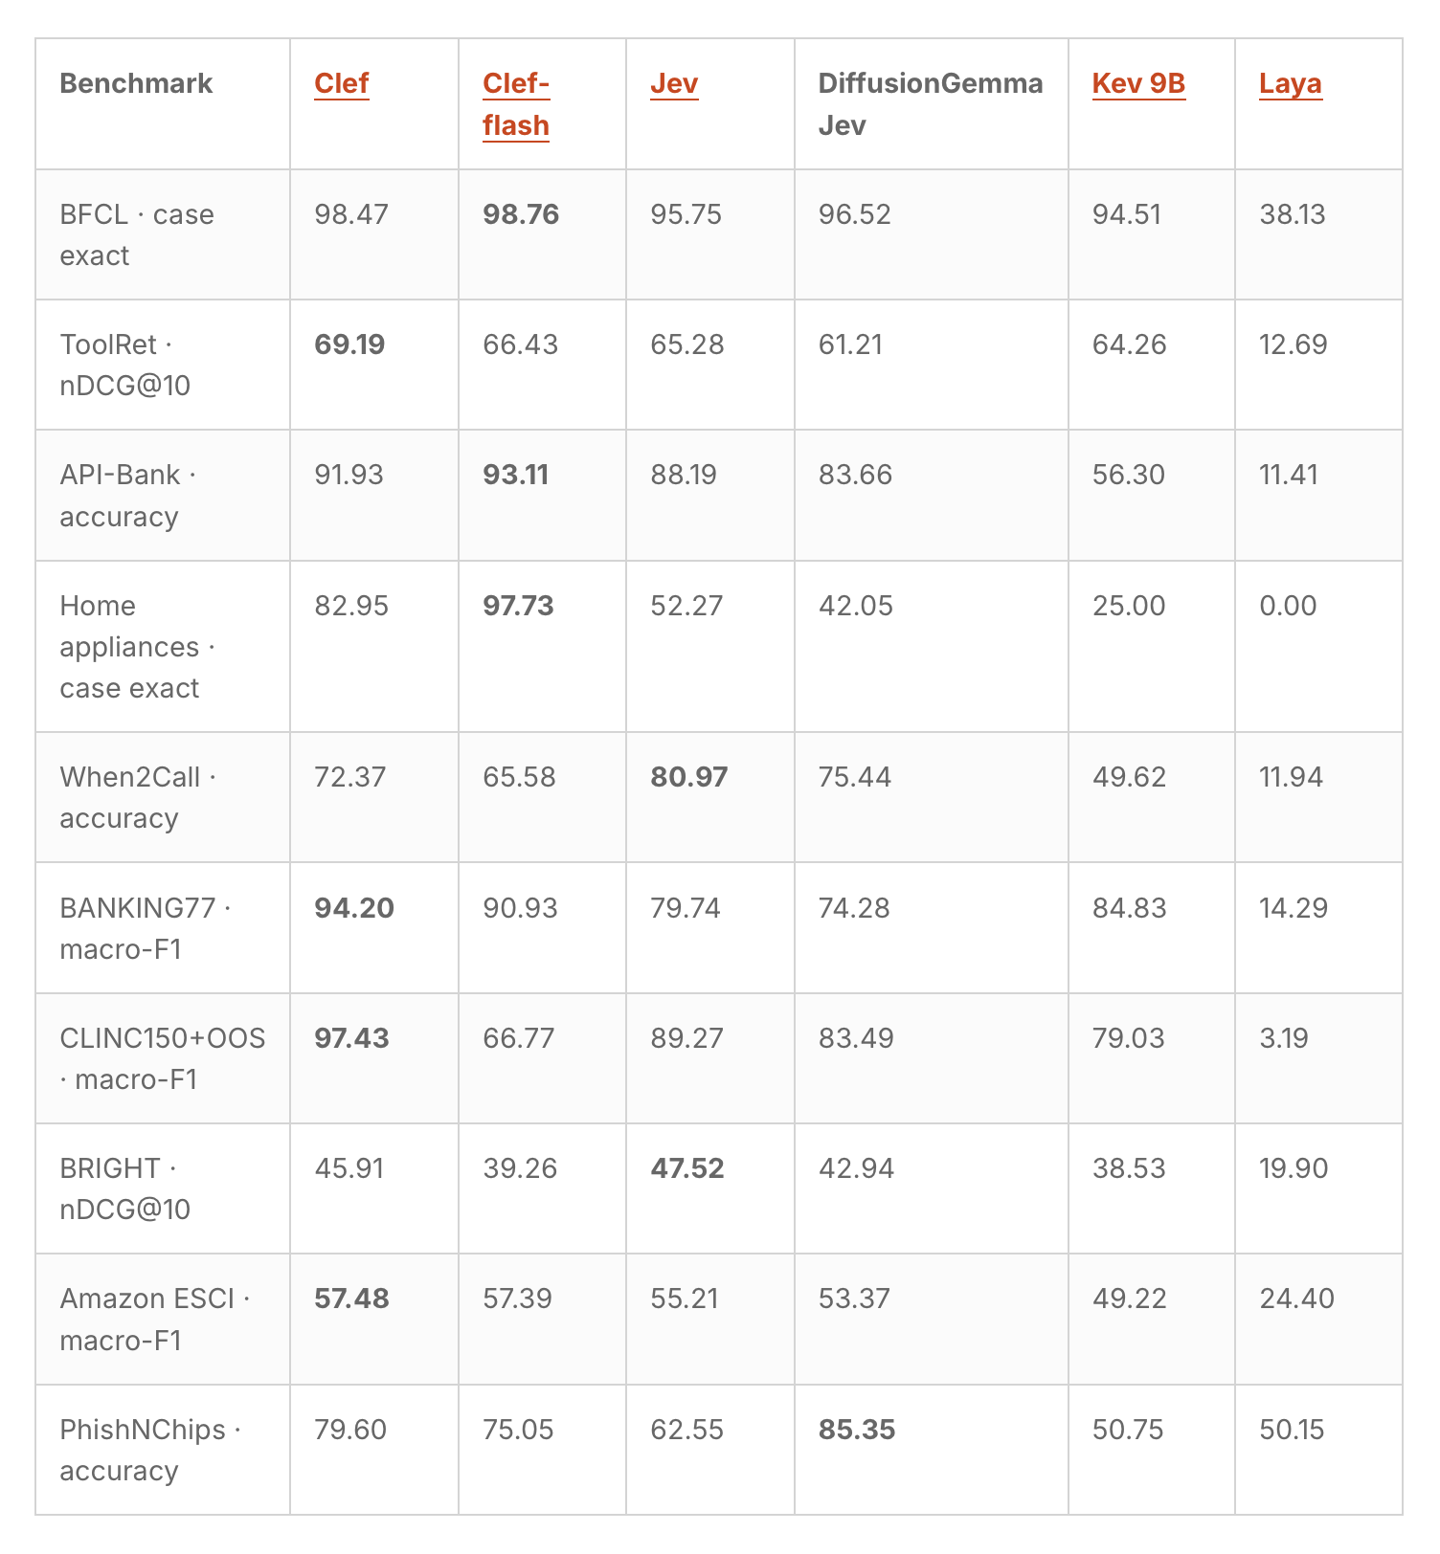 图:Clef 在各项基准测试中对比 Jev 与 Kev 等同类模型的数据。来源:Cloudflare Blog
模型运行期间不再输出解释性的文本内容。它被强制要求给出特定 Schema 下的精确概率分布。这种对输出格式的物理约束,换来了决策准确率的飙升。
在 Jev 决策指数(Decision Index 0.2.1)的基准评测中,Clef 拿到 98.47 分,Clef-flash 达到 98.76 分。这两项成绩均压过了 Jev 的 95.75 分,把 Kev 9B 远远甩在身后。算力被全部逼入分类校验的单一任务里。抛弃闲聊换取毫秒级响应,正中高频业务的工程靶心。
合成数据验证鲁棒性底线
支撑这套高精度输出机制的,是 Cloudflare 内部投喂的合成数据集。训练期间,开发团队刻意扰乱了字段顺序、系统提示词以及 Schema 结构。这一操作强化了模型应对复杂边缘请求时的鲁棒性。
开发团队还引入了 RLCD(校准决策强化学习)作为次要优化目标。它会给相近的有序选择分配部分分数,并奖励精确的格式化输出。同时,机制中施加参考惩罚(reference penalty)以防止分布偏移。用强化学习修正决策偏差的做法,让 Clef 有了直接承接企业级工单分类任务的底气。
搭售微调工作流拦截边缘流量
放出开源权重只是抛砖引玉,Cloudflare 真正的目的在于同步上线的微调服务。企业客户可直接通过 Cloudflare AI Gateway 收集业务流量。这些真实数据随后被放入 Containers 沙箱,用于给 Clef 做定制化训练。模型调优完毕后,直接借由 BYO Model 服务部署到 Workers AI 网络上。
内部团队早就跑通了这套流程。安全团队用它评估 Trust & Safety 提交记录。支持部门靠它自动分发后台工单。爬虫对抗部门则用它甄别瞬息万变的网络请求。
把微调环境、数据获取和推理解析全圈在自家院墙内,云厂商完成了一次完整的流量截留。企业不再需要将边缘数据发给远端的第三方 API。
Cloudflare 选择 Qwen 证实了开源生态的底座实力,Clef 本身则指向了模型微缩的必然工程演进。当 27B 和 9B 的模型被剥夺了生成文字的能力、装上眼睛,并牢牢绑定在云端微调工作流上时,通用大模型的红利正在被垂直分类器分食。开发者无需再为多余的推理过程买单。算力最终只会为那一个决策概率计费。
参考链接:
- Cloudflare Blog
- HuggingFace 模型主页