Am 1. Oktober 2026 veröffentlichte Cloudflare zwei quelloffene, multimodale Entscheidungsmodelle unter dem Namen Clef und Clef-flash. Anstatt auf Llama oder Mistral als Basis zurückzugreifen, setzt das Unternehmen direkt auf Alibabas Qwen3.8-27B und Qwen3.5-9B, die gemeinsam weitertrainiert und optimiert wurden. Damit trainiert ein Cloud- und CDN-Anbieter, dessen Kernkompetenz im Edge Computing liegt, nun eigenständig spezialisierte Entscheidungs-Klassifikatoren.
Bislang überließen Unternehmen betriebliche Klassifikations- und Routingentscheidungen weitgehend riesigen Cloud-LLMs. Bei jeder Inhaltsmoderation oder Filterung von bösartigem Datenverkehr fielen jedoch beträchtliche Latenzen bis zum ersten Token an. Ein Modell mit Hunderten Milliarden Parametern für reine binäre Entscheidungen einzuspannen, ist aus wirtschaftlicher Sicht eine Fehlallokation von Rechenleistung. Cloudflares Gegenentwurf: eine dedizierte Entscheidungs-Engine direkt am Netzwerkrand (Edge).
Integrierter Vision-Encoder: Bildverarbeitung trifft auf direkte Entscheidungsfindung
Vor dem Erscheinen von Clef galt das von Typesafe AI vorgestellte Jev als maßgeblicher Leistungsmaßstab für quelloffene Entscheidungsmodelle. Jev beschränkte sich jedoch rein auf Textklassifikation bei einem starren Kontextfenster von 32k Tokens. Sobald Screenshots oder Belege geprüft werden mussten, waren Entwickler auf externe OCR-Komponenten angewiesen. Visuelle Daten mussten mühsam in Text transkribiert werden, bevor das Modell ein Urteil fällen konnte.
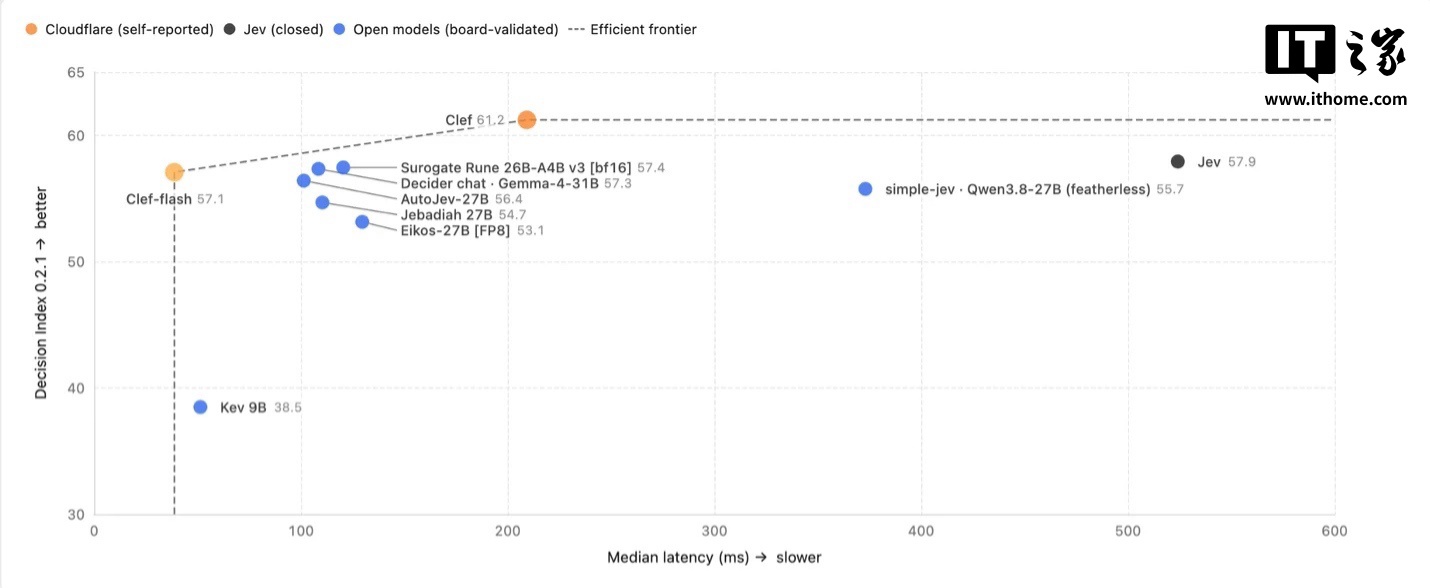 Abbildung: Ausführungslogik des Clef-Modells. Quelle: Cloudflare Blog
Clef hingegen verfügt von Haus aus über einen integrierten Vision-Encoder und erweitert die Eingabekapazität auf 64k Tokens. Das Modell kann Bildinhalte unmittelbar nativ verarbeiten, wodurch Übertragungsverluste und Latenzen der Textkonvertierung entfallen. Entwickler können nun deutlich dichtere Systemzustände und Diagnosedaten in das 64k-Fenster einspeisen. Die Pipeline für visuell fundierte Entscheidungen wird direkt am Endpunkt geschlossen – Bildverständnis bleibt damit nicht länger das Monopol monolithischer Cloud-Modelle.
Textgenerierung gekappt: Maximale Präzision durch Wahrscheinlichkeitskalibrierung
Um Qwen zu einem hochfrequenten Klassifikator umzufunktionieren, traf das Entwicklerteam von Cloudflare radikale architektonische Entscheidungen. Die Kernschichten von Qwen3.8-27B und Qwen3.5-9B wurden eingefroren; das Feintuning erfolgte ausschließlich über Low-Rank-Adapter (LoRA) mit Rang 256. Durch die Kombination von Brier-Loss zur feingliedrigen Kalibrierung von Wahrscheinlichkeiten und kreuzentropischem Verlust mit Label-Smoothing wurde die freie Textgenerierung von Clef vollständig unterbunden.
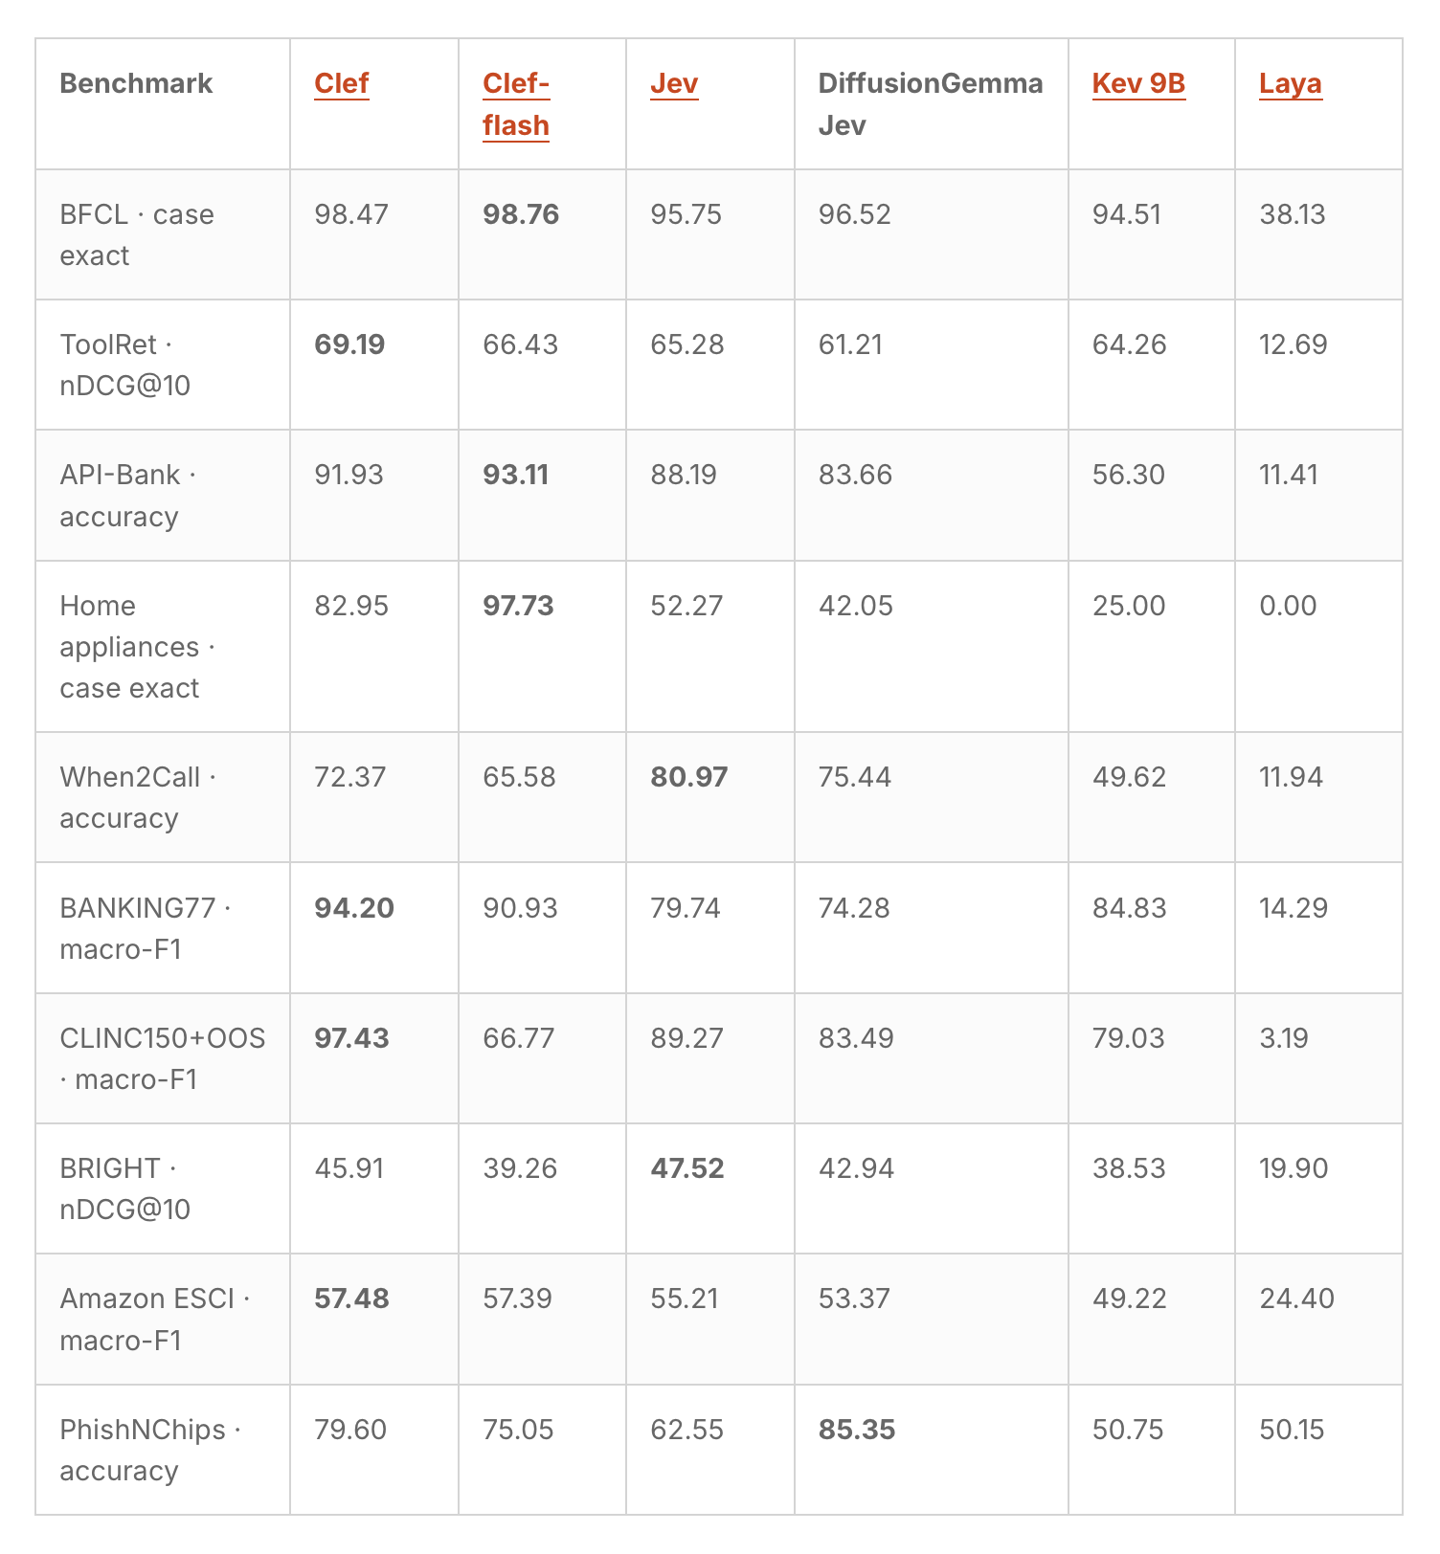 Abbildung: Benchmark-Ergebnisse von Clef im Vergleich zu Modellen wie Jev und Kev. Quelle: Cloudflare Blog
Im laufenden Betrieb erzeugt das Modell keinerlei erklärende Prosa oder Chat-Texte. Es ist strikt darauf ausgelegt, präzise kalibrierte Wahrscheinlichkeitsverteilungen für ein vordefiniertes Schema auszugeben. Diese physische Restriktion des Ausgabeformats führte zu einem drastischen Sprung bei der Entscheidungsgenauigkeit.
Im Jev Decision Index (Version 0.2.1) erzielte Clef 98,47 Punkte und Clef-flash 98,76 Punkte. Beide Werte übertrafen die 95,75 Punkte von Jev deutlich und distanzierten Kev 9B mit großem Abstand. Die gesamte Rechenleistung fließt ungeteilt in die Validierung und Klassifikation. Der Verzicht auf Konversation zugunsten von Antwortzeiten im Millisekundenbereich trifft die ingenieurtechnischen Kernanforderungen hochfrequenter Produktionssysteme exakt.
Synthetische Daten als Härtetest für robuste Edge-Einsätze
Das Fundament dieser hochpräzisen Ausgabe bildet ein intern generierter synthetischer Datensatz. Während des Trainings variierte das Team gezielt Feldreihenfolgen, System-Prompts und Schemastrukturen. Dieser Stresstest stärkte die Robustheit des Modells gegenüber unvorhersehbaren und verrauschten Anfragen am Netzwerkrand nachhaltig.
Zusätzlich implementierte das Team RLCD (Reinforcement Learning from Categorical Distributions) als sekundäres Optimierungsziel. Dieses belohnt nah beieinanderliegende geordnete Antwortoptionen mit Teilpunkten und honoriert exakte Schema-Formate. Gleichzeitig verhindert eine Referenz-Penalty das Abdriften der Verteilung. Durch diese systematische Korrektur von Entscheidungsverzerrungen mittels Bestärkendem Lernen meistert Clef anspruchsvolle Aufgaben wie die automatisierte Ticket-Triage im Unternehmensumfeld souverän.
Maßgeschneiderte Fine-Tuning-Workflows binden Edge-Traffic
Die Bereitstellung offener Gewichte ist nur der erste Schritt. Das eigentliche strategische Ziel von Cloudflare liegt im zeitgleich vorgestellten Fine-Tuning-Dienst. Unternehmenskunden können ihren realen Produktiv-Traffic direkt über das Cloudflare AI Gateway erfassen. Diese Betriebsdaten werden anschließend in isolierten Container-Umgebungen genutzt, um Clef passgenau auf eigene Use Cases nachzutrainieren. Nach Abschluss der Optimierung lässt sich das Modell über den Dienst „Bring Your Own (BYO) Model“ nahtlos im weltweiten Workers-AI-Netzwerk ausrollen.
Interne Teams nutzen diesen Ablauf bereits im Regelbetrieb: Das Trust-&-Safety-Team bewertet damit gemeldete Verstöße, der Kundensupport steuert die automatisierte Zuweisung von Support-Tickets, und die Bot-Abwehr klassifiziert hochdynamische Netzwerkabfragen in Echtzeit.
Indem Fine-Tuning, Datenerfassung und Inferenz innerhalb der eigenen Infrastruktur gebündelt werden, gelingt dem Cloud-Anbieter eine vollständige Bindung des Datenverkehrs. Unternehmen müssen sensible Edge-Daten nicht mehr an externe Drittanbieter-APIs weiterleiten.
Cloudflares Wahl von Qwen unterstreicht die Reife und Leistungsfähigkeit moderner Open-Source-Ökosysteme. Clef selbst markiert einen logischen Schritt in der Evolution der KI: die gezielte Spezialisierung kompakter Modelle. Wenn 27B- und 9B-Modelle auf Textgenerierung verzichten, stattdessen Sehen lernen und direkt an Edge-Workflows gekoppelt werden, erobern vertikale Klassifikatoren das Terrain allgemeiner LLMs. Entwickler zahlen nicht mehr für überflüssige Inferenz-Schritte – abgerechnet wird letztlich nur noch für die reine Entscheidungswahrscheinlichkeit.
Referenz-Links:
- Cloudflare Blog
- Hugging Face Modell-Hub