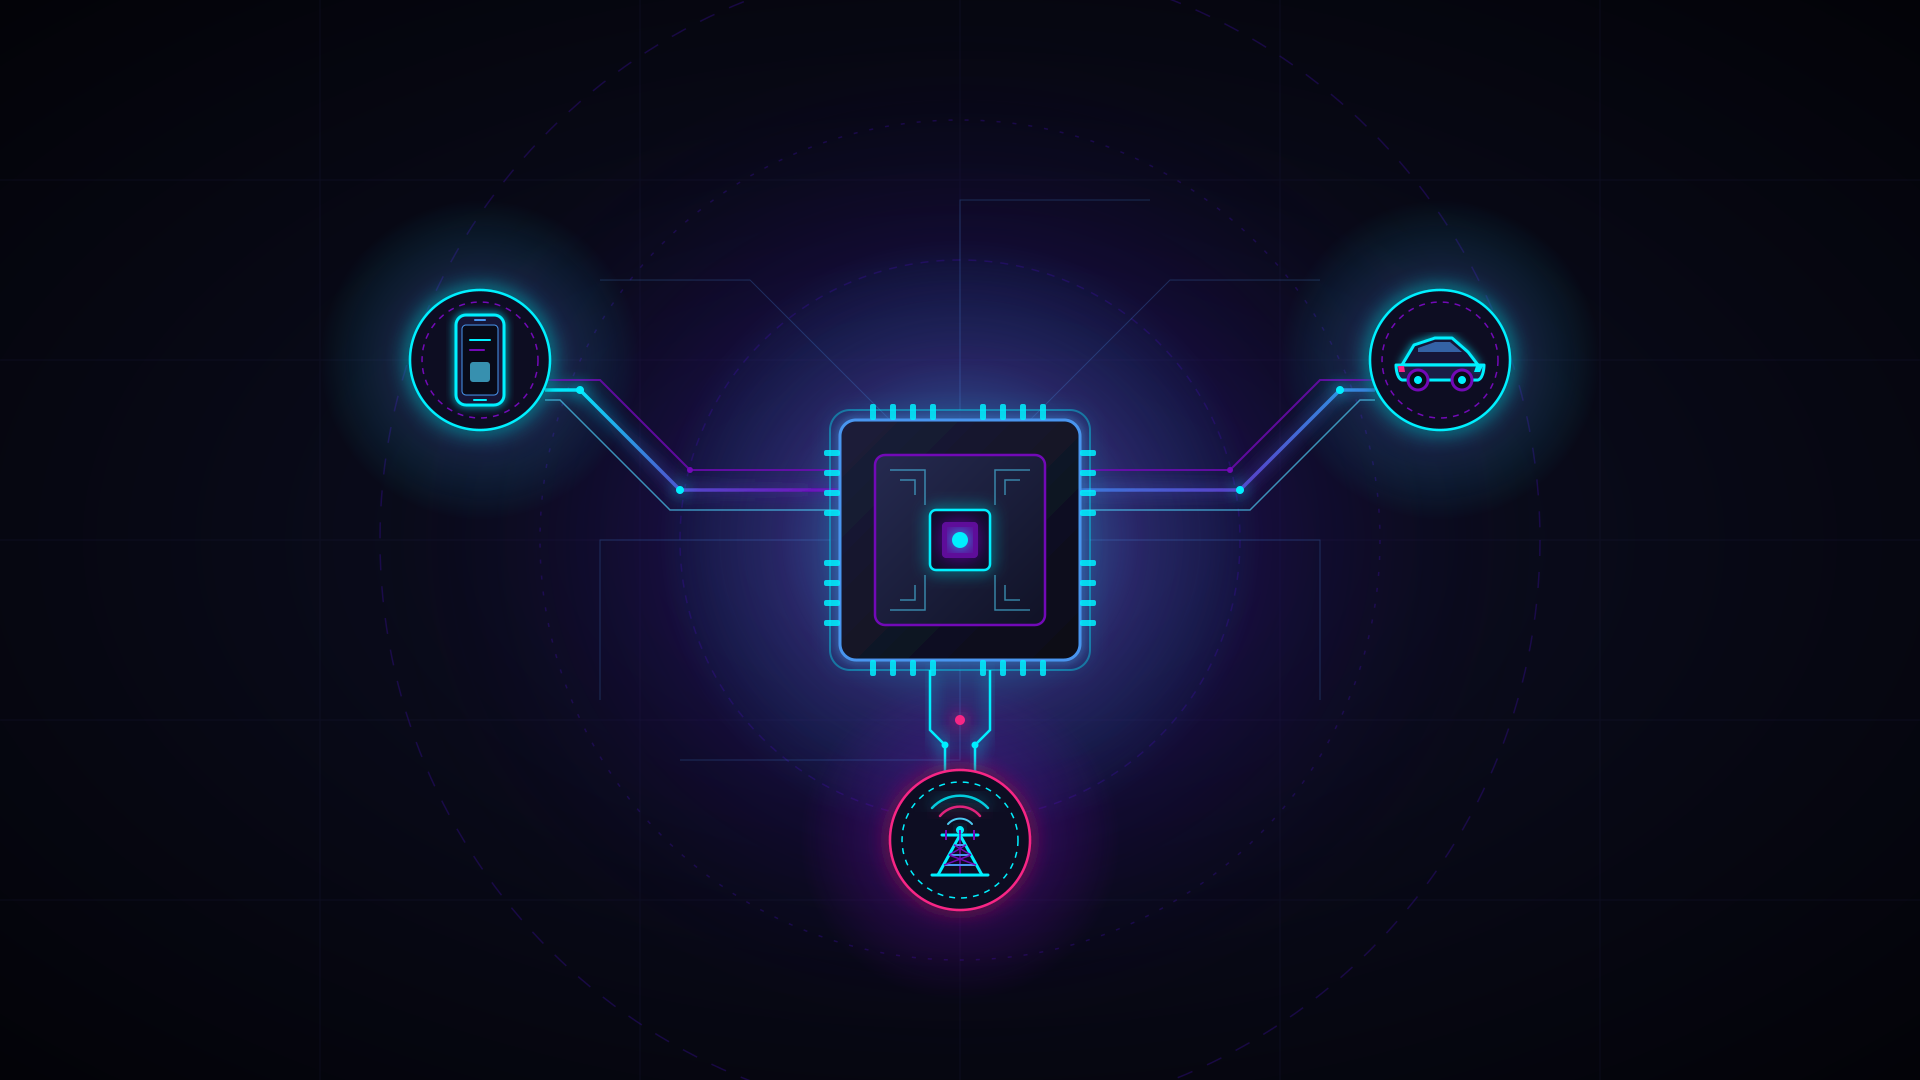
Am 4. Oktober 2026 bestätigte Richard Yu, Executive Director von Huawei, in einer Videobotschaft, dass das Unternehmen 381 Varianten von Halbleiter-Tau-Chips ($\tau$) für Smartphones, künstliche Intelligenz (KI), Netzwerkinfrastruktur und intelligente Fahrzeuge erfolgreich entwickelt und in die Massenproduktion überführt hat. In einer Zeit, in der die physikalische Skalierung siliziumbasierter Halbleiterprozesse auf massive Hürden stößt, setzt das Unternehmen auf ein grundlegend verändertes Ingenieursparadigma, um die Wirksamkeit des Mooreschen Gesetzes aufrechtzuerhalten.
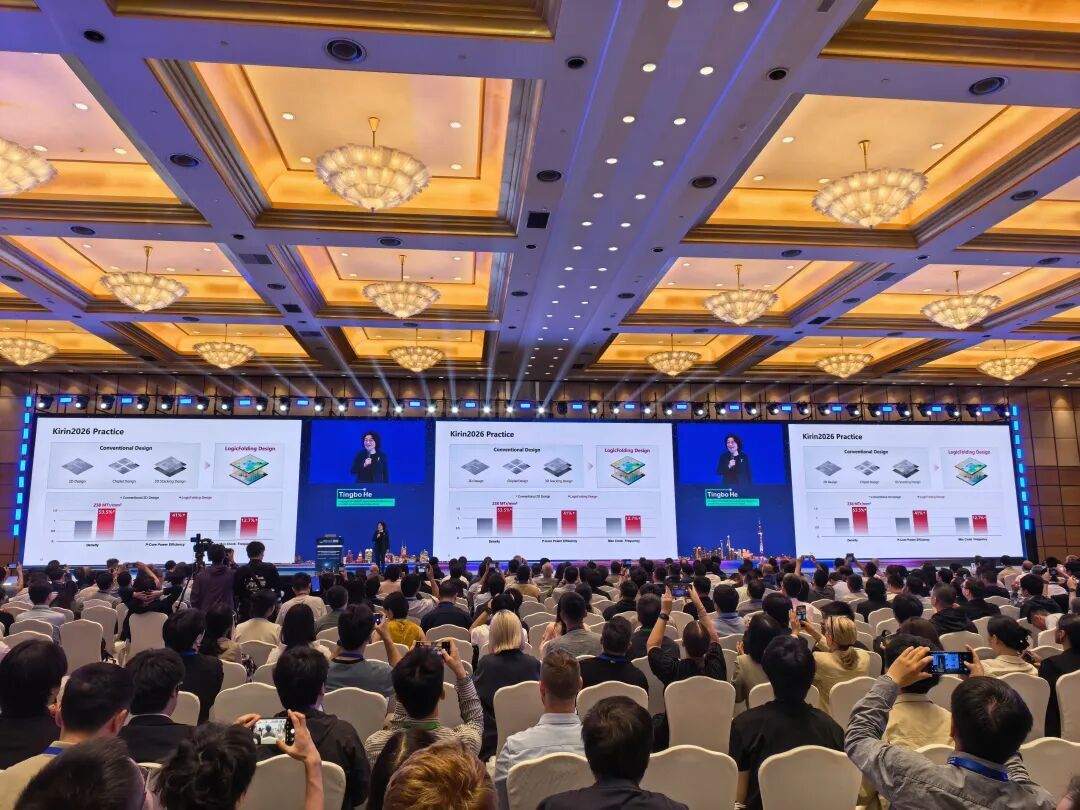 Abbildung: Architekturschema der Huawei-Tau-Chips. Quelle: Offizielle Präsentationsfolien von Huawei
Transistoren stoßen an physikalische Grenzen: Leistungssprung durch die Zeitdimension
Der traditionelle Pfad der Halbleiterindustrie basierte über Jahrzehnte hinweg auf der kontinuierlichen Schrumpfung der physikalischen Abmessungen einzelner Transistoren – der sogenannten geometrischen Verkleinerung (Geometric Scaling). Ingenieure trieben Lithografiesysteme immer weiter voran, um auf derselben Siliziumfläche immer dichtere Schaltkreise zu belichten. Doch beim Vordringen in den Bereich weniger Nanometer bis hin zu Angström-Dimensionen verändern sich die physikalischen Spielregeln dramatisch: Quantentunneleffekte und leckstrombedingte Wärmestauungen bilden kaum überwindbare Barrieren. Zugleich explodieren die Anschaffungs- und Betriebskosten für modernste EUV-Belichtungsanlagen (Extreme Ultraviolet), während der Grenznutzen pro Siliziumwafer drastisch abflacht.
Angesichts dieser Sackgasse formulierte Teresa He (He Tingbo), Präsidentin von Huaweis Halbleitersparte HiSilicon, das sogenannte „Tau-Gesetz“ ($\tau$). Die zugrunde liegende Strategie ist pragmatisch: Wenn die Kosten für das Auspressen von noch mehr physischem Raum auf dem Silizium unerschwinglich werden, müssen Entwickler ihren Fokus auf die Kompression der Ausführungszeit verlagern. In realen Rechenumgebungen ist selten die theoretische Spitzenleistung der Engpass. Vielmehr verbraucht das Hin- und Herschaufeln von Daten zwischen Arbeitsspeicher, mehrstufigen Cache-Hierarchien und Recheneinheiten den Großteil der Systemtaktzyklen. Leerlaufphasen, in denen Rechenkerne auf Daten warten, verschwenden wertvolle Ressourcen. Durch das Beseitigen redundanter physischer Datentransferpfade und die dauerhafte Vollauslastung der Recheneinheiten erschließt diese zeitbasierte Architekturoptimierung beträchtliche Leistungsreserven.
Logic-Folding-Technologie sprengt die Grenzen planarer Chip-Layouts
Von den grundlegenden physikalischen Bauelementen bis hin zur Systemarchitektur wurden die Tau-Chips einem umfassenden Bottom-up-Redesign unterzogen. Auf Bauteilebene verzichtete das Entwicklungsteam auf eine blinde Jagd nach immer schmaleren Strukturbreiten. Stattdessen optimierten sie die dreidimensionale physikalische Struktur der Transistoren, um Verbindungswiderstände ($R$) und parasitäre Kapazitäten ($C$) präzise zu kontrollieren. Dadurch wurde die bauteilspezifische Zeitkonstante $\tau$ auf ein Minimum reduziert, was das Fundament für wesentlich aggressivere Schaltungsdesigns legte.
Der entscheidende technologische Durchbruch vollzieht sich auf der Schaltungsebene. Klassisches Chipdesign ist stark von zweidimensionalen planaren Layouts abhängig. Bedingt durch die Grenzen der 2D-Fläche müssen zwischen komplexen Logikblöcken lange Signalbahnen verlegt werden, was unweigerlich zu Signallaufzeiten und parasitärem Energieverbrauch führt. Huawei führt in dieser Produktgeneration die sogenannte „Logic-Folding“-Technologie (dreidimensionales Logikfalten) ein. Durch die Neuordnung der Leitungsführung kritischer Pfade entsteht ein räumliches 3D-Signalübertragungsnetzwerk, das den RC-Widerstand und die kapazitiven Lasten entlang der Signalwege massiv verringert. Durch den Übergang von flächiger Ausbreitung zu räumlich gefalteten Schaltungsstrukturen steigen sowohl die effektive Transistordichte pro Flächeneinheit als auch die Signalübertragungseffizienz sprunghaft an.
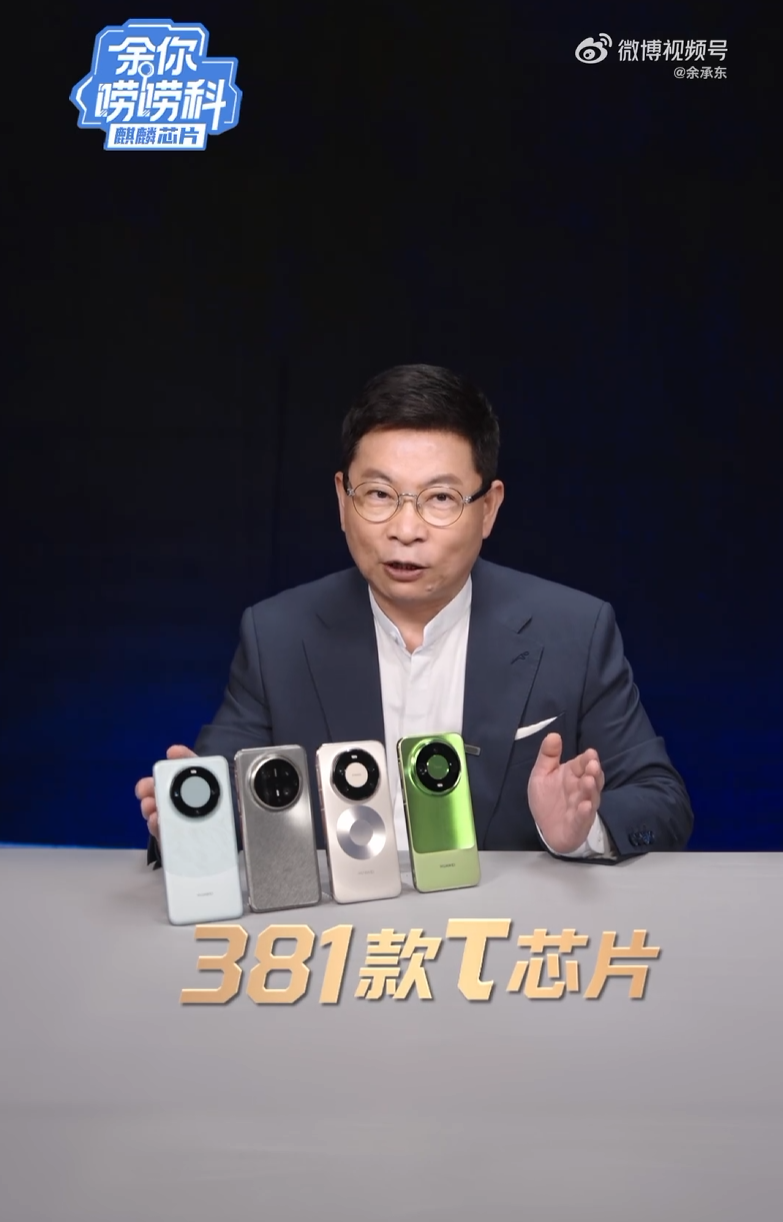 Abbildung: Erwartete Roadmap und Technologieentwicklung der Tau-Chips. Quelle: Screenshot der Huawei-Präsentation
Full-Stack-Kooperation verkürzt Ende-zu-Ende-Befehlslaufzeiten
Physikalische Innovationen auf Hardwareebene entfalten ihr volles Potenzial erst im Zusammenspiel mit maßgeschneiderter Software. Auf Chipebene setzt die Tau-Architektur auf eine durchgängige Full-Stack-Kooptimierung von Software, Hardware und Silizium. In traditionellen Rechnerarchitekturen verläuft die Befehlsverarbeitung weitgehend starr und passiv. Unter der Tau-Architektur hingegen werden Befehls- und Datenströme in Echtzeit dynamisch an die tatsächliche Arbeitslast der Endgeräte angepasst.
Dank dieser feingranularen Steuerung lassen sich begrenzte Rechenressourcen wesentlich intelligenter zuteilen. Bei stark parallelen Aufgaben steigern tiefgreifendes Befehls-Prefetching und präzise Sprungvorhersagen die Gesamteffizienz der Parallelverarbeitung. Taktzyklen werden nahtlos getaktet, wodurch sich die gesamte Ende-zu-Ende-Laufzeit von Aufgaben drastisch verkürzt. Komplexe Rechenoperationen, die zuvor mehrere Zyklen benötigten, liefern ihre Ergebnisse nun in wesentlich kürzerer Zeitspanne.
Lingqu-Bus restrukturiert Speichersemantik bei der Superknoten-Kopplung
Selbst die höchste Rechenleistung eines einzelnen Halbleiterdies stößt an Grenzen, sobald Systeme zu riesigen Clustern skaliert werden – hier wird die Interconnect-Kommunikation zum primären Flaschenhals. Das Training moderner KI-Basismodelle sowie anspruchsvolle Cloud-Inferenz erfordern das reibungslose Zusammenspiel von hunderten oder gar tausenden Beschleunigerkarten. Um Kommunikationsbarrieren zwischen verteilten Knoten aufzuheben, hat Huawei auf Systemebene den proprietären Lingqu-Bus implementiert.
Der Lingqu-Bus definiert die grundlegenden Verbindungsprotokolle von Hochleistungsrechnern neu. Er unterstützt ein einheitliches Adressierungsmodell für den Speicher über extrem große Superknoten hinweg, wodurch der Datenaustausch zwischen physischen Knoten die Bandbreitengrenzen klassischer I/O-Busse durchbricht. Dank nativer Speichersemantik fühlt sich der Datenzugriff über das Netzwerk so direkt an wie das Auslesen des lokalen Arbeitsspeichers. Dies senkt die systemweiten Kommunikationslatenzen drastisch, verschmilzt lose gekoppelte Rechenknoten zu einem dichten Supercomputing-Netzwerk und minimiert rechenzeitraubende Kommunikationsverluste.
Zielmarke 2031: Äquivalente Integrationsdichte eines 1,4-Nanometer-Prozesses
Die anhaltende Nervosität der Halbleiterindustrie hinsichtlich immer kleinerer Fertigungsprozesse rührt zu großen Teilen aus einer Pfadabhängigkeit von physischen Integrationsdichten. Huaweis Ingenieuransatz eröffnet hierzu eine greifbare Alternative. Offizielle Pläne zeigen: Durch kontinuierliche Weiterentwicklung entlang der Roadmap des Tau-Gesetzes sollen High-End-Prozessoren auf Basis dieser Architektur bis 2031 eine äquivalente Transistordichte erreichen, die theoretisch herkömmlichen 1,4-Nanometer-Fertigungsverfahren entspricht – bei gleichzeitig synchron steigender Gesamtleistung.
Der Wettbewerb im Bereich des siliziumbasierten Rechnens hat eine neue Dimension erreicht. Unter den externen Restriktionen, die den direkten Zugriff auf modernste EUV-Lithografiesysteme verwehren, erweist sich die systemische Neugestaltung über Zeitkonstanten als die belastbarste technologische Lösung für die heimische Halbleiterlieferkette, um den Generationenabstand zur Weltspitze zu schließen. Es ist ein technologischer Kurs, der konsequent auf architektonische Effizienz setzt.
381 Chip-Varianten formen ein autonomes plattformübergreifendes Rechenfundament
Die 381 im Rahmen der Ankündigung bestätigten Tau-Chips sind kein isoliertes Einzelexperiment. Ihr Einsatzspektrum reicht von Flaggschiff-SoCs für Smartphones über Rechenplattformen für das autonome Fahren bis hin zu gigantischen KI-Rechenzentren in der Cloud. Es handelt sich um eine ganzheitliche Neugestaltung auf Halbleiterebene, die von den physikalischen Basiselementen ausgeht und das gesamte Anwendungsumfeld durchdringt.
Ein Architekturwechsel dieser Größenordnung belegt, dass Huawei ein vollständiges, souveränes Rechenfundament für alle Einsatzszenarien etabliert hat. Ob anspruchsvolle Niedriglatenzanforderungen im Automobilbereich oder strikte Energieeffizienzvorgaben in Mobilgeräten: Beide Welten erfordern eine eigenständige Hardwarebasis. Abseits des reinen Wettlaufs um kleinere Fertigungsstrukturen verändert der evolutionäre Pfad der zeitbasierten Skalierung die Spielregeln im globalen Wettbewerb um Rechenleistung nachhaltig.
Weiterführende Links:
- Videobotschaft von Huawei-Vorstand Richard Yu zum aktuellen Fortschritt der Halbleitersparte
- Keynote-Vortrag von Huawei auf dem Internationalen Symposium für Schaltungen und Systeme 2026 (ISCAS 2026)