2026年10月4日、ファーウェイ(Huawei)の余承東(リチャード・ユー)常務取締役は公開された動画を通じて、スマートフォン、AI、通信ネットワーク、スマートカーなどの領域に向け、381種類に及ぶ半導体「τ(タウ)チップ」の設計および量産化を完了したことを公表した。シリコン半導体のプロセス微細化が限界を迎えつつある現在、同社は独自の工学アプローチによってムーアの法則の有効性を維持しようとしている。
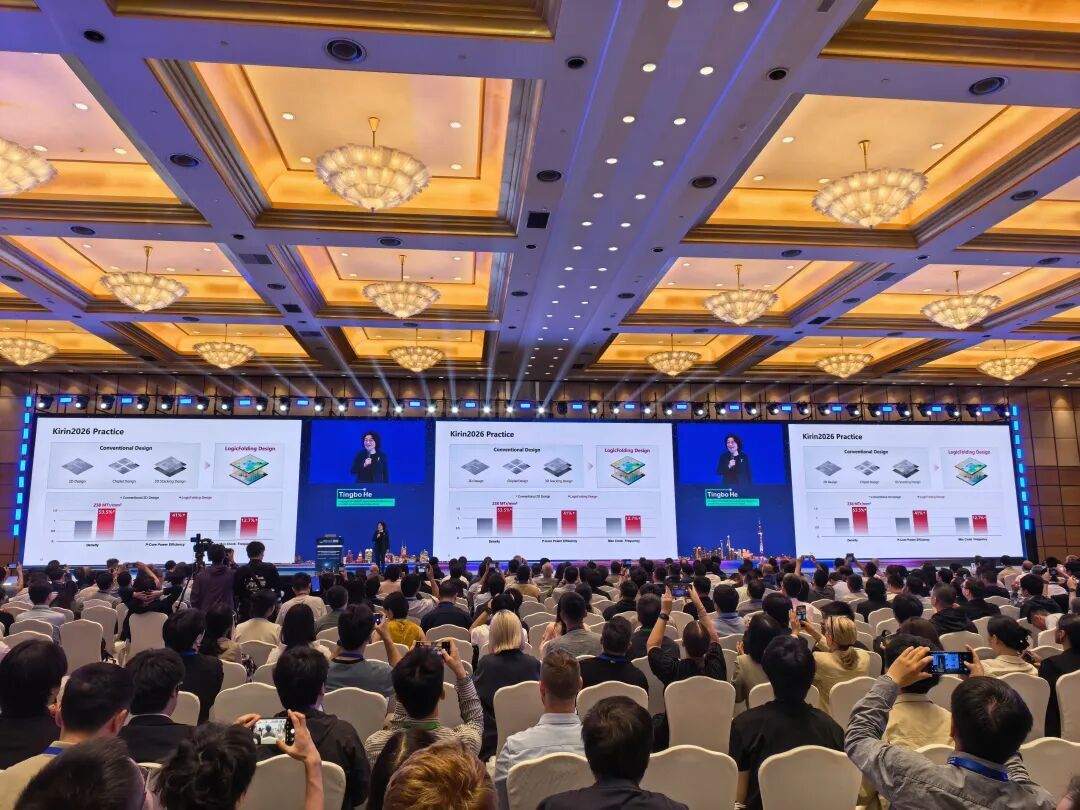 図:ファーウェイτチップのアーキテクチャ概要。出典:ファーウェイ(公式プレゼンテーション資料)
トランジスタの物理限界が接近、性能向上を「時間」に求める
半導体業界がこれまで歩んできた王道は、トランジスタの物理寸法を縮小し続けること、すなわち「幾何学的微細化」であった。エンジニアたちは露光装置を絶えず改良し、同一面積のシリコンウェハー上により微細で高密度な回路を刻み込んできた。しかし、プロセスルールが数ナノメートルからオングストローム領域に突入するにつれ、状況は一変した。量子トンネル効果やリーク電流による発熱の蓄積が極めて大きな物理的障壁となったのだ。加えて、極端紫外線(EUV)露光装置の導入・運用コストは天文学的に跳ね上がり、ウェハー1枚あたりから得られる性能向上の限界利益は著しく低下している。
この行き詰まった一本道に直面し、ファーウェイの半導体部門(海思半導体)を率いる何庭波(Teresa He)総裁は「韜(τ:タウ)の法則」を提唱した。この枠組みの戦略は極めて明快である。シリコン上で物理的空間を詰め込むコストが耐えがたい水準に達したならば、エンジニアはタスクの実行に要する「時間」の短縮に目を向けるべきだという発想だ。実際の半導体コンピューティング環境において、理論上のピーク演算性能がボトルネックになることは稀である。大半のクロックサイクルは、メインメモリ、各階層のキャッシュ、演算ユニット間におけるデータの往復移動で消費されている。データが届くのを待つパイプラインのアイドル状態も大きな無駄である。データの物理的な冗長経路を削ぎ落とし、演算ユニットを高負荷で稼働させ続けること。この時間軸に基づくアーキテクチャ最適化こそが、莫大な性能向上をもたらす源泉となる。
ロジックフォールディング技術が平面レイアウトの境界を打破
τチップは、最下層の物理デバイスから上位のシステムアーキテクチャに至るまで、徹底したボトムアップの再構築を経ている。最深部の物理デバイス層において、開発チームは単なる線幅の微細化を盲目的に追うことをやめた。トランジスタの3次元物理構造を最適化し、配線抵抗($R$)と寄生容量($C$)を精密に制御することで、デバイスレベルの時定数τを極限まで圧縮した。これが、よりアグレッシブな回路設計を可能にする強固な土台となっている。
さらに中核的な技術革新は回路レイアウト層で起きている。従来のチップ設計は2次元の平面配置に依存してきた。平面の物理的境界に縛られる結果、複雑な論理ブロック間には長大な物理配線を引き回す必要があり、それが信号伝搬遅延や電力消費を招いていた。ファーウェイは今世代の製品において「ロジックフォールディング(論理立体折りたたみ)」技術を導入した。クリティカルパスの配線経路を再構成し、立体的な信号伝送ネットワークを構築することで、信号伝搬時のRC負荷を大幅に削減した。回路構造が平坦な平面配置から立体的な折りたたみへと移行したことで、単位面積あたりの有効トランジスタ密度と信号伝送効率が同時に飛躍を遂げた。
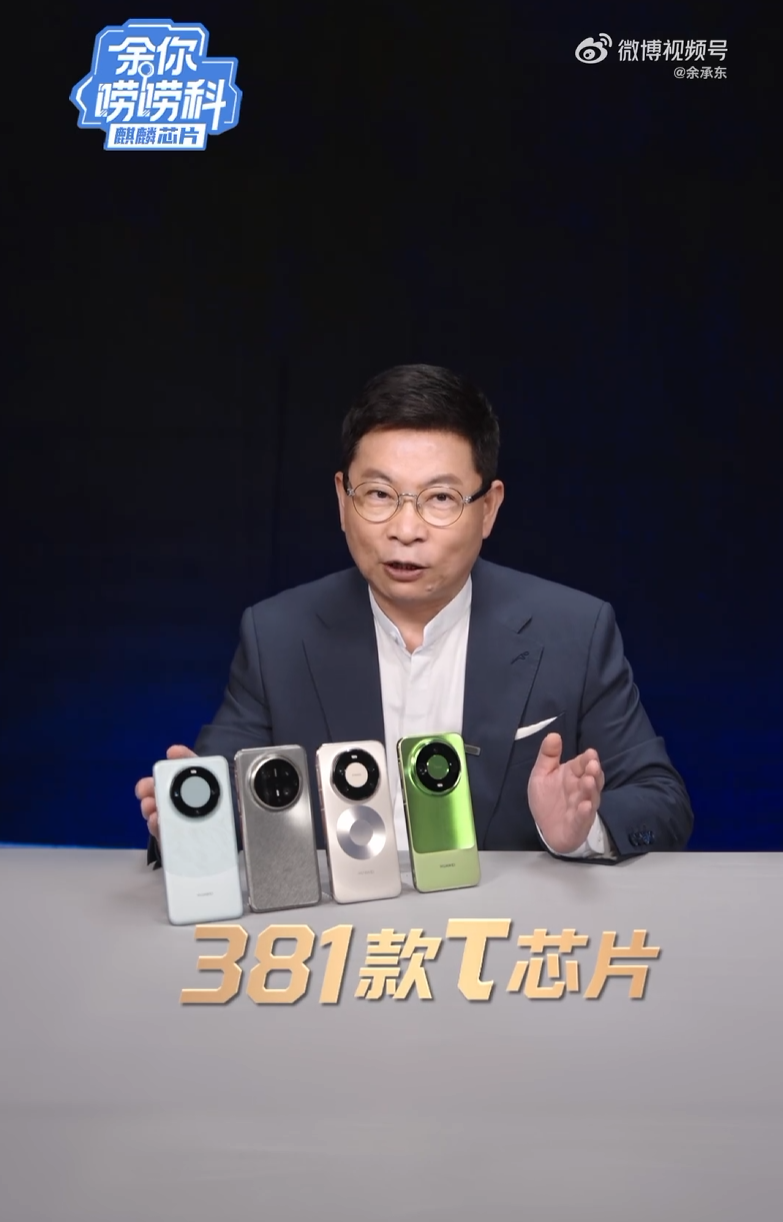 図:ファーウェイτチップの技術ロードマップ展望。出典:ファーウェイ(発表会スクリーンショット)
フルスタック協調で命令のエンドツーエンド実行時間を圧縮
ハードウェア構造における物理的イノベーションの真価を引き出すには、ソフトウェアとの高度な協調が不可欠である。システムレベルにおいて、τチップはハードウェア・ソフトウェア・シリコンが三位一体となったフルスタック協調設計を採用している。従来の計算アーキテクチャでは命令の流れが固定的かつ受動的であったのに対し、新アーキテクチャではデバイスの実稼働負荷に応じて命令ストリームとデータストリームが動的にスケジューリングされる。
制御精度の向上により、限られた計算リソースを極めてインテリジェントに配分できるようになった。並行負荷の高いタスクに直面した際には、深層命令プリフェッチと高精度な分岐予測を駆使して並列処理効率を高める。クロックサイクルの配分が無駄なく引き締められ、タスクのエンドツーエンド実行時間が大幅に圧縮される。従来であれば完了までに複数のサイクルを要していた複雑な演算処理が、はるかに短い時間で結果を出力できるようになった。
霊衢バスがスーパーノード間インターコネクトのメモリセマンティクスを再構築
個々のチップ単体の性能がどれほど優れていても、巨大な計算クラスタに接続された瞬間、ノード間通信が新たなシステム全体のボトルネックとなる。近年のフロンティアAIモデルの学習や大規模なクラスタ推論では、数百から数千枚のアクセラレータカードが協調して動作する必要がある。ノード間の通信障壁を打ち破るため、ファーウェイはシステムアーキテクチャ層に独自のインターコネクト技術「霊衢(Lingqu)バス」を定義した。
霊衢バスは、大規模計算システムの相互接続プロトコルを根底から刷新する。超大規模計算ノード間において統合メモリ空間のアドレス指定をネイティブサポートし、物理ノードをまたぐデータ交換が従来のデータバスの帯域限界を突破する。ネイティブなメモリセマンティクスに対応したことで、ネットワーク越しのデータ読み出しがローカルメモリへのアクセスと同等のダイレクト感で実行可能となった。システム全体の通信遅延が劇的に削減され、分散した計算ノード群が密結合のスーパーコンピューティングファブリックへと統合されることで、通信オーバーヘッドに起因する計算力のロスが極小化されている。
2031年に1.4nm相当の等価集積密度を標榜
半導体産業が先端微細化プロセスに対して抱く焦燥感の多くは、トランジスタ集積密度への過度な依存から生じている。ファーウェイの工学実践は、これに対する新たな解決モデルを提示した。公式のロードマップによると、韜の法則に基づく技術指針に沿って世代交代を進めることで、2031年までに本アーキテクチャを採用したハイエンドチップの等価トランジスタ密度は、従来の1.4nmプロセスの理論水準に達し、総合的な計算性能もそれに呼応して飛躍する見通しだという。
シリコンコンピューティングの競争次元は大きく広がった。最先端露光装置の直接調達が制限される外部環境下において、時定数を軸にしたシステムレベルの工学的再構築は、中国の半導体サプライチェーンが先端プロセスとの世代格差を埋める最も強靭な技術的回答となっている。 これはアーキテクチャ効率の上に築かれた全く新しいコンピューティングの軌道である。
381種のチップが支えるマルチ端末の自律型ハードウェア基盤
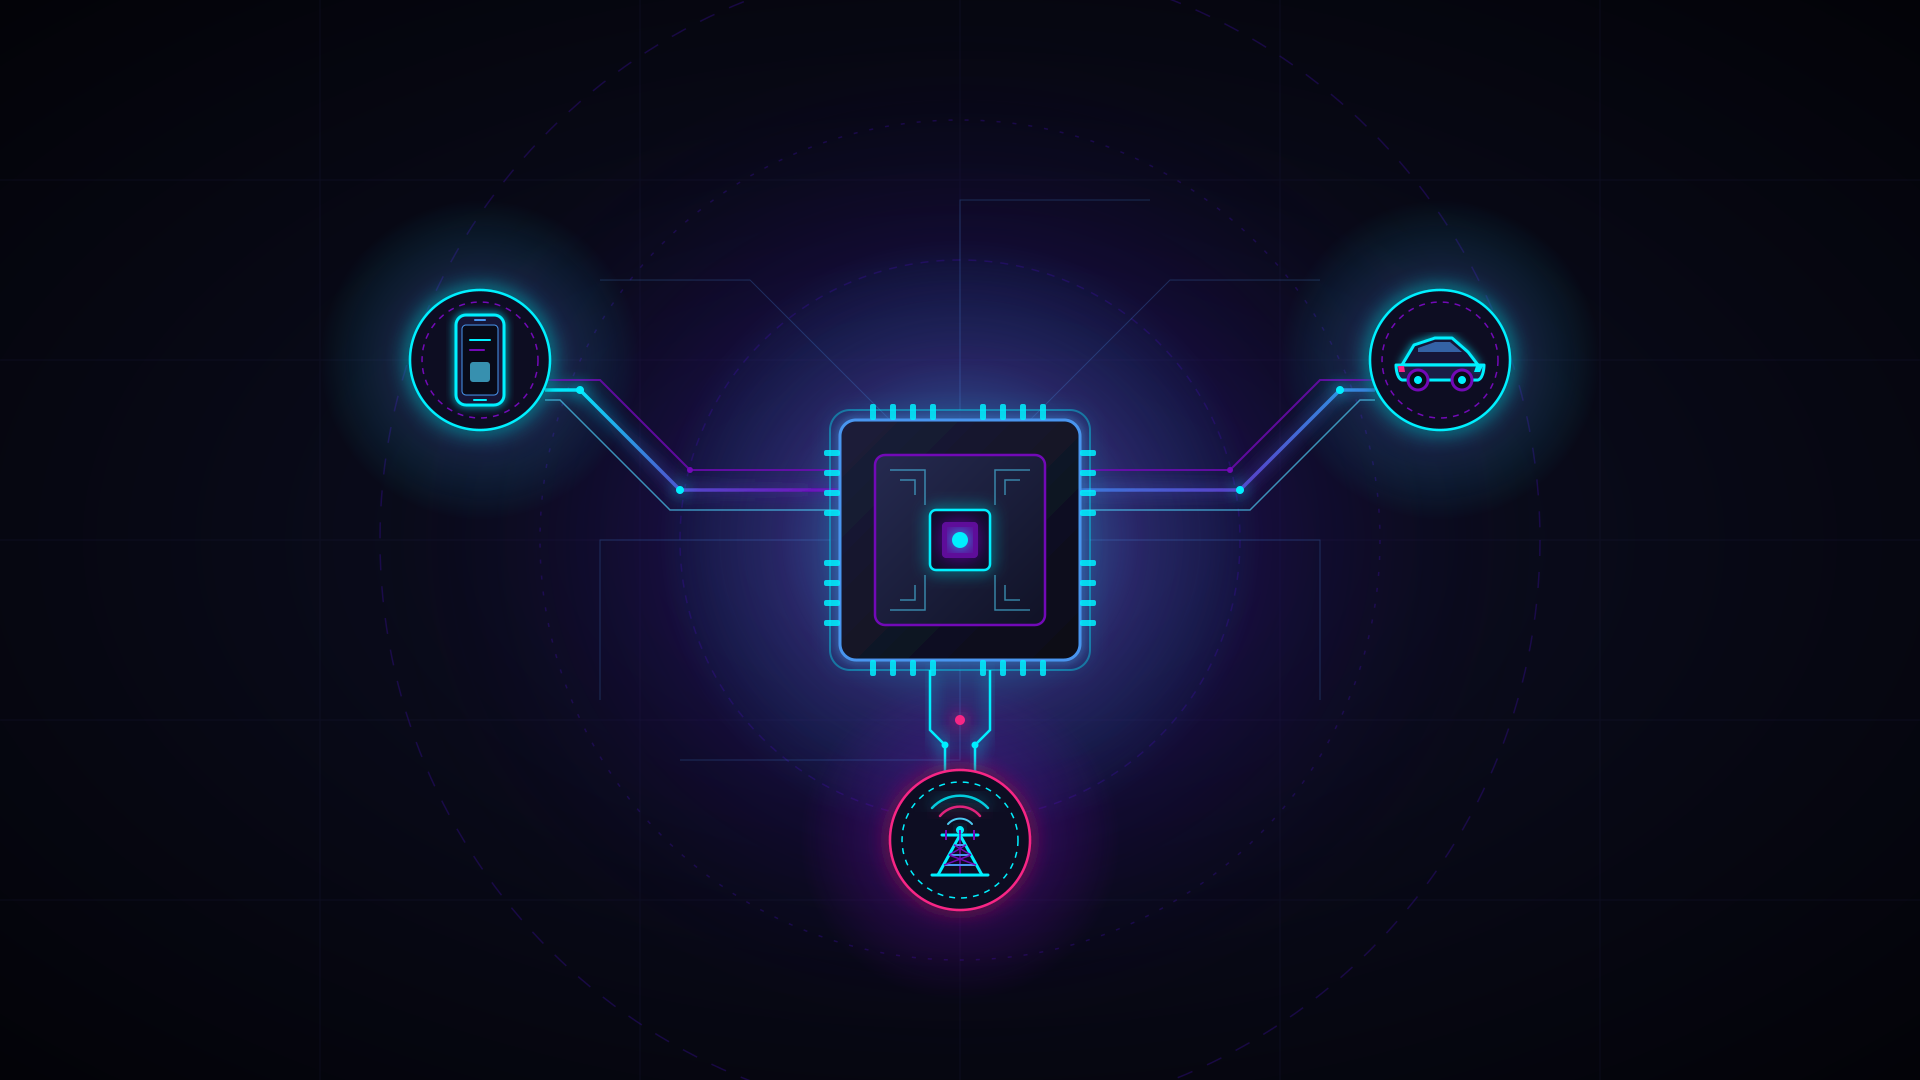
今回動画で公表された381種類に及ぶτチップは、特定製品のための単発的な試みではない。その展開先は、スマートフォンのフラッグシップSoCからスマートカーの自動運転プラットフォーム、さらにはクラウドの超大規模AIクラスタに至るまで多岐にわたる。これは、基礎的な物理デバイス層を出発点とし、アプリケーション生態系全体へと波及する包括的なシリコンレベルの再構築である。
これほど大規模なアーキテクチャ転換を成し遂げたことは、ファーウェイが全シナリオを網羅する自律型コンピューティング基盤をすでに確立したことを証明している。車載環境が求めるミリ秒単位の低遅延応答であれ、エッジデバイスが追求する高い電力効率であれ、最終的には独自構築されたハードウェア基盤がそれを支えなければならない。物理的な微細化競争から脱却し、時間微細化に基づく進化の道筋が世界の演算力競争の構図を塗り替えつつある。
参考リンク:
- ファーウェイ余承東常務取締役による半導体事業の最新進捗動画
- 2026年回路とシステムに関する国際シンポジウム(ISCAS 2026)ファーウェイ基調講演