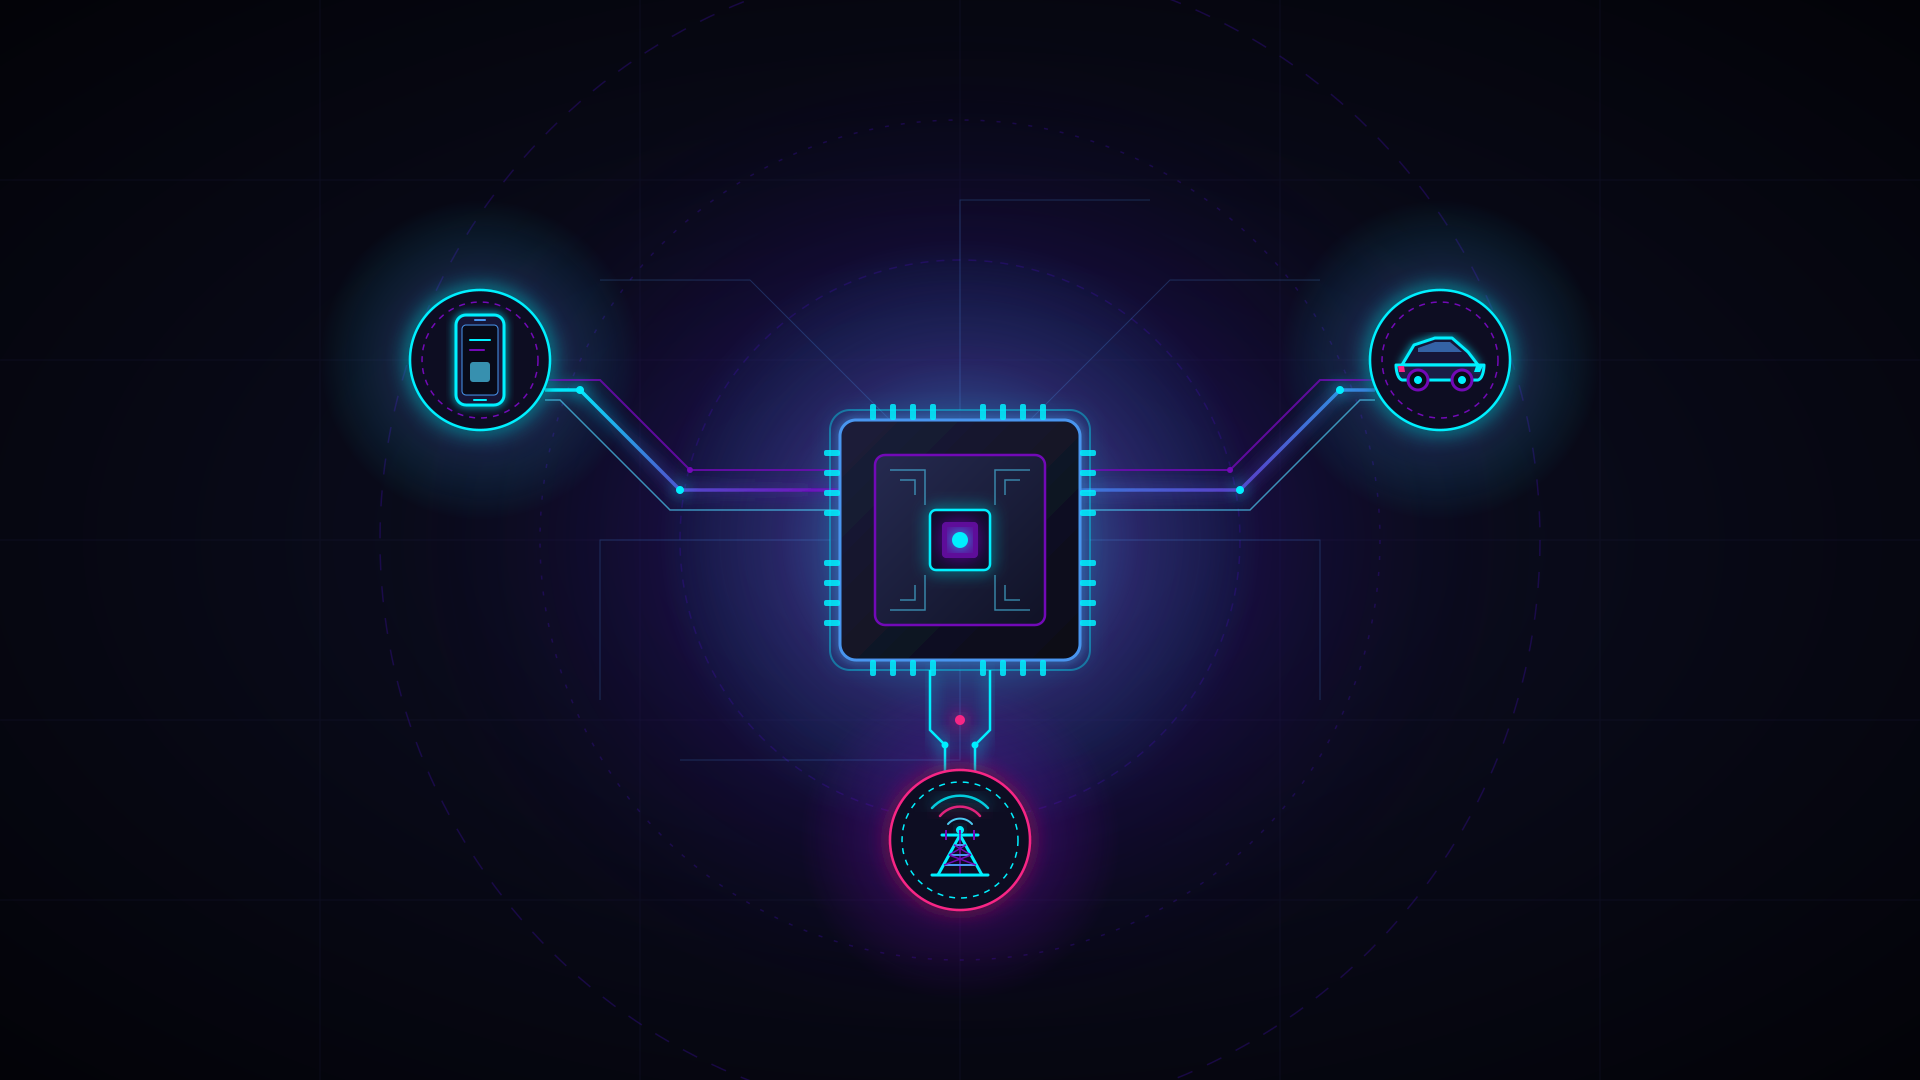
Le 4 octobre 2026, Richard Yu, directeur exécutif de Huawei, a confirmé dans une allocution vidéo que l’entreprise avait conçu et lancé avec succès la production en série de 381 modèles de puces semi-conductrices Tau ($\tau$), couvrant les téléphones mobiles, l’intelligence artificielle (IA), les infrastructures réseau et les véhicules connectés. À l’heure où les progrès de gravure sur silicium se heurtent à de redoutables butoirs physiques, le géant technologique inaugure une approche d’ingénierie novatrice pour préserver la dynamique de la loi de Moore.
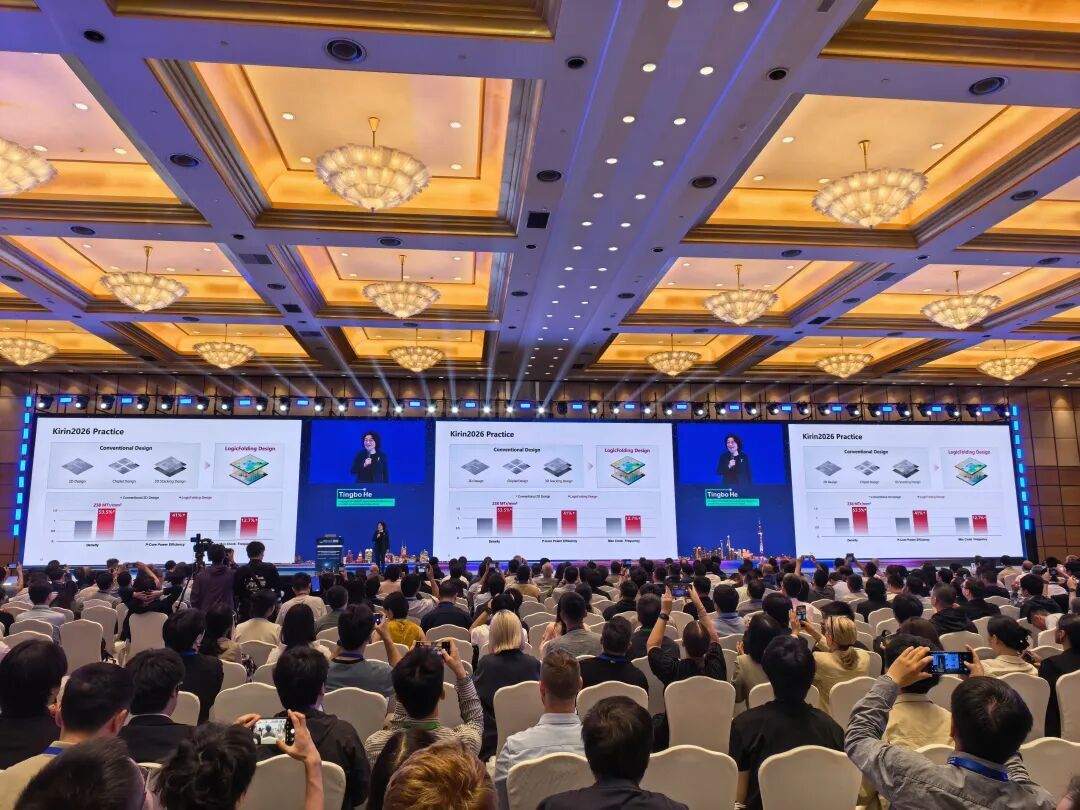 Figure : Schéma architectural des puces Huawei Tau. Source : Présentation officielle de Huawei.
Transistors aux limites physiques : puiser la performance dans la dimension temporelle
Historiquement, l’industrie des semi-conducteurs s’est construite sur la miniaturisation continue des dimensions physiques des transistors — la fameuse « mise à l’échelle géométrique » (geometric scaling). Au fil des décennies, les ingénieurs ont perfectionné les scanners de lithographie pour graver toujours plus de circuits sur une même surface de silicium. Cependant, à mesure que les nœuds technologiques atteignent les limites du nanomètre et abordent l’ère de l’angström, le comportement physique bascule. L’effet tunnel quantique et l’accumulation thermique provoquée par les courants de fuite dressent des barrières quasi infranchissables. Dans le même temps, les coûts d’acquisition et d’exploitation des équipements de lithographie ultraviolette extrême (EUV) s’envolent, tandis que les gains marginaux de performance par galette de silicium déclinent rapidement.
Face à cette impasse technique, Teresa He (He Tingbo), présidente de la division semi-conducteurs de Huawei (HiSilicon), a formalisé la « loi de Tau » ($\tau$). Le postulat stratégique est limpide : dès lors que le coût pour grapiller de l’espace physique sur le silicium devient exorbitant, les ingénieurs doivent réorienter leurs efforts vers la compression du temps d’exécution des tâches. Dans un environnement de calcul réel, le débit crête théorique constitue rarement le goulot d’étranglement décisif. La majeure partie des cycles d’horloge du système est absorbée par les allers-retours de données entre la mémoire vive, les différents niveaux de mémoire cache et les unités d’exécution. Les temps d’attente imposés aux cœurs dans l’attente des données représentent un gaspillage d’énergie considérable. En éliminant les chemins de transfert superflus et en maintenant les unités de calcul sous charge constante, cette optimisation axée sur la variable temporelle libère une marge de progression remarquable.
Le repliement logique brise les frontières de l’agencement bidimensionnel
Des composants physiques élémentaires jusqu’à l’architecture globale du système, les puces Tau ont fait l’objet d’une refonte complète de bas en haut. Au niveau physique fondamental, l’équipe de recherche a renoncé à la quête effrénée de gravures toujours plus fines. Les concepteurs ont plutôt optimisé la structure physique tridimensionnelle des transistors, maîtrisant avec une grande précision la résistance d’interconnexion ($R$) et la capacité parasite ($C$). En abaissant à son strict minimum la constante de temps physique $\tau$ des composants de base, ils ont jeté les fondations indispensables à des topologies de circuits beaucoup plus ambitieuses.
L’évolution la plus déterminante s’est produite à l’échelle du routage des circuits. La conception classique de puces demeure tributaire d’un agencement rigoureusement plan. Enfermées dans un espace à deux dimensions, les unités logiques complexes exigent de longs tracés de câblage physique, ce qui induit une latence de propagation des signaux et une déperdition d’énergie notable. Sur cette nouvelle génération, Huawei a déployé une technologie baptisée « repliement logique » (logic folding). En réorganisant les chemins critiques au sein d’un réseau de transmission tridimensionnel, les concepteurs ont sensiblement allégé la charge de résistance et de capacité. En délaissant l’étalement bidimensionnel au profit d’un repliement spatial en trois dimensions, la densité effective de transistors par unité de surface et l’efficacité de propagation du signal ont toutes deux accompli un saut qualitatif majeur.
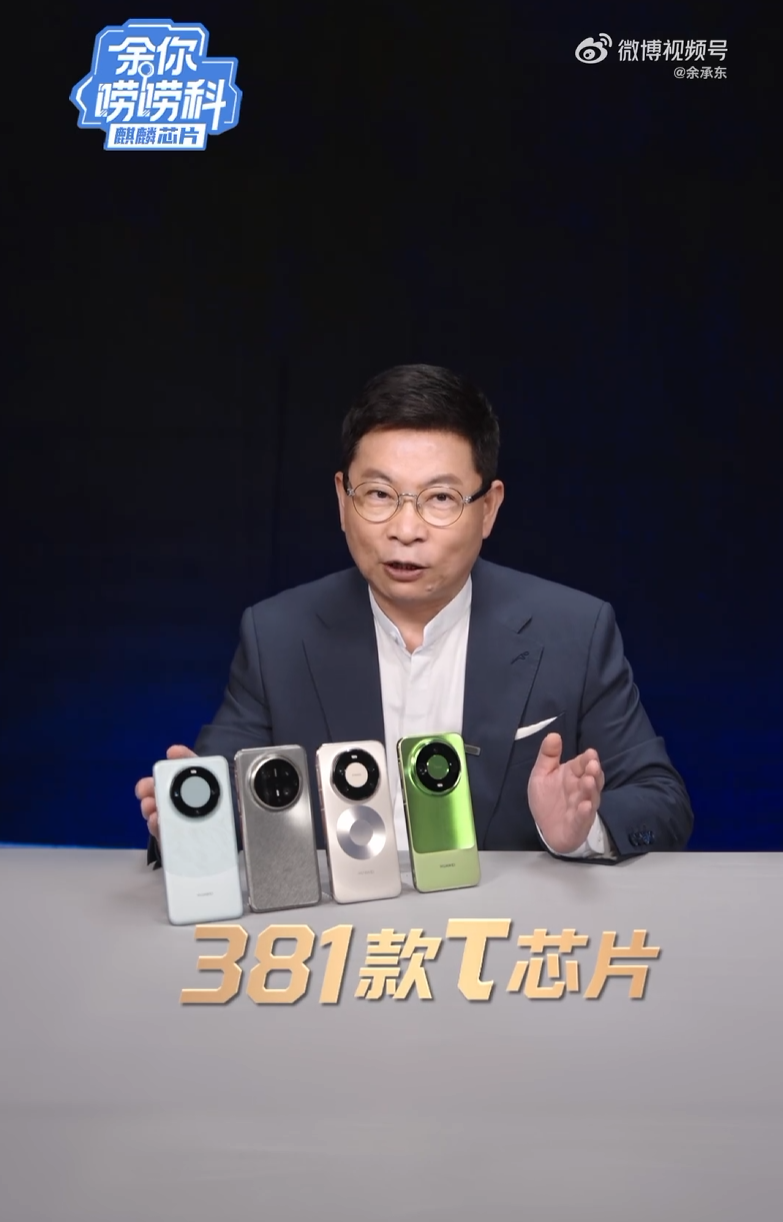 Figure : Projection et feuille de route technologique des puces Tau. Source : Capture de la conférence de Huawei.
Une co-conception de bout en bout pour comprimer les temps d’exécution des instructions
Les innovations physiques matérielles ne révèlent leur plein potentiel qu’à travers une synergie étroite avec la couche logicielle. À l’échelle du système, les puces Tau s’appuient sur une co-conception intégrée unissant logiciel, matériel et silicium. Dans les architectures traditionnelles, l’ordonnancement des instructions demeure statique et passif. Avec cette nouvelle architecture, le flux d’instructions et le flux de données sont planifiés dynamiquement en temps réel, selon la charge effective de l’appareil.
Ce surcroît de précision permet au système d’allouer les ressources de calcul avec une remarquable pertinence. Face à des scénarios hautement concurrents, le processeur active un préchargement profond des instructions et une prédiction de branchement à haute probabilité de succès pour optimiser l’efficacité du parallélisme. L’agencement des cycles d’horloge devient plus dense, réduisant drastiquement le temps total requis pour traiter une tâche de bout en bout. Des calculs complexes qui exigeaient auparavant de multiples cycles s’achèvent désormais dans des délais sensiblement écourtés.
Le bus Lingqu restructure la sémantique mémoire de l’interconnexion entre super-nœuds
Aussi puissante soit une puce prise isolément, son intégration au sein d’un vaste cluster de calcul fait inévitablement resurgir les communications réseau comme point de friction critique. L’entraînement des modèles d’IA de pointe et l’inférence complexe dans le cloud mobilisent aujourd’hui des centaines, voire des milliers de cartes accélératrices interconnectées. Pour faire tomber les barrières de communication entre les nœuds distribués, Huawei a défini au niveau de l’architecture système son propre bus d’interconnexion ultra-rapide : le bus Lingqu.
Le bus Lingqu refonde les protocoles d’interconnexion sous-jacents des systèmes informatiques. Il prend en charge un adressage mémoire unifié à travers des super-nœuds de très grande échelle, affranchissant les échanges de données inter-nœuds des plafonds de débit des bus de données conventionnels. Grâce à la prise en charge native de la sémantique mémoire, la lecture de données à travers le réseau s’effectue avec la même immédiateté qu’un accès direct à la mémoire vive locale. La latence de communication du système s’en trouve spectaculairement réduite, fédérant des nœuds de calcul épars en un tissu de calcul haute performance étroitement coordonné tout en limitant les pertes de puissance de calcul dues aux surcoûts réseau.
Cap sur 2031 : viser une densité équivalente à la gravure en 1,4 nanomètre
L’inquiétude permanente de l’industrie des semi-conducteurs face à la course aux nœuds avancés provient en grande partie d’une dépendance historique à la densité d’intégration physique des transistors. L’ingénierie de Huawei dessine une trajectoire différente. D’après la feuille de route officielle, la poursuite du développement selon la loi de Tau permettra aux puces haut de gamme reposant sur cette architecture d’atteindre d’ici 2031 une densité de transistors équivalente au niveau théorique d’un procédé conventionnel en 1,4 nanomètre, tout en enregistrant une progression corrélée de leurs capacités de calcul globales.
Le champ de bataille du silicium s’ouvre ainsi à de nouvelles dimensions. Dans un contexte de restrictions externes interdisant l’accès direct aux équipements de photolithographie les plus perfectionnés, la refonte systémique par l’ingénierie des constantes temporelles constitue la réponse technologique la plus solide pour permettre à la chaîne d’approvisionnement nationale de rattraper l’écart générationnel. Il s’agit d’une nouvelle voie de calcul résolument bâtie sur l’efficacité architecturale.
381 puces dessinent l’infrastructure matérielle souveraine de l’écosystème
Les 381 puces Tau officialisées lors de cette annonce ne se résument pas à un coup d’éclat isolé. Leurs scénarios de déploiement s’étendent des SoCs pour smartphones haut de gamme aux plateformes de calcul pour la conduite autonome, en passant par les clusters d’accélération IA géants dans le cloud. Cette métamorphose globale au niveau du silicium prend sa source dans les propriétés physiques des composants pour irriguer l’ensemble de l’écosystème applicatif.
L’aboutissement d’une transition architecturale d’une telle envergure prouve que Huawei dispose désormais d’un socle de calcul autonome et polyvalent. Qu’il s’agisse des impératifs sévères de faible latence dans l’automobile ou des exigences d’efficacité énergétique des appareils mobiles, la souveraineté matérielle constitue l’indispensable clé de voûte. En s’émancipant de la seule course à la miniaturisation géométrique, la voie fondée sur la mise à l’échelle temporelle redéfinit les règles du jeu dans la compétition mondiale pour la puissance de calcul.
Liens de référence :
- Vidéo de Richard Yu, directeur exécutif de Huawei, détaillant les avancées dans les semi-conducteurs
- Discours d’ouverture de Huawei au Symposium international sur les circuits et systèmes 2026 (ISCAS 2026)