El 4 de octubre de 2026, el director ejecutivo de Huawei, Richard Yu, confirmó mediante una comparecencia en vídeo que la compañía ha culminado con éxito el diseño y la producción en masa de 381 modelos de chips semiconductores Tau ($\tau$) destinados a teléfonos móviles, inteligencia artificial (IA), infraestructuras de red y automoción inteligente. En un momento en el que el avance de los procesos litográficos basados en silicio choca contra infranqueables barreras físicas, el gigante tecnológico busca preservar la vigencia de la Ley de Moore mediante un nuevo paradigma de ingeniería.
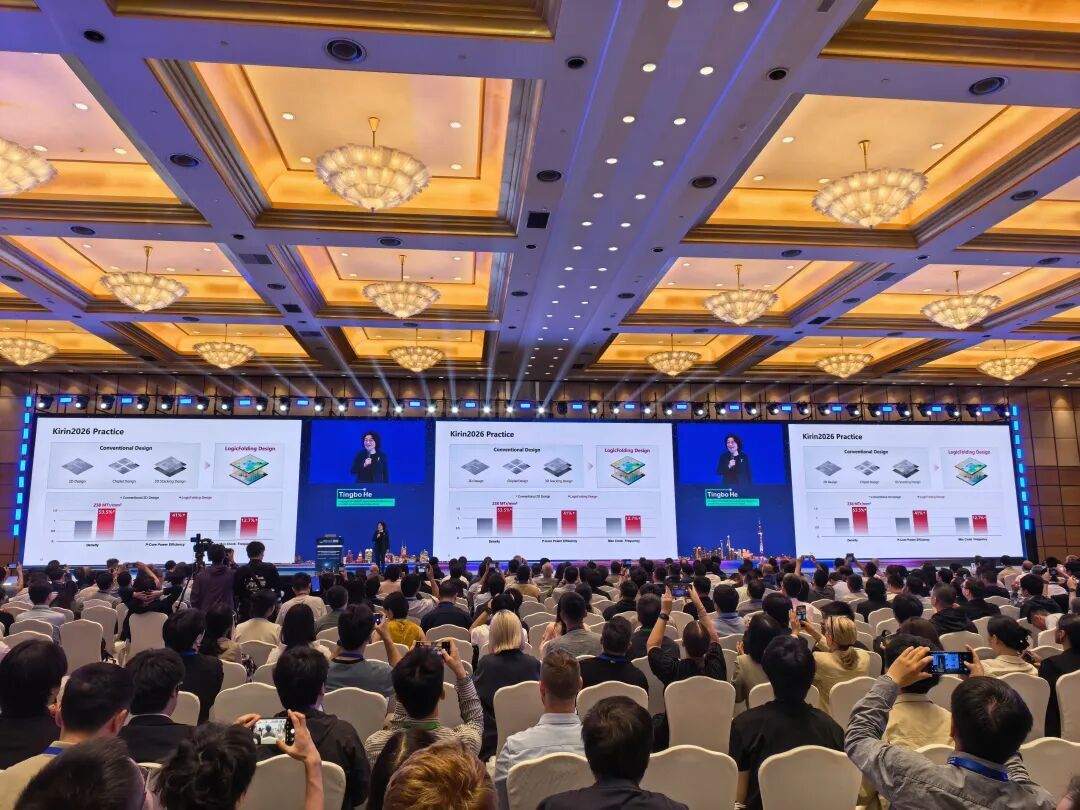 Figura: Esquema de la arquitectura de los chips Huawei Tau. Fuente: Presentación oficial de Huawei
Transistores al límite físico: buscar el rendimiento en la dimensión temporal
La senda tradicional de la industria de semiconductores se ha fundamentado históricamente en la reducción continuada de las dimensiones físicas de los transistores, la conocida como «escala geométrica» (geometric scaling). Siguiendo este rumbo, los ingenieros perfeccionaron sin descanso los equipos de litografía para grabar un número cada vez mayor de circuitos sobre la misma superficie de silicio. Sin embargo, al aproximarse los nodos de fabricación a unos pocos nanómetros e ingresar en la escala del ángstrom, el comportamiento físico experimenta un giro radical. El efecto túnel cuántico y la acumulación térmica provocada por las corrientes de fuga se convierten en obstáculos difícilmente salvables. A ello se suma la escalada desorbitada en los costes de adquisición y mantenimiento de los sistemas de litografía ultravioleta extrema (EUV), con un rendimiento marginal por oblea de silicio en franco declive.
Frente a un camino de rendimiento decreciente, Teresa He (He Tingbo), presidenta de la división de semiconductores de Huawei (HiSilicon), formuló la denominada «Ley de Tau» ($\tau$). El planteamiento estratégico es directo: si el coste de exprimir espacio físico en el silicio resulta inasumible, la ingeniería debe redirigir su mirada hacia la compresión del tiempo necesario para ejecutar las tareas. En un entorno informático real, la potencia de cálculo bruta rara vez constituye el cuello de botella decisivo. La mayor parte de los ciclos de reloj del sistema se pierden en el continuo trasvase de datos entre la memoria principal, los niveles de caché y las unidades de procesamiento. Los tiempos de inactividad a la espera de que los datos estén listos suponen un enorme desperdicio de recursos. Eliminar rutas de datos físicas redundantes y mantener las unidades de cálculo operando de forma continua bajo alta carga permite liberar un notable incremento de rendimiento mediante esta optimización temporal.
La tecnología de plegado lógico rompe las barreras del diseño bidimensional
Desde los dispositivos físicos más elementales hasta la arquitectura del sistema en su conjunto, los chips Tau han experimentado una profunda reconstrucción de abajo hacia arriba. En el estrato más bajo de la física de dispositivos, el equipo de desarrollo descartó la carrera indiscriminada por reducir la anchura de línea. En su lugar, optimizaron la estructura física tridimensional de los transistores, regulando con precisión la resistencia de interconexión ($R$) y la capacitancia parásita ($C$). Al comprimir al mínimo la constante de tiempo $\tau$ en el plano físico de los componentes, sentaron las bases para abordar diseños de circuitos mucho más avanzados.
El avance tecnológico neurálgico se materializa en la capa del circuito. El diseño convencional de chips depende en gran medida de disposiciones planares bidimensionales. Restringidos por los límites del plano 2D, los bloques lógicos complejos requieren un extenso entramado de pistas físicas, lo que genera retrasos en la propagación de señales y un gasto energético prescindible. Para esta generación, Huawei ha integrado la tecnología de «plegado lógico» (logic folding). Los diseñadores reorganizaron las rutas críticas de interconexión para tejer una red de transmisión de señales en tres dimensiones, minimizando drásticamente la carga de resistencia y capacitancia. Al abandonar la disposición puramente plana en favor de una estructura plegada tridimensional, la densidad efectiva de transistores por unidad de superficie y la eficiencia de transmisión de señales dieron un salto cualitativo simultáneo.
 Figura: Proyección y evolución técnica de los chips Tau. Fuente: Captura de la presentación de Huawei
Optimización integral para reducir la latencia de ejecución extremo a extremo
Las innovaciones físicas introducidas en el silicio requieren una estrecha sintonía con la capa de software para materializarse en ganancias reales. En el plano de sistemas, los chips Tau aplican un codiseño integral que combina hardware, software y silicio. En las arquitecturas de computación tradicionales, el flujo de instrucciones se gestiona de forma rígida y pasiva. Con el nuevo esquema, tanto las instrucciones como los flujos de datos se planifican dinámicamente en tiempo real en función de la carga efectiva de trabajo del dispositivo.
Esta precisión en el control permite una asignación mucho más inteligente de los recursos de cómputo disponibles. Ante tareas de alta concurrencia, el procesador activa técnicas avanzadas de precarga de instrucciones (prefetching) y predicción de saltos de alta efectividad para maximizar el paralelismo operativo. La distribución de los ciclos de reloj se compacta notablemente, reduciendo con contundencia el tiempo total necesario para completar los procesos de principio a fin. Operaciones complejas que antes precisaban varios ciclos para finalizarse pueden ahora entregar resultados en un plazo sustancialmente menor.
El bus Lingqu reestructura la semántica de memoria en la interconexión de supernodos
Por elevada que sea la potencia local de un chip individual, al integrarse en grandes clústeres de computación, la intercomunicación entre nodos suele transformarse en el factor limitante del sistema. El entrenamiento de grandes modelos fundacionales de IA y la inferencia masiva en la nube demandan hoy en día la cooperación sincronizada de cientos o miles de tarjetas aceleradoras. Para derribar estas barreras de comunicación interconectada, Huawei definió a nivel de arquitectura su propio bus de alta velocidad: Lingqu Bus.
El bus Lingqu renueva por completo los protocolos de interconexión de los sistemas de computación distribuida. Admite un direccionamiento unificado de memoria entre supernodos de gran escala, permitiendo que el intercambio de datos entre nodos físicos supere los cuellos de botella de ancho de banda de los buses tradicionales. Gracias a su compatibilidad nativa con semántica de memoria, la lectura de datos a través de la red se produce de forma tan fluida y directa como si se accediese a la memoria física local. La latencia de comunicación del sistema disminuye ostensiblemente, articulando nodos dispersos en una densa red de supercomputación y minimizando las pérdidas de rendimiento provocadas por la sobrecarga en la transmisión de datos.
Objetivo 2031: alcanzar la densidad equivalente a un proceso de 1,4 nanómetros
La constante inquietud del sector de los semiconductores en torno a los nodos de vanguardia obedece en gran medida a una dependencia histórica de la densidad de integración de transistores. La propuesta de Huawei abre una vía de desarrollo alternativa. De acuerdo con la hoja de ruta oficial, si se continúa la evolución marcada por la Ley de Tau, para el año 2031 los chips de gama alta fabricados bajo esta arquitectura alcanzarán una densidad equivalente a la de un proceso litográfico convencional de 1,4 nanómetros, registrando una mejora paralela en su rendimiento computacional global.
El marco competitivo del silicio ha ampliado su dimensión. Ante las restricciones externas que impiden acceder de forma directa a la maquinaria de litografía más avanzada, la reestructuración de ingeniería a nivel de sistema basada en constantes temporales se erige como la respuesta técnica más sólida para que la cadena de suministro nacional recorte distancias generacionales. Se trata de una senda de computación cimentada sobre la eficiencia arquitectónica.
381 chips configuran una base de hardware autónoma para múltiples plataformas
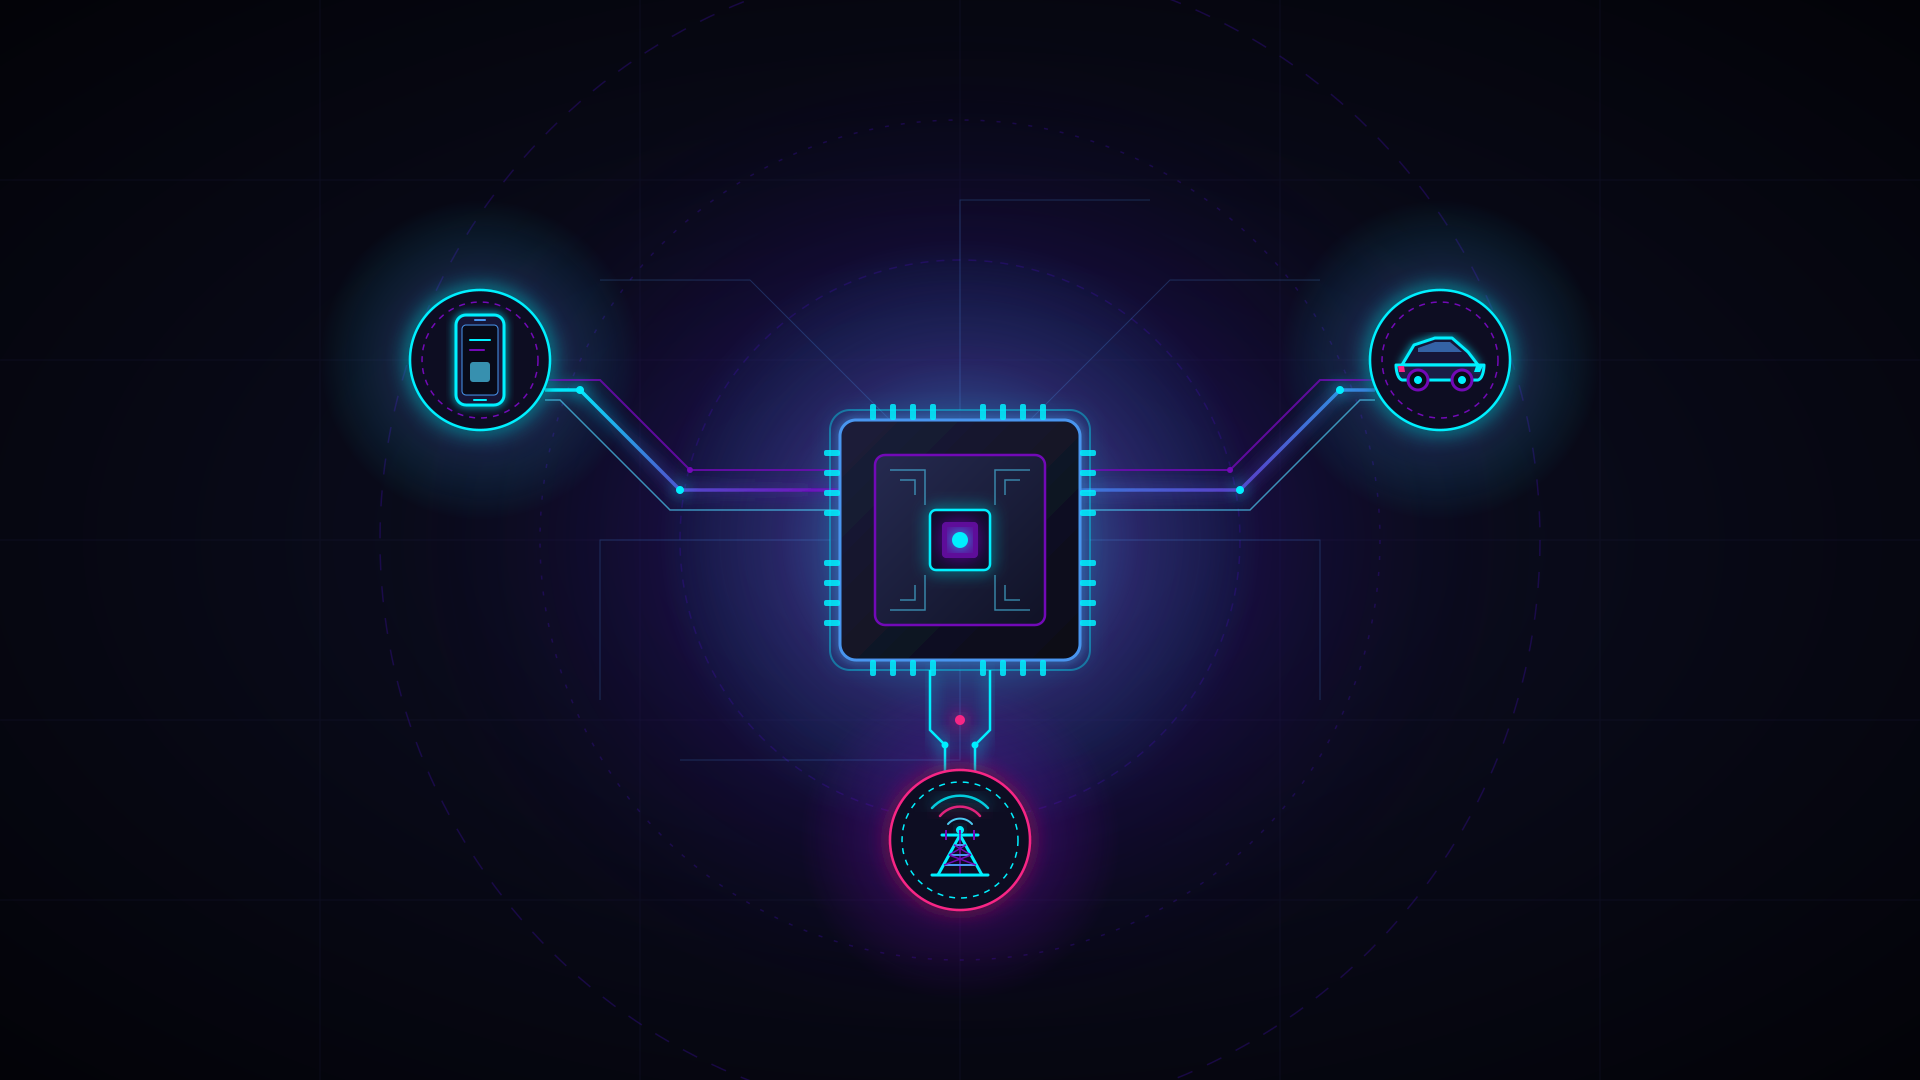
Las 381 referencias de chips Tau anunciadas no corresponden a un desarrollo aislado ni a una única línea de producto. Su despliegue abarca desde SoCs principales para terminales móviles y plataformas de conducción autónoma para vehículos conectados, hasta clústeres de aceleración de IA a hiperescala en la nube. Supone una remodelación integral a nivel de silicio que parte de las estructuras físicas básicas y abarca todo el ecosistema de aplicaciones.
Consolidar una transición arquitectónica de tal magnitud demuestra que Huawei ha establecido una base computacional autónoma y apta para todo tipo de escenarios. Ya sea para satisfacer las exigentes necesidades de respuesta en tiempo real que demanda el entorno del automóvil o la búsqueda de máxima eficiencia energética en terminales móviles, el respaldo de una arquitectura de hardware propia resulta imprescindible. Al desvincularse de la competencia exclusiva en miniaturización física, el camino fundamentado en la escala temporal redefine el tablero global del rendimiento informático.
Enlaces de referencia:
- Vídeo de Richard Yu, director ejecutivo de Huawei, sobre los avances en semiconductores
- Ponencia principal de Huawei en el Simposio Internacional de Circuitos y Sistemas 2026 (ISCAS 2026)