El 1 de octubre de 2026, Cloudflare presentó oficialmente dos modelos de decisión multimodales de código abierto: Clef y Clef-flash. En lugar de decantarse por Llama o Mistral como base, la compañía optó directamente por optimizar y entrenar conjuntamente sobre Qwen3.8-27B y Qwen3.5-9B de Alibaba Tongyi. De este modo, un gigante de la computación perimetral y las CDN entra de lleno en el entrenamiento de sus propios clasificadores de decisión.
Tradicionalmente, las empresas han delegado el juicio operativo en grandes modelos lingüísticos alojados en la nube. Sin embargo, cada tarea de moderación de contenidos o filtrado de tráfico malicioso acarreaba costosas latencias de primer token. Obligar a un modelo generalista de cientos de miles de millones de parámetros a resolver una clasificación binaria resulta ineficiente desde el punto de vista de los costes. La respuesta de Cloudflare consiste en dotar al extremo de la red (edge) de un motor de decisión específico.
Codificador visual integrado: uniendo percepción y decisión
Antes de la llegada de Clef, el modelo Jev desarrollado por TypeSafe representaba el estándar de rendimiento en modelos de decisión abiertos. Sin embargo, Jev se limitaba exclusivamente a la clasificación de texto y estaba constreñido por una ventana de contexto de 32k. Ante solicitudes de moderación que incluían capturas de pantalla, los desarrolladores se veían forzados a incorporar módulos OCR externos. La información visual debía traducirse torpemente a texto antes de poder ser evaluada por el modelo.
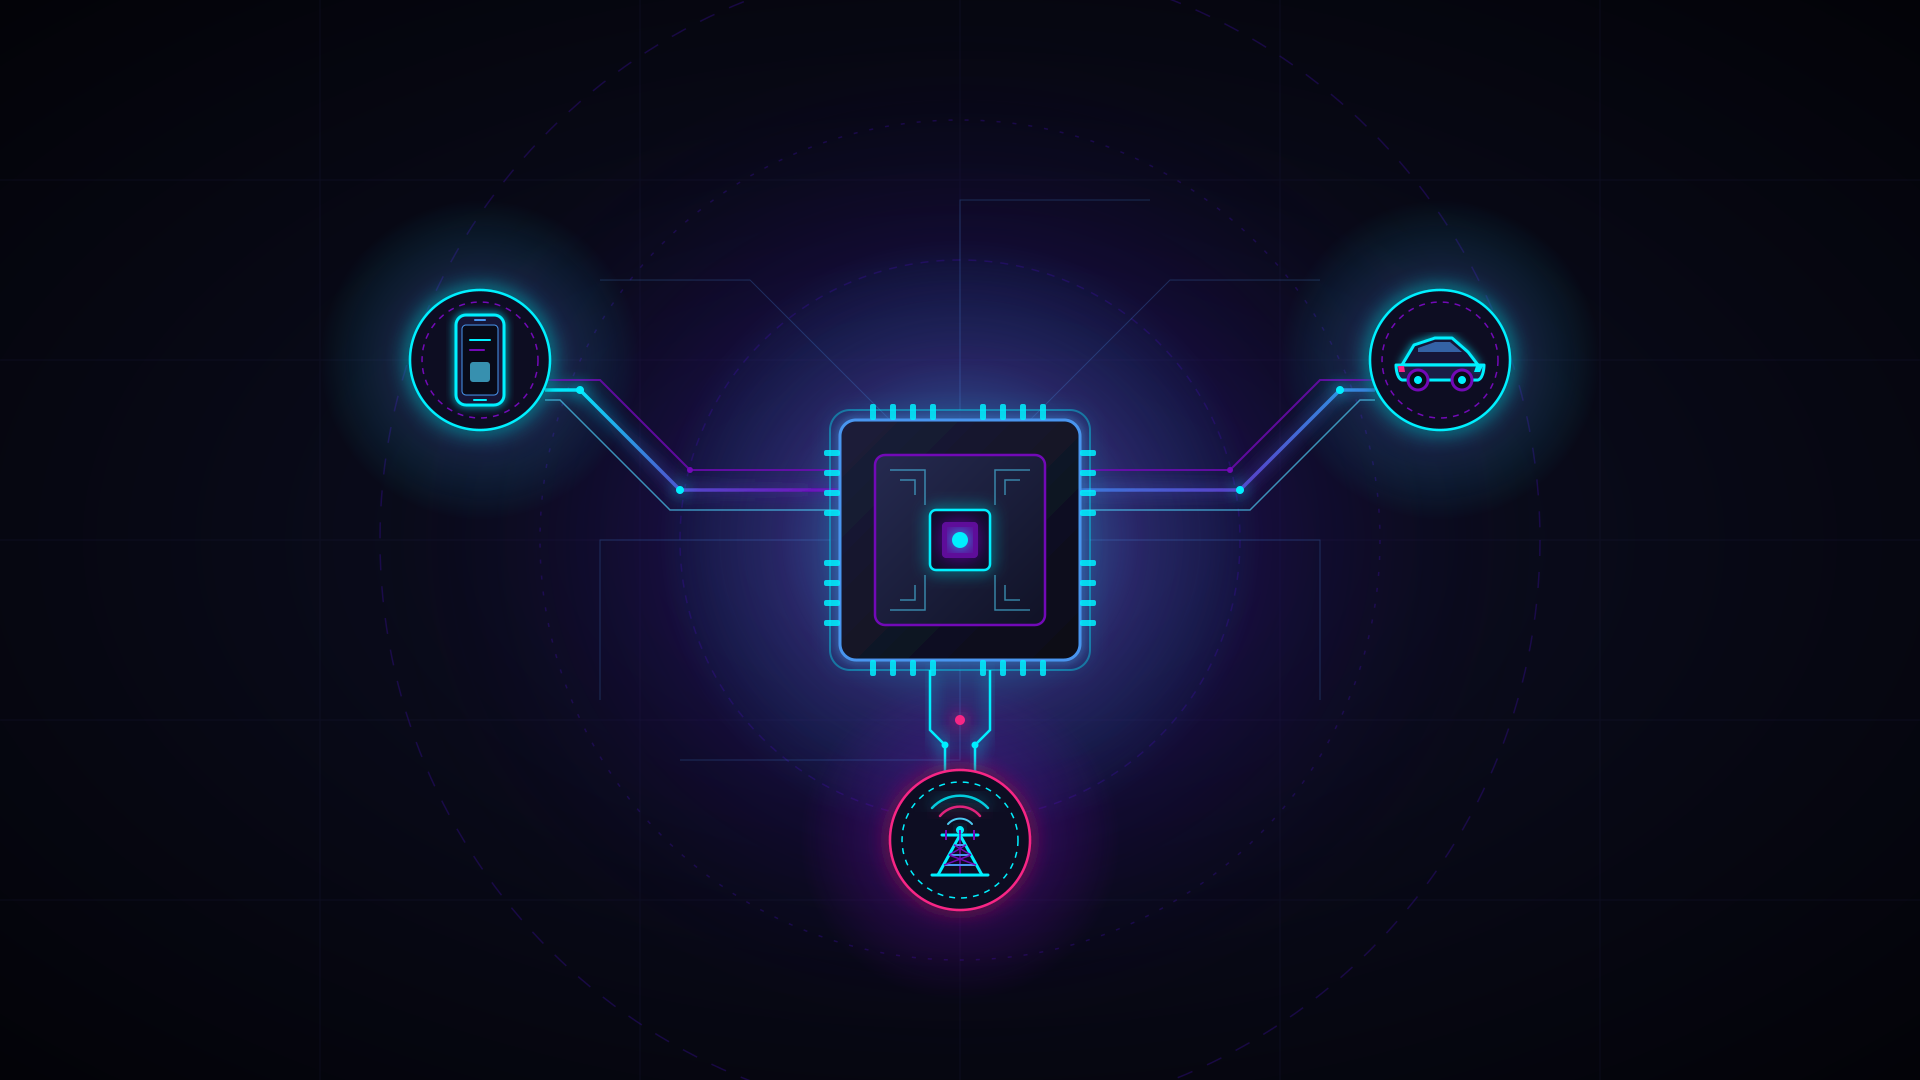
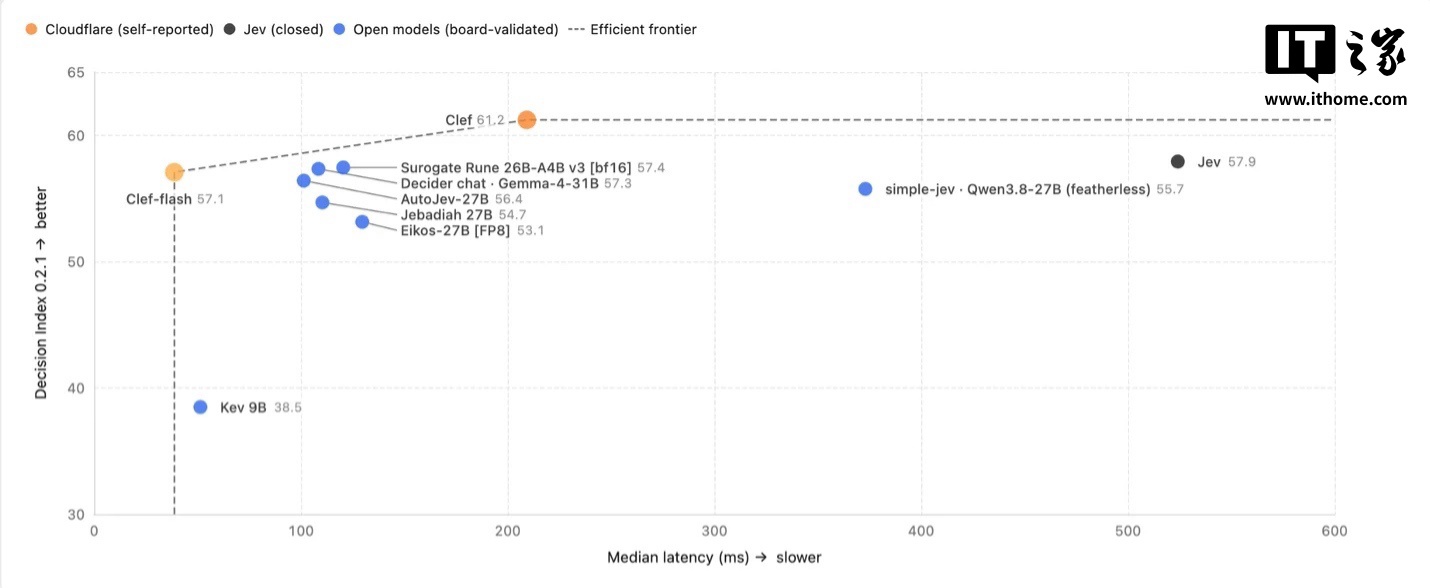 Figura: Diagrama de la lógica de ejecución del modelo Clef. Fuente: Cloudflare Blog
Clef incorpora de forma nativa un codificador visual y eleva el límite de entrada a 64k tokens. Al ser capaz de interpretar imágenes directamente, el modelo elimina las pérdidas y demoras inherentes a la conversión intermedia a texto. Los desarrolladores pueden empaquetar estados del sistema y registros mucho más densos dentro de la ventana de 64k. La cadena de análisis visual y toma de decisiones se cierra físicamente en el edge, demostrando que la comprensión visual ya no es coto exclusivo de los grandes modelos monolíticos.
Supresión de la generación de texto a cambio de una calibración milimétrica
Con el objetivo de transformar a Qwen en un clasificador de alta frecuencia, el equipo de desarrollo de Cloudflare implementó compromisos arquitectónicos estrictos. Congelaron las capas centrales de Qwen3.8-27B y Qwen3.5-9B, añadiendo únicamente adaptadores de bajo rango (LoRA) de rango 256 para el ajuste fino. Al combinar la pérdida de Brier para calibrar probabilidades con entropía cruzada y suavizado de etiquetas (label smoothing), bloquearon por completo la capacidad de generación textual de Clef.
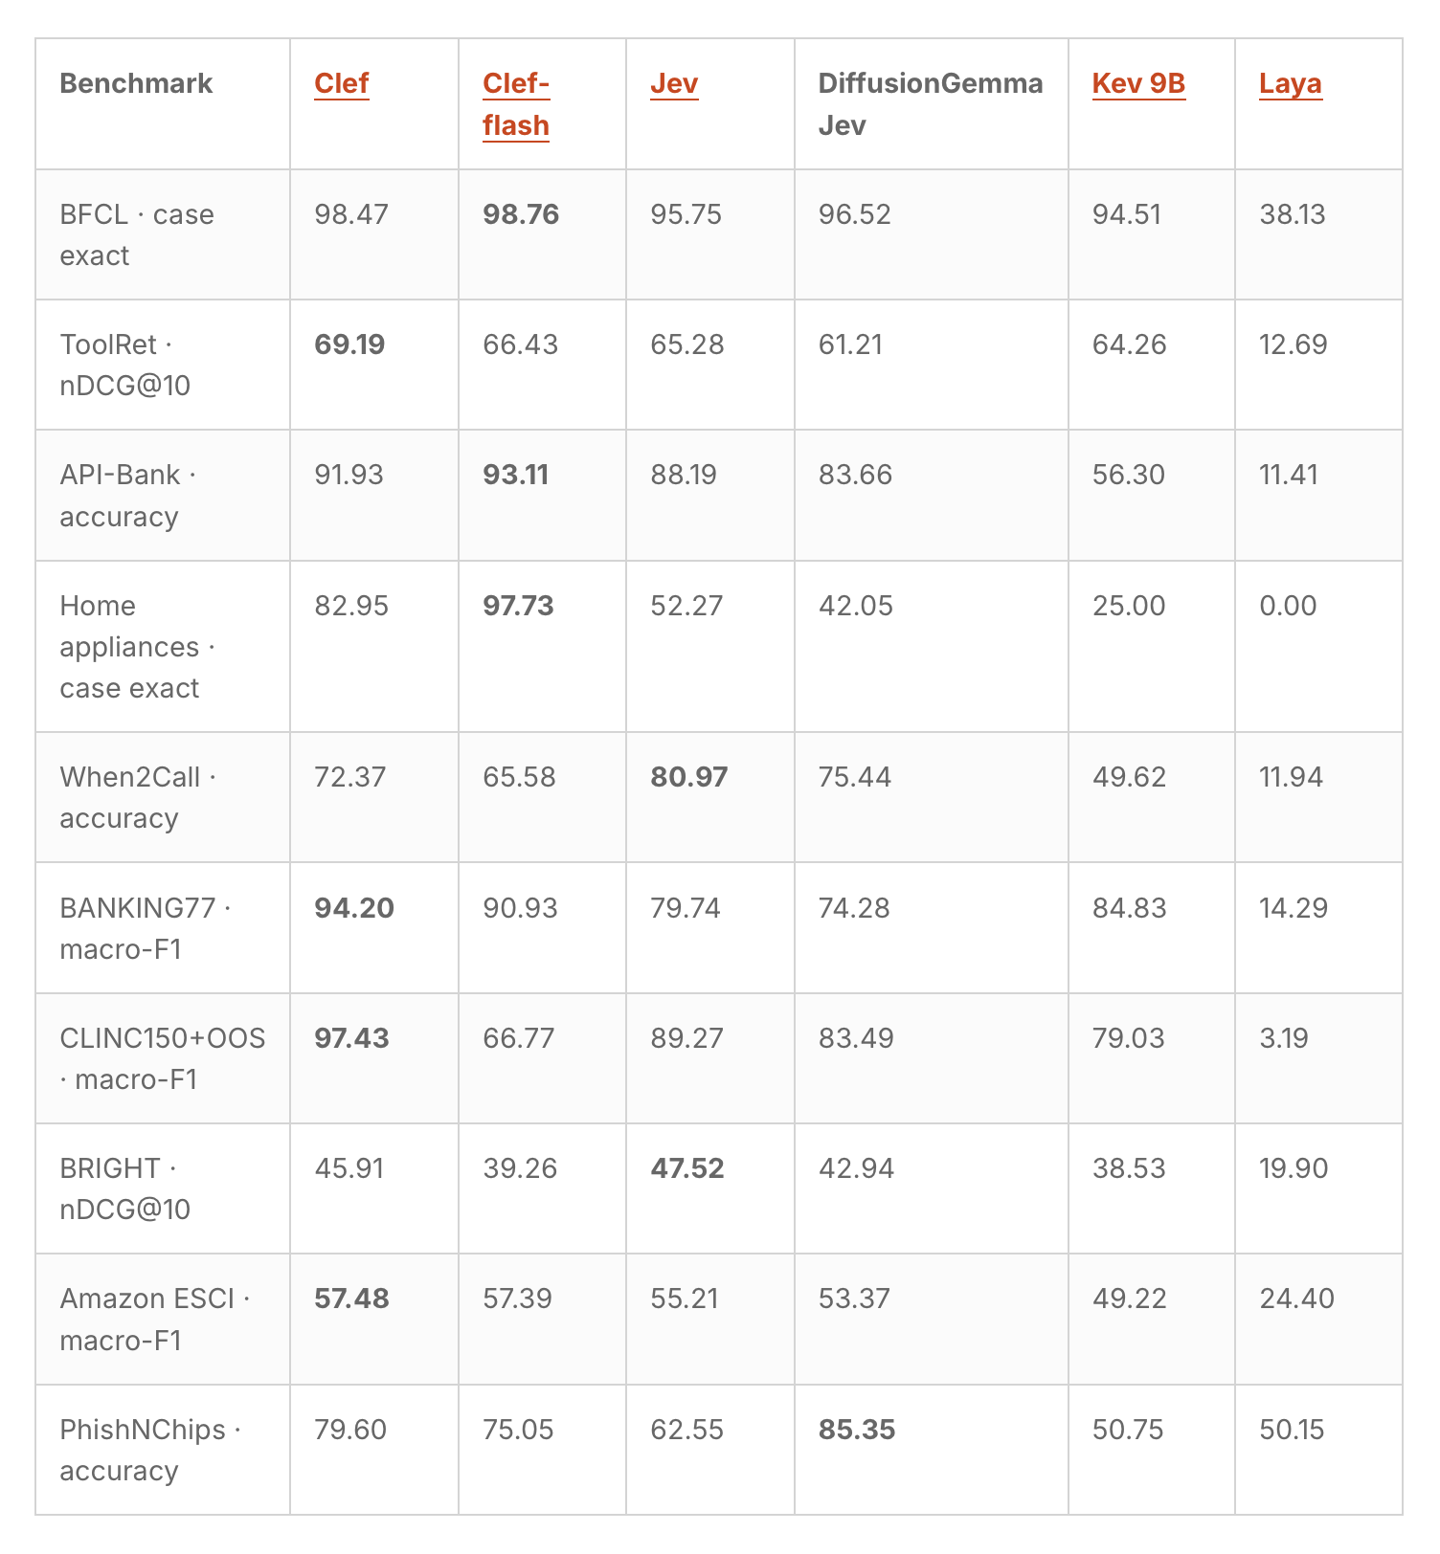 Figura: Rendimiento de Clef frente a modelos comparables como Jev y Kev. Fuente: Cloudflare Blog
Durante la inferencia, el modelo no emite explicaciones ni prosa conversacional. Está programado exclusivamente para devolver distribuciones de probabilidad rigurosas bajo un esquema (Schema) determinado. Esta restricción física en el formato de salida se tradujo en un salto exponencial de la precisión decisoria.
En la evaluación de referencia Jev Decision Index (versión 0.2.1), Clef alcanzó 98,47 puntos y Clef-flash se situó en 98,76 puntos. Ambas marcas superaron con holgura los 95,75 puntos de Jev y dejaron muy atrás a Kev 9B. Toda la capacidad computacional se canaliza hacia una única misión: clasificación y verificación. Renunciar a la conversación a cambio de respuestas en milisegundos encaja con absoluta precisión en las exigencias de ingeniería de los sistemas de alta concurrencia.
Datos sintéticos para garantizar la robustez en producción
El pilar sobre el que descansa este mecanismo de alta precisión es un conjunto de datos sintéticos generado internamente por Cloudflare. A lo largo del entrenamiento, los desarrolladores alteraron de manera deliberada el orden de los campos, los prompts del sistema y la estructura del esquema. Esta perturbación controlada reforzó la tolerancia y solidez del modelo ante peticiones complejas e impredecibles en el edge.
Asimismo, el equipo introdujo el aprendizaje por refuerzo a partir de distribuciones categóricas (RLCD) como objetivo secundario de optimización. Este sistema asigna puntuaciones parciales a opciones ordinales cercanas y premia la exactitud en el formateo de salida, al tiempo que impone una penalización de referencia (reference penalty) para prevenir desviaciones en la distribución. Este empleo del aprendizaje por refuerzo para corregir sesgos otorga a Clef la fiabilidad necesaria para asumir tareas corporativas como el triaje automatizado de incidencias.
Un flujo de fine-tuning integrado para retener el tráfico en el edge
Liberar los pesos bajo licencia abierta es solo la punta del iceberg. El verdadero objetivo estratégico de Cloudflare reside en el servicio complementario de fine-tuning presentado en paralelo. Los clientes empresariales pueden capturar su tráfico de producción directamente mediante Cloudflare AI Gateway. Esos datos reales se canalizan hacia entornos aislados de Containers para entrenar adaptadores personalizados de Clef. Una vez ajustado el modelo, se despliega de inmediato en la red perimetral de Workers AI a través del servicio BYO Model (Bring Your Own Model).
Los equipos internos de la compañía ya han validado este flujo en producción. El departamento de Trust & Safety lo utiliza para clasificar denuncias de usuarios, el equipo de soporte lo emplea para distribuir tickets entrantes y la división de mitigación de bots lo aprovecha para distinguir peticiones anómalas en tiempo real.
Al integrar el entorno de fine-tuning, la captura de datos y la inferencia dentro de su propia infraestructura, el proveedor cloud logra una retención integral del tráfico. Las empresas ya no necesitan transferir datos críticos hacia APIs de terceros.
La elección de Qwen confirma la madurez del ecosistema de código abierto, mientras que Clef marca un paso ineludible en la miniaturización y especialización de la IA. Cuando modelos de 27B y 9B renuncian a la generación de texto, adquieren visión nativa y se integran estrechamente en los flujos perimetrales, los clasificadores verticales empiezan a comer terreno a los modelos generalistas. Los desarrolladores dejan de pagar por pasos de inferencia superfluos y la computación se factura, en última instancia, por la probabilidad exacta de cada decisión.
Enlaces de referencia:
- Cloudflare Blog
- Página del modelo en Hugging Face