Le 1er octobre 2026, Cloudflare a officialisé la publication de deux modèles de décision multimodaux open source baptisés Clef et Clef-flash. Plutôt que de s’appuyer sur Llama ou Mistral comme socles, l’entreprise s’est directement associée aux modèles Qwen3.8-27B et Qwen3.5-9B d’Alibaba Tongyi pour un entraînement conjoint et optimisé. Un géant du cloud, réputé pour son infrastructure CDN et son informatique en périphérie (edge computing), descend ainsi dans l’arène pour entraîner ses propres classificateurs décisionnels.
Jusqu’à présent, les entreprises avaient pris l’habitude de déléguer leurs arbitrages opérationnels à de gigantesques modèles de langage hébergés dans le cloud. Or, chaque modération de contenu ou filtrage de trafic suspect entraînait de lourdes latences jusqu’au premier jeton généré (TTFT). Mobiliser un modèle généraliste de plusieurs centaines de milliards de paramètres pour trancher une alternative binaire relève d’une hérésie économique. La riposte de Cloudflare est limpide : installer un moteur de décision dédié directement au plus près de l’utilisateur, à la frontière du réseau.
Encodeur visuel natif : l’analyse d’image directement intégrée à la décision
Avant l’avènement de Clef, le modèle Jev conçu par TypeSafe faisait office d’étalon pour les modèles de décision ouverts. Toutefois, Jev se cantonnait strictement à la classification de texte, bridé par une fenêtre contextuelle de 32k jetons. Face à des requêtes de vérification contenant des captures d’écran ou des pièces justificatives, les développeurs devaient greffer des modules OCR externes. Les données visuelles devaient alors être laborieusement transcrites en texte avant d’être soumises au modèle.
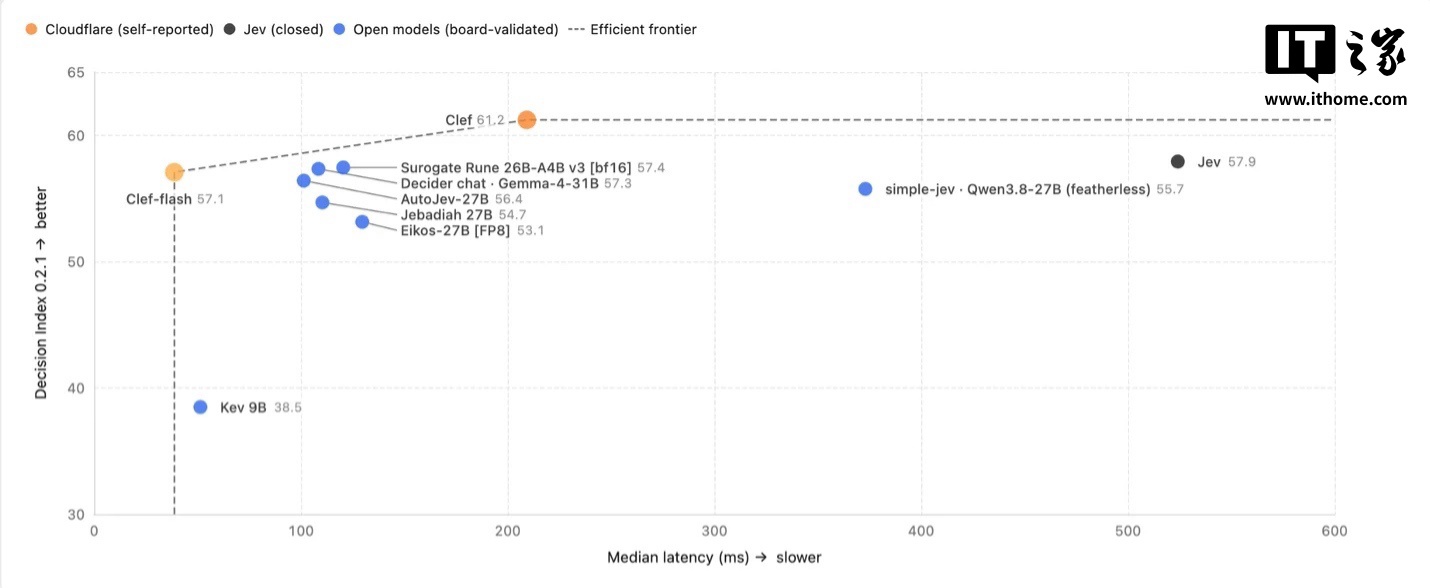 Figure : Logique d’exécution du modèle Clef. Source : Cloudflare Blog
Clef embarque en revanche nativement un encodeur visuel et hisse la limite d’entrée à 64k jetons. Capable d’interpréter sans détour les flux d’images, le modèle fait l’économie des latences et des pertes d’informations inhérentes aux conversions textuelles intermédiaires. Les équipes d’ingénierie peuvent désormais injecter des données d’état et des journaux système bien plus denses dans cette fenêtre élargie. La chaîne reliant la perception visuelle à la prise de décision est ainsi physiquement bouclée à la périphérie : la compréhension d’images n’est plus l’apanage exclusif des LLM monolithiques.
Renoncer à la génération de texte pour maximiser la précision de calibration
Pour métamorphoser Qwen en un classificateur à haute fréquence d’exécution, les ingénieurs de Cloudflare ont consenti des arbitrages architecturaux radicaux. Les couches centrales de Qwen3.8-27B et Qwen3.5-9B ont été gelées, l’ajustement ne reposant que sur l’adjonction d’adaptateurs bas rang (LoRA) de rang 256. En couplant la perte de Brier (Brier score loss) pour affiner la calibration des probabilités avec une entropie croisée adoucie par lissage des étiquettes (label smoothing), ils ont verrouillé toute velléité de génération textuelle chez Clef.
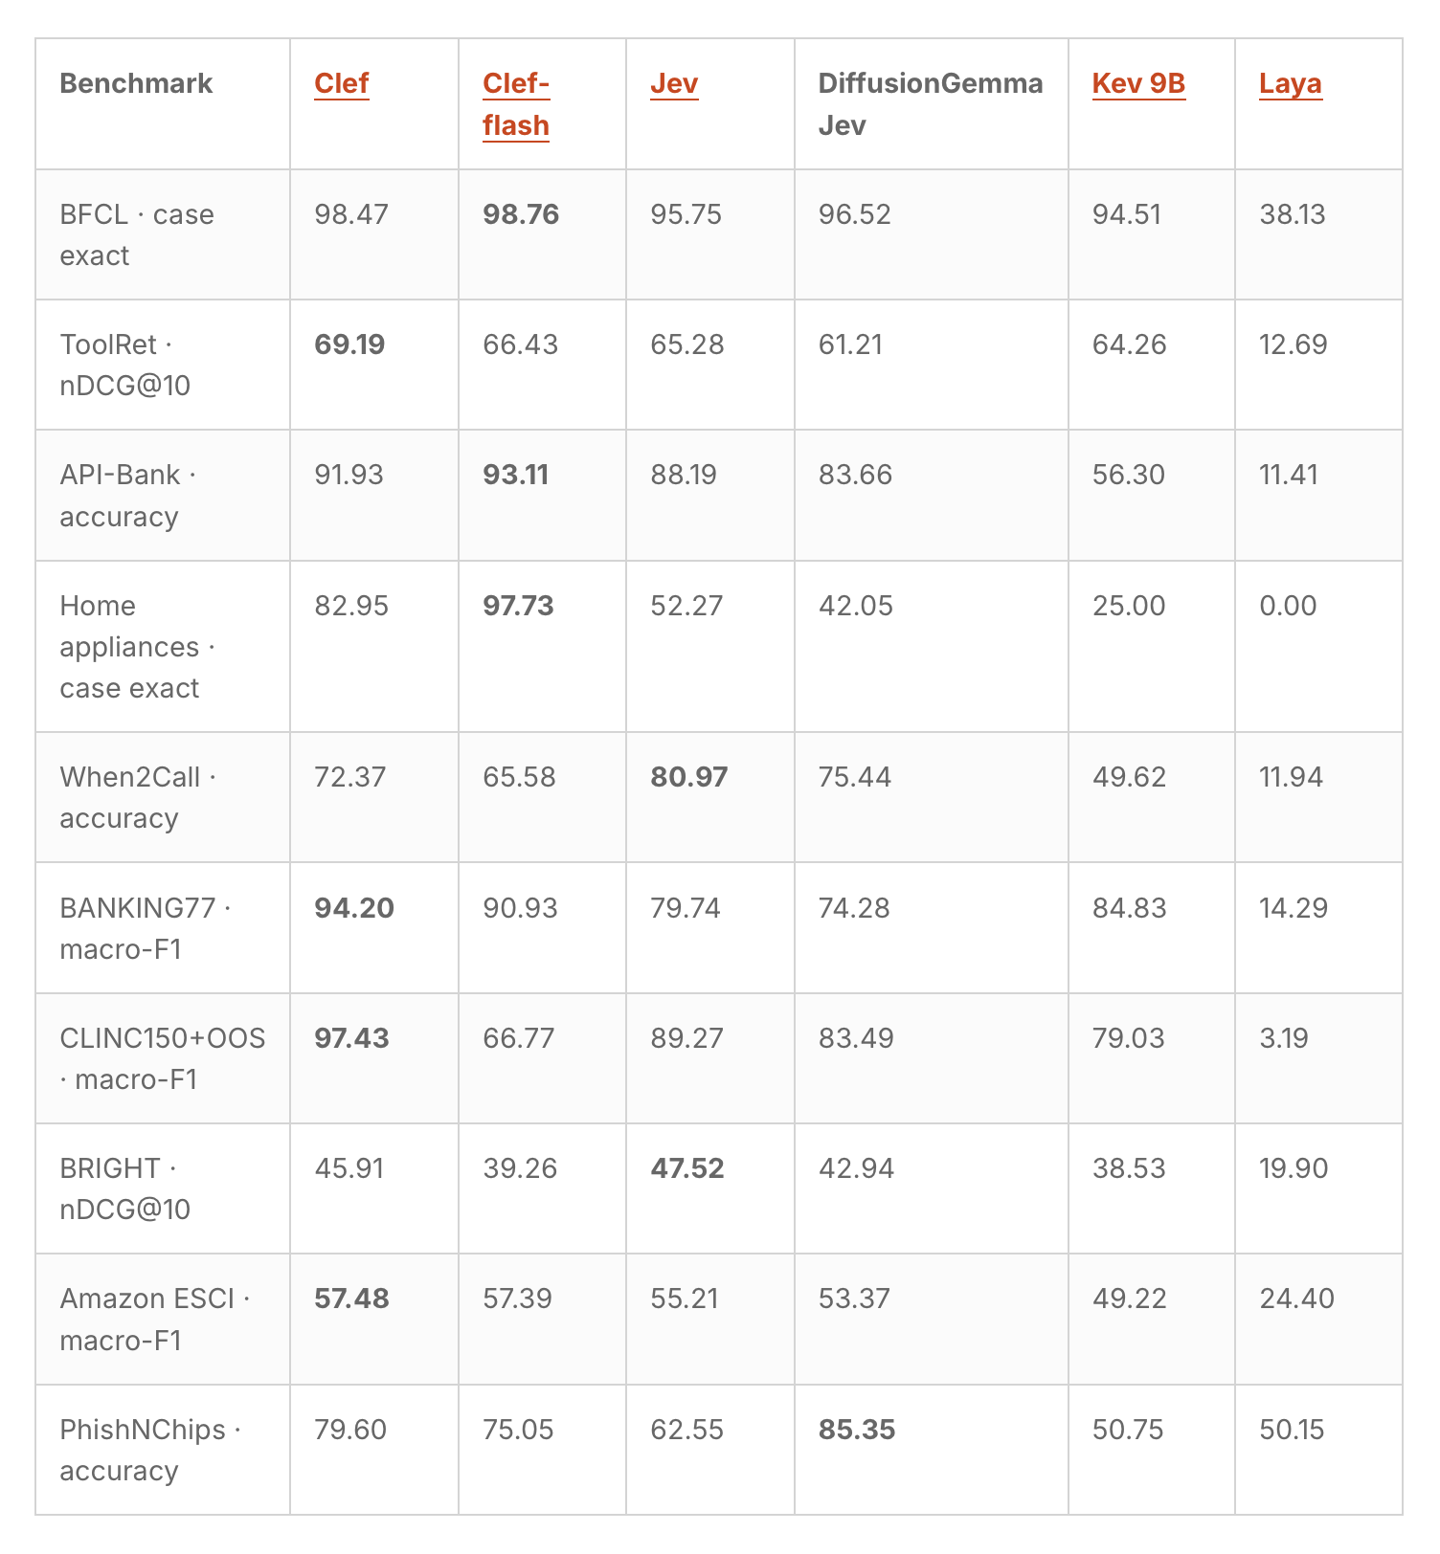 Figure : Performances de Clef face aux modèles comparables comme Jev et Kev. Source : Cloudflare Blog
En phase d’inférence, le modèle ne formule aucun discours explicatif ni prose bavarde. Il est rigoureusement contraint d’émettre des distributions de probabilité calibrées selon un schéma typé préétabli. Cette contrainte physique imposée au format de sortie a provoqué une progression fulgurante de la précision décisionnelle.
Sur le banc d’essai Jev Decision Index (version 0.2.1), Clef s’adjuge un score de 98,47 points tandis que Clef-flash culmine à 98,76 points. Ces deux résultats surclassent nettement les 95,75 points de Jev et relèguent Kev 9B au second plan. La totalité de la puissance de calcul se concentre sur l’unique mission de vérification et de classification. Renoncer au bavardage pour décrocher des temps de réponse de l’ordre de la milliseconde répond précisément aux impératifs d’ingénierie des flux opérationnels à très fort volume.
Données synthétiques : consolider la robustesse aux limites du réseau
Ce mécanisme de haute précision s’appuie sur un jeu de données synthétiques élaboré en interne par Cloudflare. Au cours de l’entraînement, les développeurs ont délibérément perturbé l’ordonnancement des champs, les prompts système ainsi que la structure des schémas. Cette démarche a conféré au modèle une grande robustesse face aux requêtes chaotiques et hétérogènes caractéristiques de la périphérie du réseau.
L’équipe a en outre intégré l’apprentissage par renforcement à partir de distributions catégorielles (RLCD) comme fonction objective secondaire. Cette méthode alloue des scores partiels aux classes ordinales contiguës tout en récompensant une conformité typologique stricte. Parallèlement, une pénalité de référence (reference penalty) prévient toute dérive distributionnelle. Corriger les biais décisionnels par renforcement apporte à Clef la fiabilité requise pour assumer des missions d’entreprise critiques telles que le routage automatisé des tickets de support.
Un écosystème de fine-tuning intégré pour capturer le trafic edge
La mise à disposition des poids ouverts n’est que la première pièce du dispositif. La véritable ambition de Cloudflare réside dans sa plateforme de fine-tuning déployée simultanément. Les clients professionnels peuvent recueillir leurs flux de production directement via Cloudflare AI Gateway. Ces métriques réelles sont alors dirigées vers des environnements isolés Containers pour entraîner des déclinaisons personnalisées de Clef. Une fois affiné, le modèle se déploie instantanément sur l’infrastructure mondiale Workers AI par le biais du service BYO Model (Bring Your Own Model).
Les équipes internes de Cloudflare ont d’ores et déjà validé ce workflow à grande échelle. L’équipe Trust & Safety l’utilise pour filtrer les signalements, le support technique s’y fie pour aiguiller les requêtes d’assistance, et la division de lutte contre les bots s’en sert pour caractériser en temps réel les flux réseau malveillants.
En réunissant le fine-tuning, la captation des données et l’inférence sous son propre toit, le fournisseur de cloud parachève la rétention de son trafic. Les organisations n’ont plus à expédier leurs données sensibles vers des API tierces distantes.
Le choix porté sur Qwen atteste de la maturité des modèles ouverts, tandis que Clef illustre la tendance inéluctable vers la spécialisation et le rétrécissement ciblé des architectures d’IA. Lorsque des modèles de 27B et 9B sont délestés de la génération de texte, dotés d’une vision native et intimement articulés aux flux de travail edge, les classificateurs verticaux grignotent les prérogatives des géants généralistes. Les développeurs n’ont plus à payer pour des étapes d’inférence superflues : la facture matérielle se concentre désormais sur l’évaluation exacte de la probabilité d’une décision.
Liens de référence :
- Cloudflare Blog
- Page du modèle sur Hugging Face