2026年10月1日、Cloudflareは2つのオープンソース・マルチモーダル決定モデル「Clef」と「Clef-flash」を正式にリリースした。土台となるベースモデルにはLlamaやMistralではなく、Alibaba(アリババ)のQwen3.8-27BおよびQwen3.5-9Bを採用し、共同トレーニングと最適化を施している。エッジコンピューティングとCDNを主力とするクラウドベンダーが、自ら特化型の意思決定分類器の学習に乗り出した形だ。
従来、企業はビジネスロジックの判断をクラウド上の大規模言語モデル(LLM)に丸投げするのが一般的だった。しかし、コンテンツモデレーションや悪意あるトラフィックのスクリーニングを実行するたび、初トークン生成までの高コストなレイテンシが発生していた。千億パラメータ級の汎用モデルに二者択一の分類タスクを担わせることは、コスト構造の観点から明らかに非効率だ。これに対し、Cloudflareが打ち出した回答は、ネットワークのエッジ側に専用の意思決定エンジンを直接配備することだった。
視覚エンコーダーで画像認識と判断を直結
Clefの登場前、オープンソースの決定モデルにおける性能の基準となっていたのは、Typesafe AIが公開した「Jev」だった。だが、Jevがサポートするのはテキスト分類のみで、コンテキストウィンドウも32kに厳格に制限されていた。スクリーンショットや文書画像を伴う判定リクエストを処理する場合、開発者は外部のOCRコンポーネントを接続せざるを得ず、視覚情報を無理やりテキスト化してからモデルに渡すというオーバーヘッドを強いられていた。
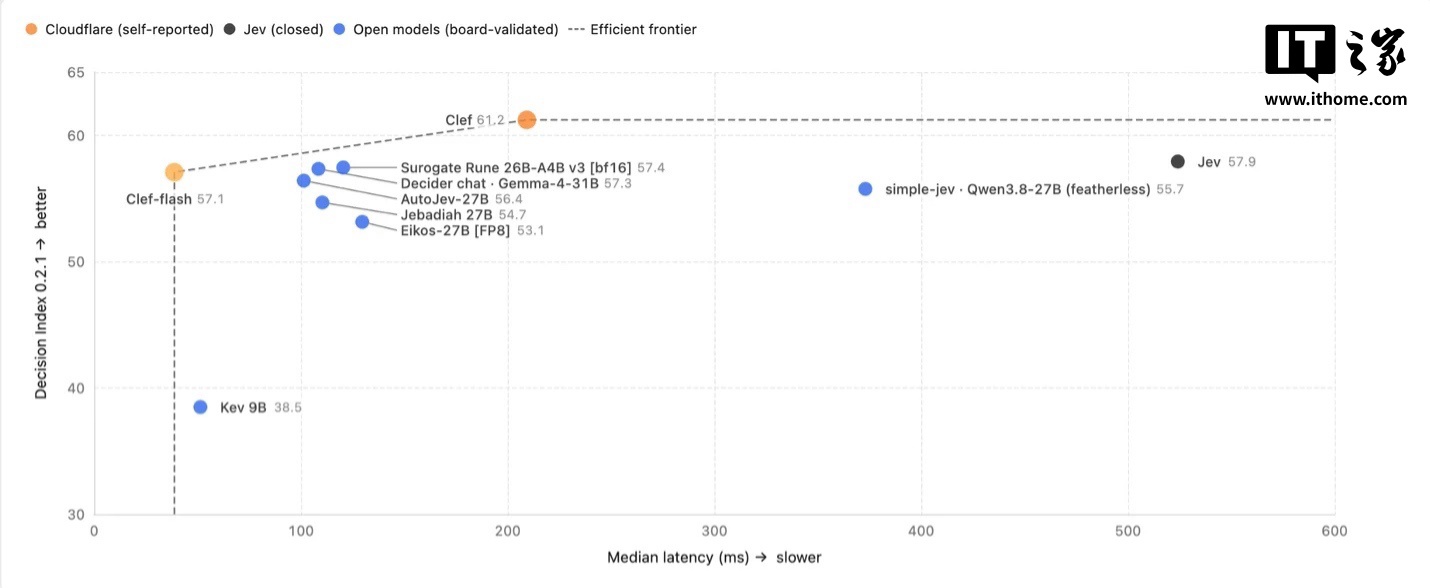 図:Clefモデルの実行ロジック概要。出典:Cloudflare Blog
対するClefは、ビジョンエンコーダーをネイティブで内蔵し、入力上限を64kトークンまで引き上げた。モデルが画像入力を直接解析できるため、テキスト変換に伴う処理遅延や情報損失が発生しない。開発者はより密度の高いシステム状態や監視データを64kのウィンドウに投入できるようになった。画像を見て判断を下す処理チェーンがエッジ側で物理的に統合され、視覚理解はもはや巨大な汎用モデルだけの特権ではなくなった。
テキスト生成を封印し、キャリブレーション精度を追求
Qwenを高頻度な分類器へと鍛え上げるため、Cloudflareの開発チームは大胆なアーキテクチャ上の取捨選択を行った。Qwen3.8-27BおよびQwen3.5-9Bのコア層を凍結し、rank-256の低ランクアダプタ(LoRA)のみを追加してファインチューニングを実施。確率キャリブレーションを精密化するブライア損失(Brier loss)とラベル平滑化を施したクロスエントロピー損失を組み合わせ、Clefのテキスト生成機能を完全に封じ込めた。
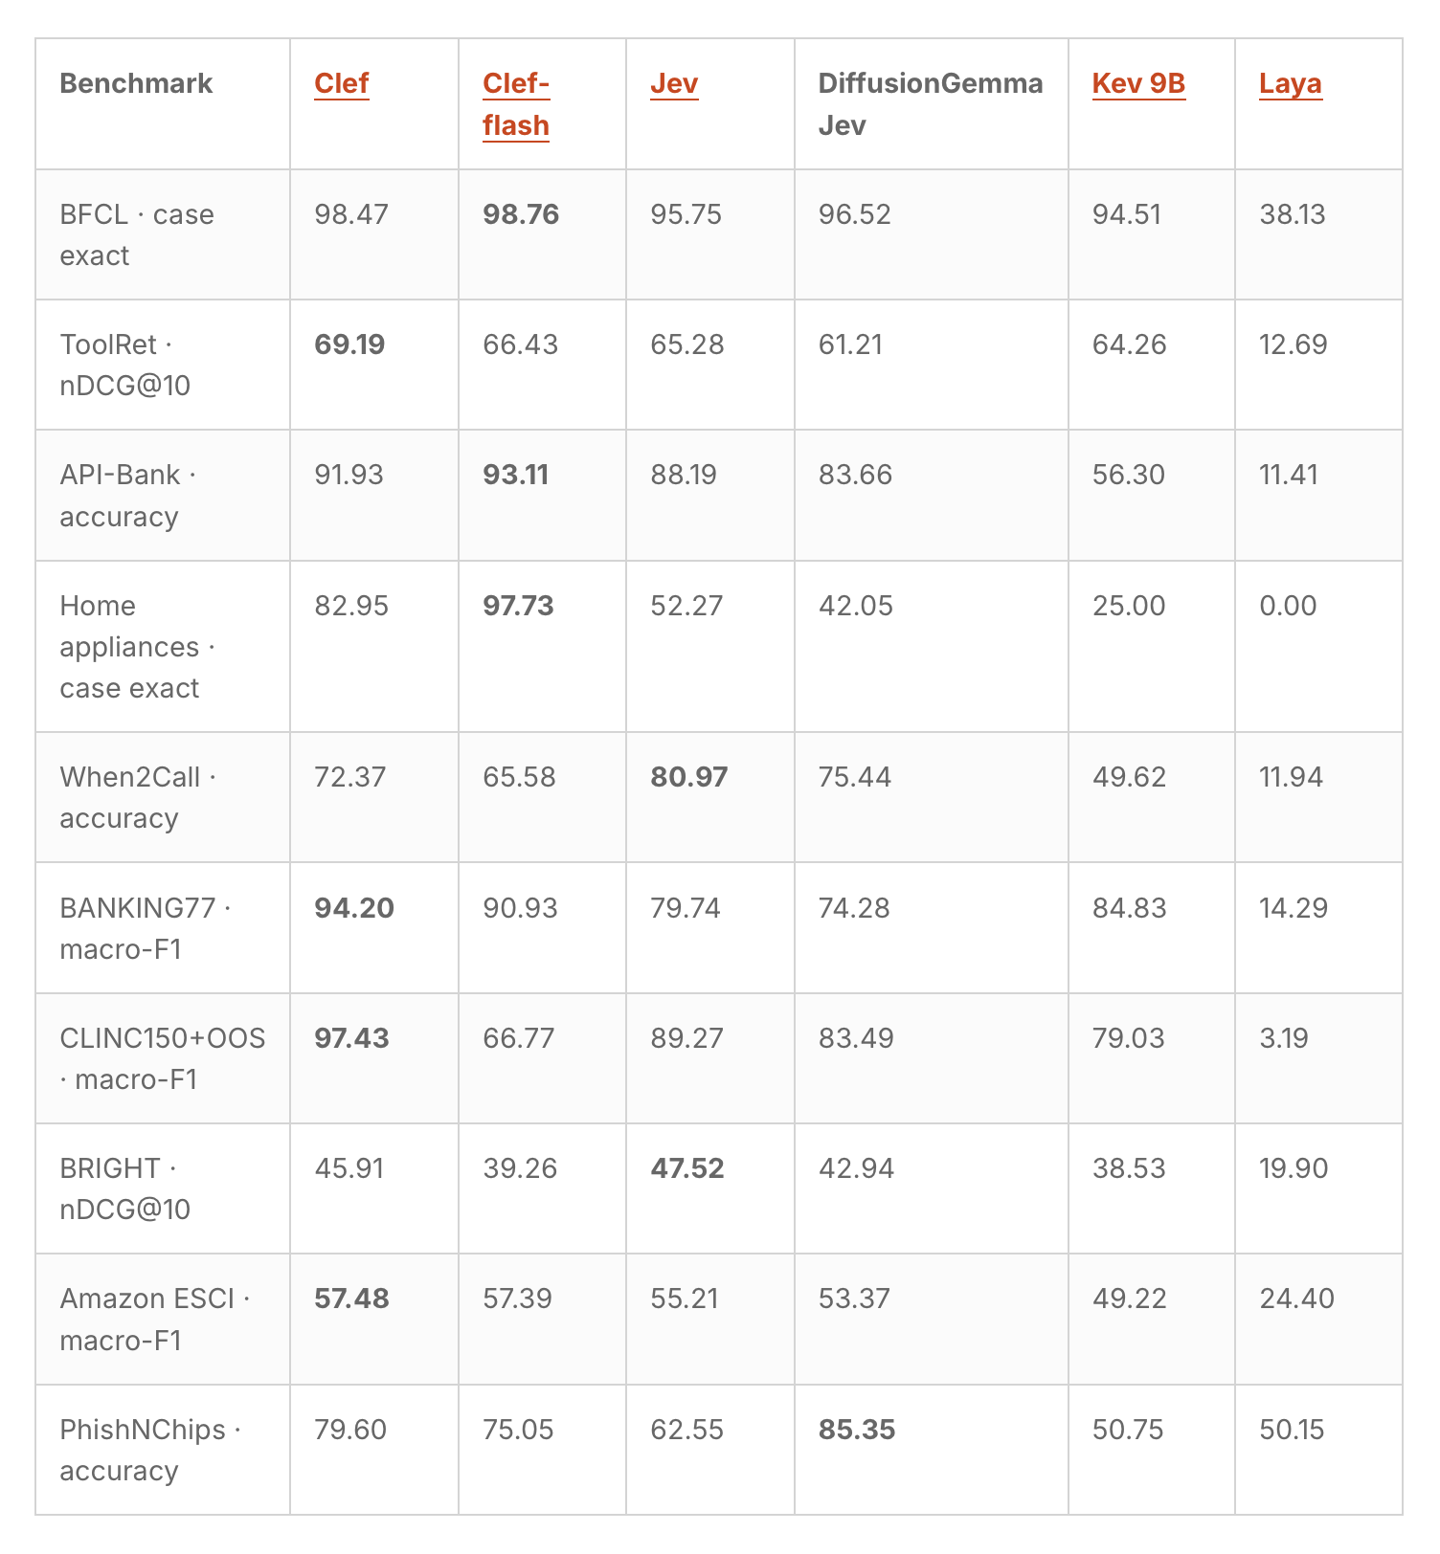 図:JevやKevなどの競合モデルとClefの各種ベンチマーク比較。出典:Cloudflare Blog
推論時、モデルは解説や対話のような自由形式のテキストを一切出力しない。事前定義されたスキーマに沿った厳密な確率分布のみを返すよう強制されている。この出力形式に対する物理的な制約が、判定精度の飛躍的な向上をもたらした。
Jev決定指数(Decision Index 0.2.1)のベンチマークにおいて、Clefは98.47ポイント、Clef-flashは98.76ポイントを記録。いずれもJevの95.75ポイントを上回り、Kev 9Bを大きく引き離した。計算資源のすべてが分類と検証という単一タスクに注ぎ込まれている。雑談を捨ててミリ秒単位の応答速度を手に入れるアプローチは、高トラフィックな本番運用の要請に的確に応えるものだ。
合成データで堅牢性のベースラインを担保
この高精度な出力メカニズムを支えているのが、Cloudflare社内で生成・投入された合成データセットだ。トレーニング時、開発チームはフィールドの並び順、システムプロンプト、スキーマ構造などを意図的に撹乱させ、ノイズを与えた。この処理により、エッジ環境に届く複雑で予期せぬリクエストに対するモデルの堅牢性が大幅に高められた。
さらにチームは、副次的な最適化目標としてRLCD(カテゴリカル分布からの強化学習)を導入した。近接する順序付き選択肢に対して部分点を与えつつ、厳密なフォーマット出力を報酬として強化する。同時に、参照ペナルティ(reference penalty)を設けて分布のドリフトを防いだ。強化学習を通じて確率の偏りを補正したことで、Clefはエンタープライズ級のチケット自動振り分けやセキュリティ判定を担う実用性を獲得した。
ファインチューニング基盤を統合し、エッジトラフィックを囲い込む
オープンソースとして重みを公開することは、あくまで最初の一手に過ぎない。Cloudflareの真の狙いは、モデルと同時に立ち上げられたファインチューニング基盤にある。エンタープライズ顧客は、Cloudflare AI Gatewayを介して自社の実トラフィックを直接収集できる。収集された本番データはサンドボックス化されたContainers環境に送られ、Clefのカスタム学習に活用される。モデルの調整が完了すれば、BYO Model(モデル持ち込み)機能を通じてWorkers AIのグローバルエッジネットワーク上に即座にデプロイ可能だ。
社内チームではすでにこのパイプラインが実戦投入されている。Trust & Safetyチームは違反報告の審査に、サポート部門は問い合わせチケットの自動ルーティングに、Bot対策部門はめまぐるしく変化するWebリクエストの識別と遮断にこれを活用している。
ファインチューニング環境、データ収集、推論解析のすべてを自社プラットフォーム内に完結させることで、クラウドベンダーとしてのトラフィック囲い込みを達成した。企業はもはやエッジデータを外部のサードパーティAPIへ転送する必要がない。
CloudflareによるQwenの採用は、オープンソースエコシステムの成熟と基盤としての実力を証明している。そしてClefそのものは、AIモデルの特化型への小型化という必然的なエンジニアリングの進化を示唆している。27Bや9Bのモデルがテキスト生成を捨て、画像認識の目を手に入れ、クラウドのエッジワークフローと密接に結びついたとき、汎用巨大モデルの領域は垂直統合された分類器によって侵食され始める。開発者は無駄な推論コストを支払う必要がなくなり、計算リソースは真に必要な意思決定の確率に対してのみ消費されるようになるのだ。
参考リンク:
- Cloudflare Blog
- Hugging Faceモデルハブ