2026년 10월 1일, 클라우드플레어(Cloudflare)가 오픈소스 멀티모달 결정 모델 ‘Clef’와 ‘Clef-flash’를 공식 출시했다. 이들은 라마(Llama)나 미스트랄(Mistral) 대신 알리바바 퉁이의 Qwen3.8-27B 및 Qwen3.5-9B를 기본 뼈대로 삼아 공동 학습과 최적화를 진행했다. 에지 컴퓨팅과 콘텐츠 전송 네트워크(CDN)를 핵심 사업으로 삼아온 클라우드 기업이 전면에 나서 직접 의사결정 분류기 훈련에 뛰어든 것이다.
그동안 기업들은 대부분의 비즈니스 판단 작업을 클라우드의 대규모 언어 모델(LLM)에 의존해 왔다. 그러나 콘텐츠 검수나 악성 트래픽 필터링을 수행할 때마다 첫 토큰 생성까지 소요되는 지연 시간(TTFT)의 비용을 감당해야 했다. 단순한 이진 분류 작업에 수천억 개 매개변수를 지닌 범용 모델을 호출하는 것은 비용 구조상 명백한 낭비였다. 클라우드플레어가 내놓은 해결책은 네트워크 에지 단에 전용 결정 엔진을 직접 배치하는 방식이다.
비전 인코더로 이미지 인식과 판단을 직결하다
Clef가 등장하기 전까지 오픈소스 결정 모델의 성능 척도는 타입세이프(TypeSafe)가 공개한 ‘Jev’였다. 하지만 Jev는 순수 텍스트 분류만 지원했으며, 컨텍스트 윈도우도 32k로 엄격히 제한되어 있었다. 스크린샷이나 문서 이미지가 포함된 검수 요청이 들어오면 외부 OCR 모듈을 거쳐야만 했다. 시각 데이터를 텍스트로 억지로 변환한 뒤에야 모델에 입력할 수 있었던 셈이다.
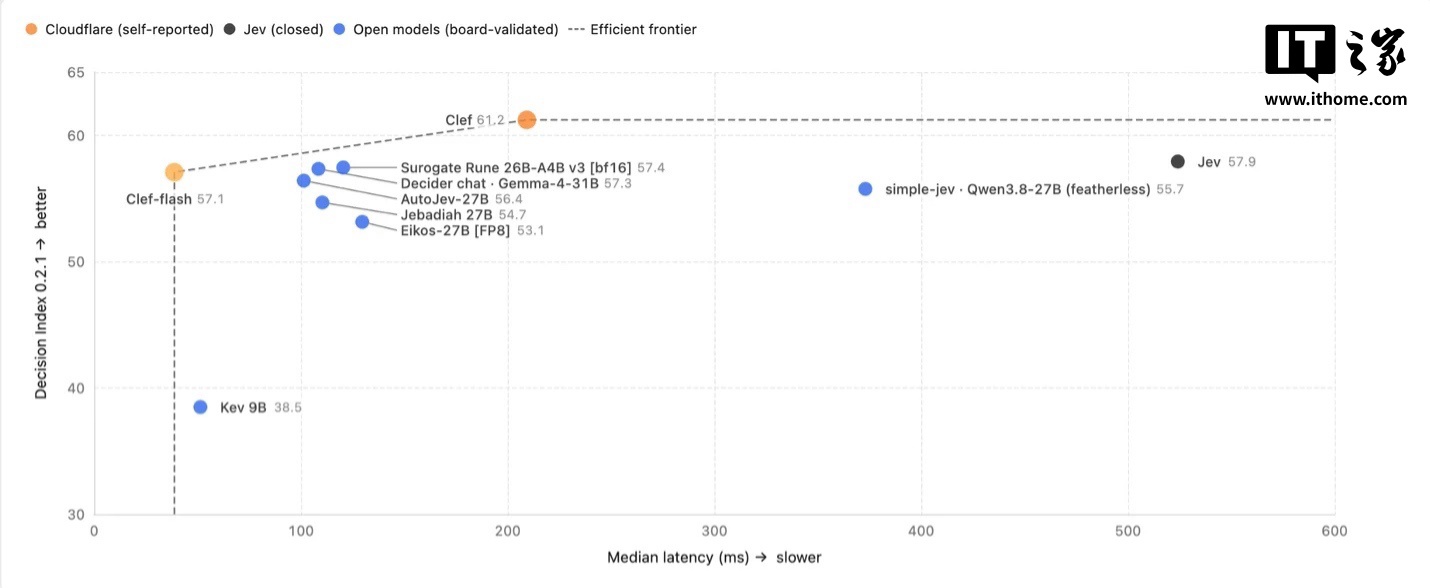 그림: Clef 모델의 실행 로직 개요. 출처: Cloudflare Blog
반면 Clef는 자체 비전 인코더를 기본 탑재해 입력 한도를 64k 토큰까지 대폭 확장했다. 모델이 이미지 입력을 직접 해석할 수 있어 중간 단계의 텍스트 변환에 따른 손실과 지연이 완전히 사라졌다. 이제 개발자들은 훨씬 더 방대한 시스템 상태 정보와 로그 데이터를 64k 윈도우에 집어넣을 수 있게 되었다. 이미지를 보고 결정을 내리는 실행 경로가 에지 단에서 물리적으로 이어지면서, 시각적 이해는 더 이상 거대 범용 모델만의 전유물이 아니게 되었다.
텍스트 생성을 차단하고 확률 보정 정확도를 극대화하다
Qwen을 초고속 고빈도 분류기로 훈련시키기 위해 클라우드플레어 개발팀은 과감한 아키텍처 설계를 선택했다. Qwen3.8-27B와 Qwen3.5-9B의 핵심 계층을 동결하고, rank-256 로라(LoRA) 어댑터만을 추가해 미세 조정을 수행했다. 확률 보정을 정밀화하는 브라이어 손실(Brier loss)과 라벨 평활화(label smoothing)를 결합한 교차 엔트로피 손실을 적용해 Clef의 텍스트 생성 기능을 완전히 차단했다.
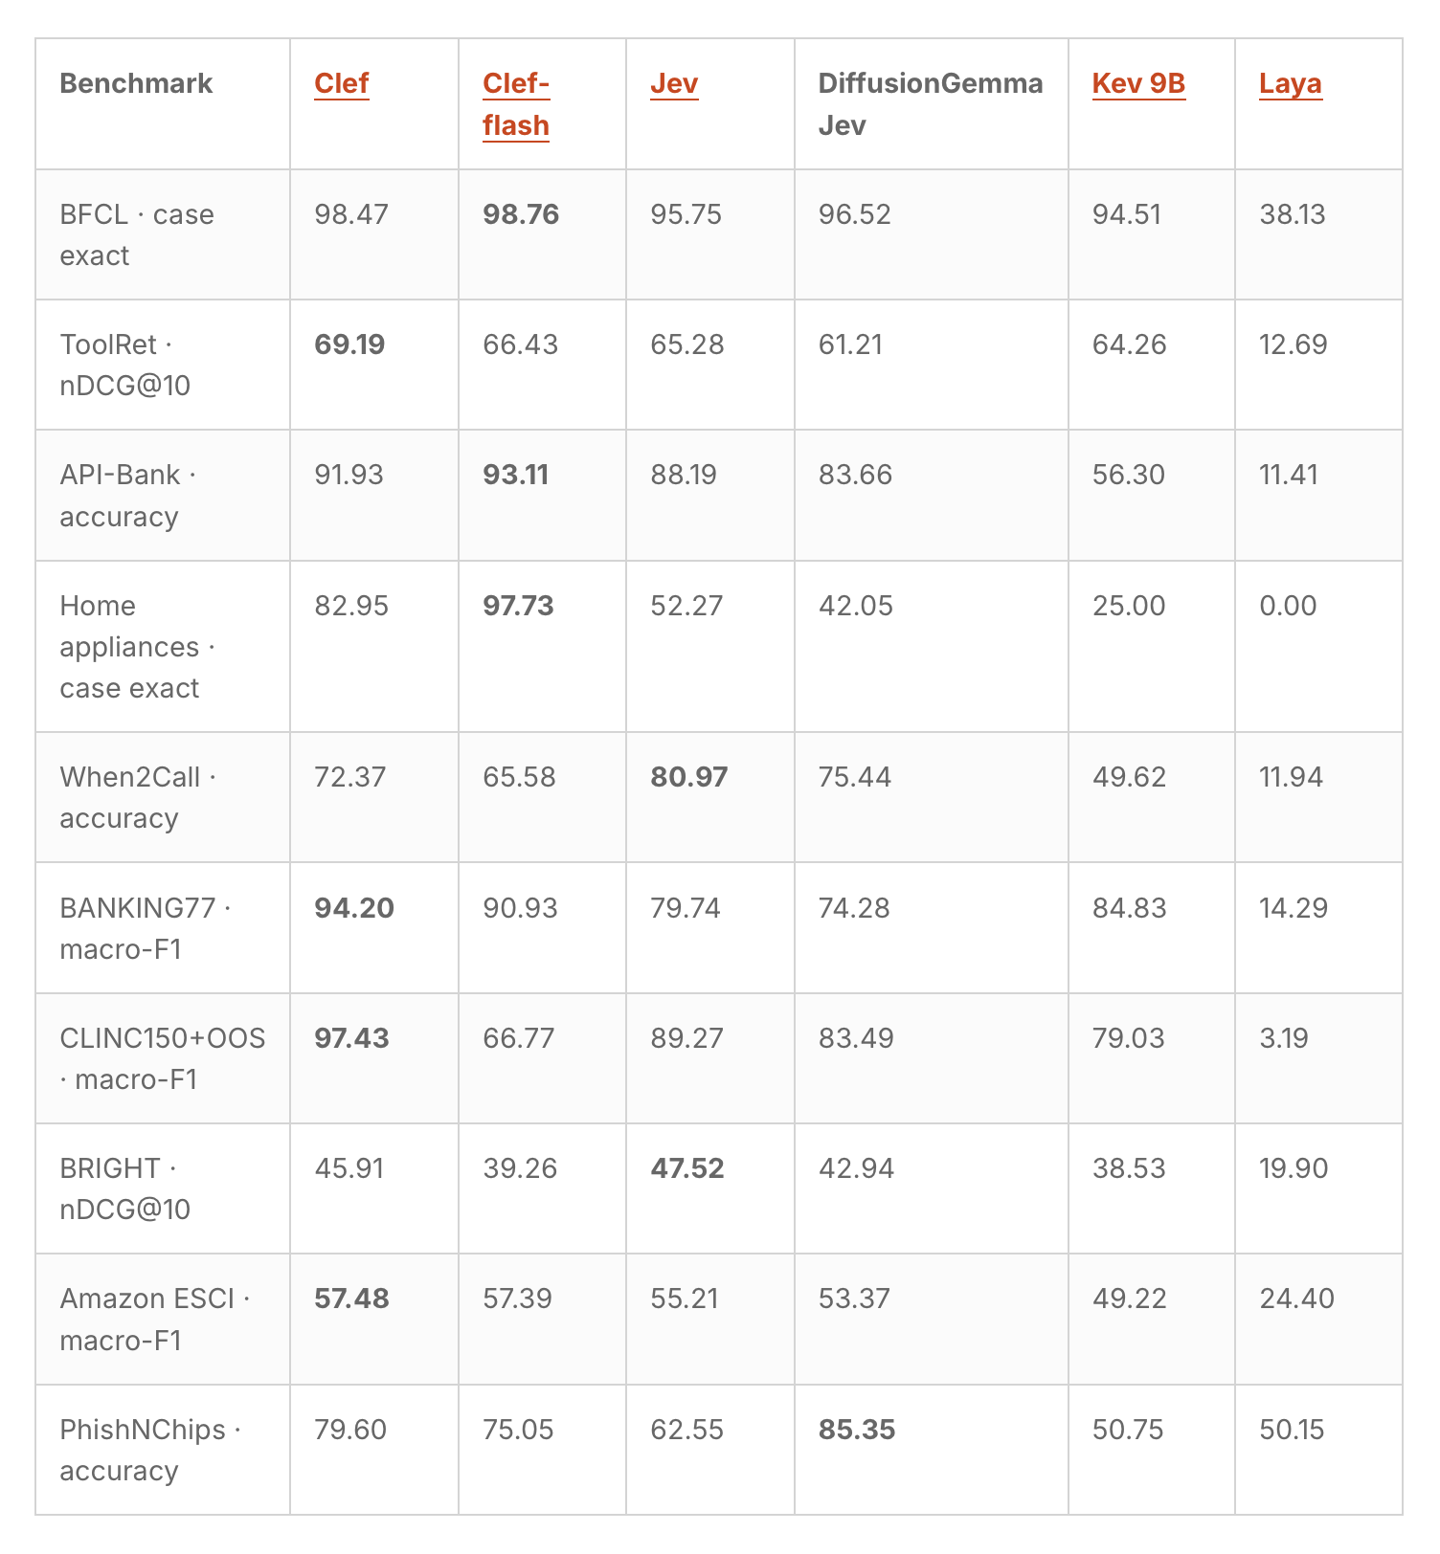 그림: Jev 및 Kev 등 동급 모델과의 Clef 벤치마크 비교. 출처: Cloudflare Blog
추론 과정에서 모델은 설명이나 대화 형식의 텍스트를 일절 출력하지 않는다. 정해진 스키마(Schema)에 맞춰 정밀하게 보정된 확률 분포만을 반환하도록 강제된다. 이러한 출력 형식에 대한 물리적 제약은 결정 정확도의 비약적인 상승으로 이어졌다.
Jev 결정 지수(Decision Index 0.2.1) 벤치마크 평가에서 Clef는 98.47점, Clef-flash는 98.76점을 기록했다. 두 점수 모두 Jev의 95.75점을 웃돌았으며, Kev 9B를 큰 격차로 따돌렸다. 모든 연산 자원이 분류와 검증이라는 단 하나의 작업에 집중된 결과다. 잡담 기능을 과감히 버리고 수 밀리초 단위의 초저지연 응답 속도를 확보한 것은 대규모 트래픽을 다루는 실무 환경의 요구를 정확히 관통했다.
합성 데이터로 견고성의 마지노선을 검증하다
이 같은 고정밀 출력 메커니즘을 뒷받침하는 핵심은 클라우드플레어가 내부에서 생성해 주입한 합성 데이터셋이다. 학습 과정에서 개발팀은 필드 순서, 시스템 프롬프트, 스키마 구조를 의도적으로 뒤섞고 왜곡했다. 이러한 데이터 변형 처리는 복잡하고 비정형적인 에지 요청에 직면했을 때 모델이 견고하게 대응할 수 있도록 기초 체력을 길러주었다.
개발팀은 또한 보조 최적화 목표로 RLCD(범주형 분포 강화학습)를 도입했다. 근접한 순서형 선택지에 부분 점수를 부여하면서 정확한 포맷 출력을 보상하도록 설계했다. 동시에 참조 페널티(reference penalty)를 적용해 분포의 편향을 방지했다. 강화학습을 통해 결정 편향을 교정한 덕분에 Clef는 엔터프라이즈급 티켓 자동 분류와 실시간 보안 정책 집행 작업을 무리 없이 소화할 수 있게 되었다.
파인튜닝 파이프라인을 번들링해 에지 트래픽을 선점하다
오픈소스 가중치 공개는 시작에 불과하다. 클라우드플레어의 진짜 목적은 모델과 함께 출시된 파인튜닝 서비스에 있다. 기업 고객은 클라우드플레어 AI 게이트웨이(AI Gateway)를 통해 실제 비즈니스 트래픽을 직접 수집할 수 있다. 이렇게 모인 실제 운영 데이터는 격리된 컨테이너(Containers) 샌드박스로 전달되어 Clef 맞춤형 학습에 사용된다. 모델 미세 조정이 완료되면 BYO Model(자체 모델 반입) 기능을 통해 전 세계 워커스 AI(Workers AI) 에지 네트워크에 즉시 배포된다.
내부 팀들은 이미 이 파이프라인을 성공적으로 운영해 왔다. 신뢰 및 안전(Trust & Safety) 팀은 신고 내역 평가에, 기술 지원 부서는 접수된 고객 티켓의 자동 라우팅에, 봇 방어 부서는 시시각각 변화하는 웹 요청 분석에 이 모델을 활용하고 있다.
파인튜닝 환경, 데이터 수집, 추론 및 분석을 모두 자사 플랫폼 울타리 안에 묶어둠으로써, 클라우드 기업은 네트워크 트래픽을 완전히 내재화했다. 기업 고객은 더 이상 민감한 에지 데이터를 원격의 외부 서드파티 API로 전송할 필요가 없다.
클라우드플레어가 Qwen을 선택한 것은 오픈소스 모델 생태계의 뛰어난 역량을 방증하며, Clef 자체는 AI 모델의 수직적 경량화라는 필연적인 엔지니어링 진화를 보여준다. 27B와 9B 모델이 텍스트 생성 기능을 내려놓고 시각 인식을 장착한 채 클라우드 파인튜닝 워크플로와 결합할 때, 범용 대규모 모델의 영역은 특화 분류기들에 의해 재편되기 시작한다. 개발자는 더 이상 불필요한 추론 비용을 지불할 필요가 없으며, 연산 자원은 오직 단 하나의 정확한 의사결정 확률을 산출하는 데에만 쓰이게 된다.
참고 링크:
- Cloudflare Blog
- Hugging Face 모델 허브