Vom Text-Prompt zu 0-bis-1000-Koordinaten
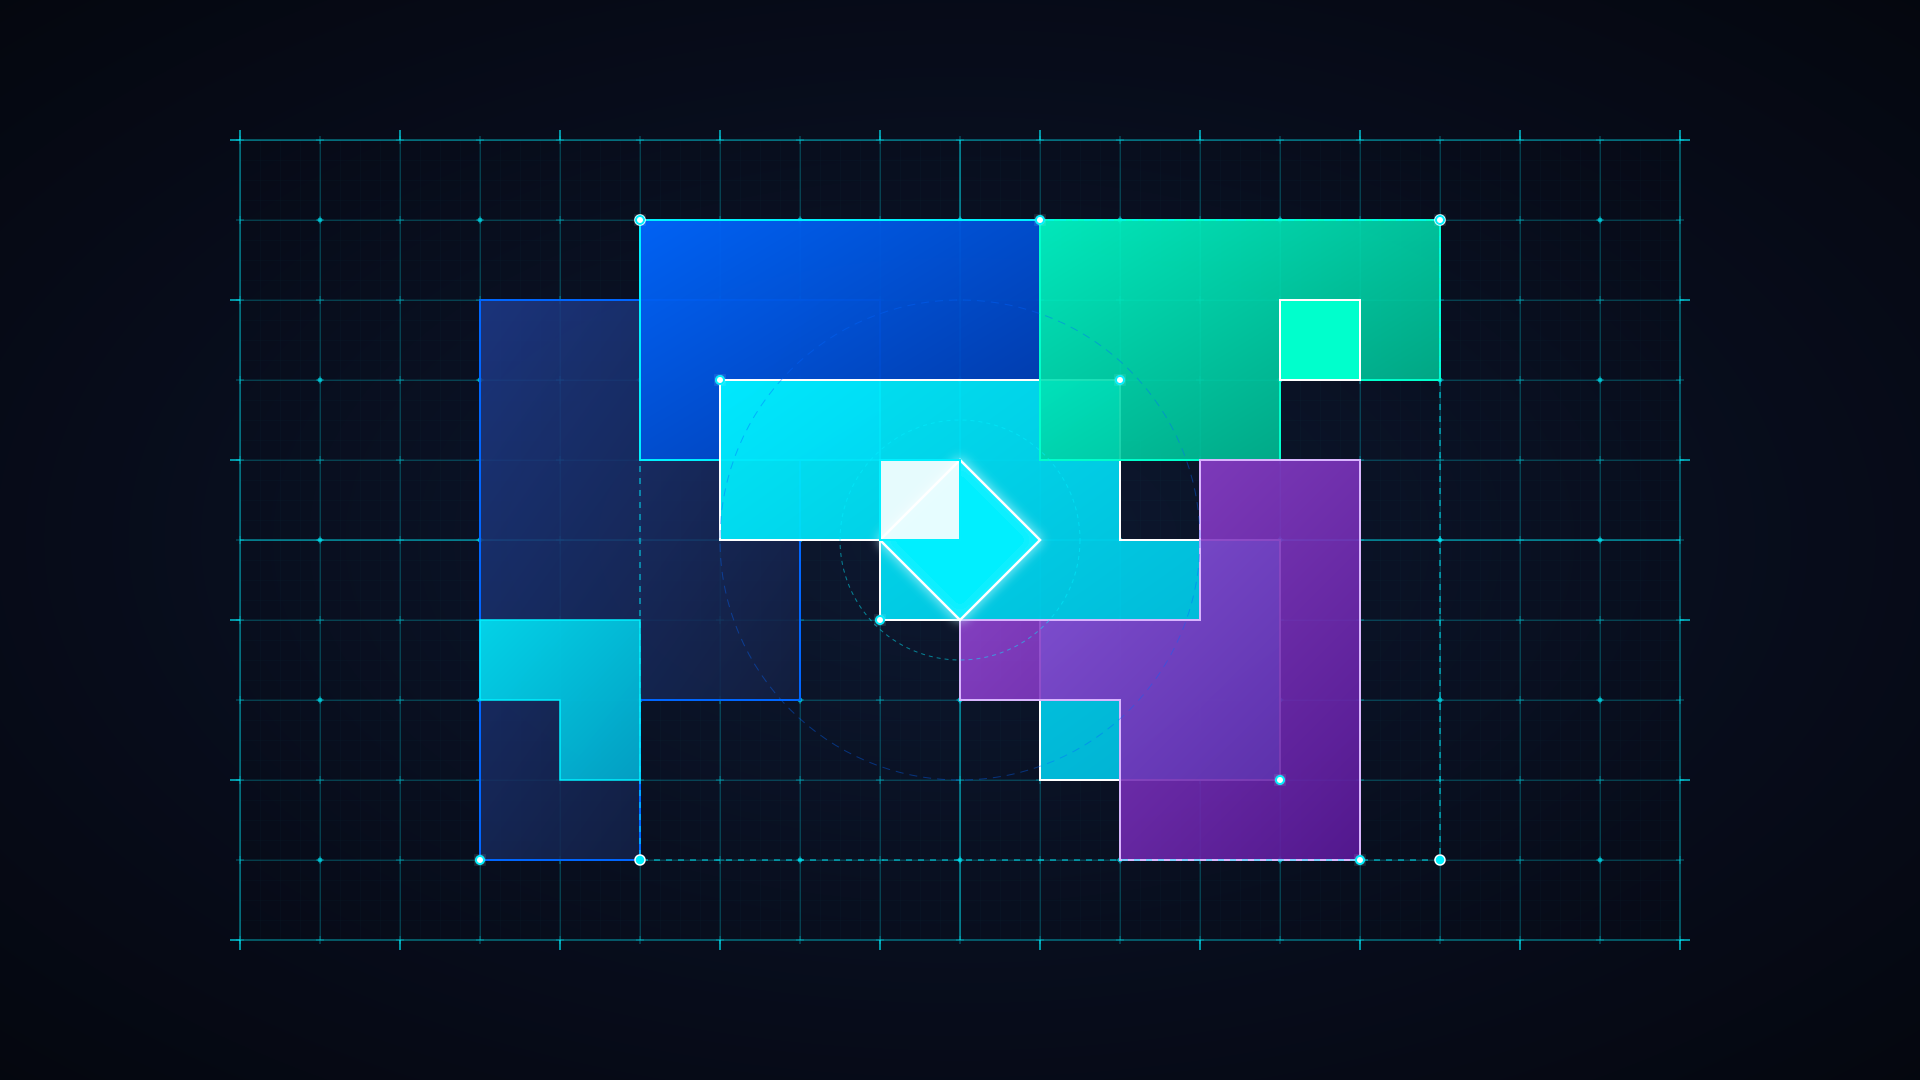
Die KI-gestützte Bildgenerierung litt lange unter den Unschärfen rein sprachlicher Beschreibungen; Gestalter mussten Prompts oft endlos variieren und auf glückliche Zufallstreffer hoffen. FLUX 3 Image macht die Eingabe über Bounding-Boxes nun zum Standard-Interaktionsmodell. Nutzer bestimmen die Position jedes Bildelements auf einem normalisierten Koordinatengitter von 0 bis 1000, und das Modell rendert die Objekte strikt innerhalb dieser definierten Grenzen. Der Übergang von unberechenbarem Prompt-Gacha hin zu deterministischer Rastersteuerung überwindet die entscheidende Hürde für professionelle Design-Workflows.
Herkömmliche Prompts scheitern regelmäßig daran, komplexe räumliche Beziehungen präzise einzufordern – etwa ein bestimmtes verdeckendes Objekt exakt im linken Drittel einer Person zu platzieren. Im 0-bis-1000-Koordinatennetz fixieren oberer linker und unterer rechter Eckpunkt den physikalischen Raum eines Elements unverrückbar, während der Begleittext darauf reduziert wird, die visuellen Attribute innerhalb dieser Zone zu verfeinern. Diese absolute Kontrolle verwandelt das generative Modell von einem launischen Künstler in ein diszipliniertes Bauteam: Gestalter müssen der KI nicht mehr langwierig Bildkompositionen erklären, sondern liefern lediglich eindeutige Blaupausen.
Die Bindung an Bounding-Boxes verlangt vom Modell, bereits während der Trainingsphase eine strikte Kopplung zwischen Raumgeometrie und Semantik zu verinnerlichen und Merkmale exakt auf das zugewiesene Areal zu konzentrieren. Das gefürchtete Ineinanderfließen von Attributen und Ausfransen über Objektgrenzen hinweg wird durch die harte Geometrie unterbunden. Der Preis für diese Verlässlichkeit sind allerdings exorbitante Annotationskosten: Nur riesige Bildkorpora mit hochpräzisen Begrenzungsrahmen ermöglichen einem Diffusionsmodell diese räumliche Disziplin.
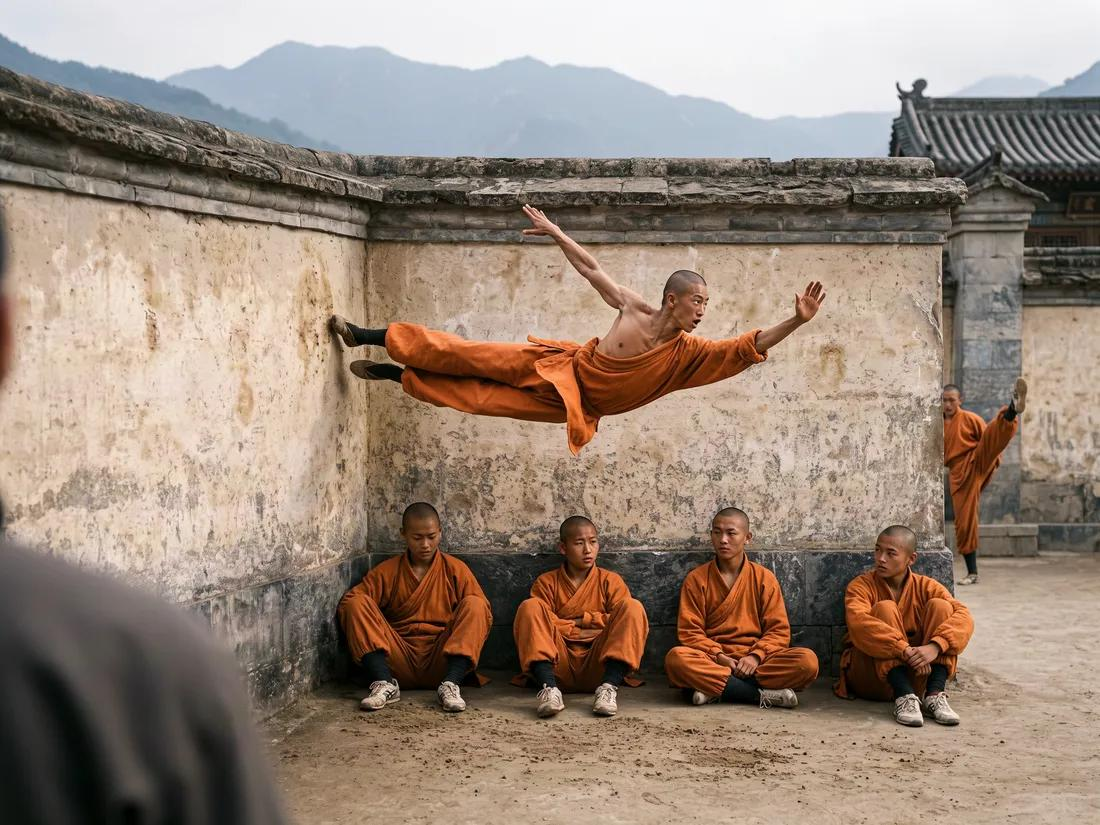 Abb.: Festlegung der räumlichen Lage von Personen und Hintergrundobjekten mittels Bounding-Boxes. Quelle: Black Forest Labs
10 Referenzbilder und iterative Bearbeitung senken Korrekturkosten
Ein einzelnes Referenzbild reicht für anspruchsvolle kommerzielle Anforderungen selten aus, da Charakterzüge, Umgebungslicht und Farbpaletten oft aus völlig unterschiedlichen Vorlagen bezogen werden müssen. FLUX 3 Image erlaubt die gleichzeitige Eingabe von bis zu 10 Referenzbildern, um Komposition und Hauptmerkmale des Zielbildes gemeinsam zu steuern. Dieser Multi-Image-Verbund durchbricht die Grenzen isolierter Merkmalsextraktion und macht die Bildsynthese für E-Commerce-Banner und UI-Grafiken im industriellen Maßstab praxistauglich.
Die größten Kosten im kommerziellen Design entstehen durch unzählige Korrekturschleifen an spezifischen Bilddetails. Laut Hersteller unterstützt das Modell mehrstufige, präzise Bearbeitungen, ohne unbeteiligte Pixel anzutasten – und beendet damit die berüchtigten Kollateralschäden herkömmlicher Inpainting-Verfahren. Lokale Retuschen führen nicht mehr zum Zusammenbruch der Gesamtkomposition. Die Anpassung eines vom Kunden beanstandeten Bildwinkels wird zu einem planbaren, kostengünstigen Arbeitsschritt, der sich so verlässlich wie eine Photoshop-Ebene handhaben lässt.
Das Zusammenspiel aus bis zu 10 Referenzen und chirurgisch präzisen Korrekturen schafft eine verlässliche Iterationspipeline. Die Bildeigenschaften werden in unabhängige Variablen zerlegt: Eine Änderung an der Kleidung verändert nicht den Lichteinfall im Hintergrund, und das Austauschen eines Produkts lässt die übergeordneten Proportionen unberührt. Erst diese operative Determiniertheit schafft die Voraussetzung dafür, dass generative Werkzeuge in industriellen Produktionsketten verankert werden.
Native 4K-Ausgabe macht nachträgliches Upscaling überflüssig
Die meisten Open-Source-Modelle bleiben aus VRAM-Gründen bei nativen Auflösungen im Megapixel-Bereich stecken und erfordern separate Super-Resolution-Modelle, um überhaupt produktionstauglich zu sein. FLUX 3 Image schraubt die maximale native Auflösung direkt auf 5456 × 3072 Pixel hoch. Die daraus resultierenden rund 16,8 Megapixel erreichen auf Anhieb das Niveau professioneller Druckvorstufen und anspruchsvoller Stock-Archive, wodurch aufwendige Post-Processing-Schritte komplett entfallen.
Native Ultra-High-Definition und nachträgliches Upscaling verfolgen zwei grundverschiedene technische Ansätze. Upscaling-Algorithmen müssen fehlende Hochfrequenzinformationen erraten und künstlich hinzuerfinden, was an Materialkanten oft zu einem unnatürlichen Plastik-Look führt. Eine native Ausgabe von 5456 × 3072 Pixeln tastet hochfrequente Merkmale hingegen bereits im Diffusionsprozess vollständig ab und bewahrt so authentische Oberflächentexturen und physikalische Glaubwürdigkeit.
 Abb.: Die native hochauflösende Ausgabe bewahrt feine Haar- und Textilstrukturen. Quelle: Black Forest Labs
Indem die hochauflösende Generierung in ein einziges Modell integriert wird, entfällt eine fehleranfällige Kaskade aufeinanderfolgender Arbeitsschritte. Bislang erforderte ein druckreifes Großformat mehrere Zwischenschritte aus Generierung, Outpainting und Upscaling, wobei jede Übergabe die Fehlerquote erhöhte. Die direkte Ausgabe in einem Durchgang senkt die architektonische Komplexität von Inferenz-Pipelines erheblich und stoppt die Verschwendung von Rechenkapazität in Zwischenstufen.
Offene Gewichte ans Ende des Release-Plans verbannt
Im Juli 2026 stellte Black Forest Labs (BFL) seine vereinheitlichte multimodale Flow-Matching-Architektur vor. Im August folgte FLUX 3 Video, im September im Zuge von Kooperationen FLUX 3 Action – doch die zentrale Bildgenerierung ging erst am 1. Oktober live, und das ausschließlich über die API. Dass die Bereitstellung der FLUX 3 Dev-Gewichte um mehrere Wochen nach hinten verschoben wurde, bringt den Zeitplan der Open-Source-Community empfindlich durcheinander.
Die Bildgenerierung spricht die mit Abstand breiteste Nutzerschaft an, wurde im Veröffentlichungszyklus jedoch hinter Video- und Action-Modelle gereiht. Mit Blick auf die Roadmap liegt die plausibelste Erklärung auf der Hand: Zunächst bindet man zahlende Unternehmenskunden an proprietäre Cloud-Schnittstellen, bevor man der Community Wochen später frei verfügbare Modellgewichte überlässt.
Zu Zeiten von FLUX.1 etablierte sich das Modell durch die sofortige Freigabe der Gewichte blitzschnell als De-facto-Standard der lokalen KI-Szene. Die jetzige Verzögerungstaktik dient vor allem dazu, dem hauseigenen API-Dienst ein exklusives Vermarktungsfenster zu verschaffen. Gewöhnen sich Entwicklungspartner erst einmal an die offiziellen Schnittstellen, sinkt der Anreiz für aufwendige lokale Eigeninstallationen. Dieser künstliche Zeitversatz zieht eine klare Trennlinie zwischen zahlungskräftigen Großkunden und kostenbewussten Einzelanwendern.
Kommerzielle Staffelung spaltet lokale und Cloud-Nutzer
Das Ökosystem der Bildgenerierung steuert auf eine unumkehrbare Spaltung zu: Auf der einen Seite stehen versierte Entwickler, die maximale Souveränität auf eigener Hardware fordern; auf der anderen Seite professionelle Produktionsstraßen, die auf kompromisslose Steuerbarkeit angewiesen sind. Mit Multi-Bild-Konditionierung und selektiver Bildretusche bedient FLUX 3 Image über seine API gezielt zahlungswillige Unternehmenskunden. Die Cloud-Lösung ebnet dank ihrer hohen Verlässlichkeit die technischen Hürden lokaler Deployments vollständig ein.
Unternehmen mit strengen Datenschutzvorgaben und Bedarf an domänenspezifischem Fine-Tuning bleibt derweil nur die Wahl, teure kommerzielle Modellgewichte für den Eigenbetrieb zu lizenzieren. Wird das lokale Basismodell nicht zügig nachgezogen, bleiben Open-Source-Nutzer weiterhin im Zeitalter des unberechenbaren Prompt-Roulettes gefangen. Diese Kluft zwischen den beiden Pfaden bringt den strukturellen Konflikt zwischen breiter Technologie-Demokratisierung und aggressiver Monetarisierung schonungslos ans Licht.
Die API-Steuerungsschicht garantiert verlässliche Mindeststandards: Anwender können sich auf ihre Business-Logik konzentrieren, ohne sich mit GPU-Kernel-Optimierungen auseinandersetzen zu müssen. Lokale Modelle bieten zwar prinzipiell mehr Gestaltungsspielraum, schrecken jedoch mit hohem Konfigurationsaufwand und technischer Komplexität die Masse der Designer ab. Über diese Differenzierung sichern sich die Modellhersteller eine dominante Verhandlungsposition.
Der Wettbewerb generativer Bildmodelle verlagert sich endgültig von vagen Texteingaben hin zu exakter Layout-Steuerung. Wenn Gestalter Elemente über Koordinaten von 0 bis 1000 millimetergenau platzieren und den visuellen Stil über bis zu 10 Referenzen festlegen können, wird Bildgenerierung von einer unkalkulierbaren Blackbox zu planbarer Ingenieursarbeit. Das markiert die Reifeprüfung für den Einzug generativer KI in professionelle Design-Pipelines. Dass diese Fähigkeiten jedoch vorerst hinter einer Bezahlschranke verharren und freie Gewichte verzögert werden, zeigt: Spitzenwerkzeuge bleiben vorerst ein Privileg zahlender Kunden. Im Kräftemessen zwischen Open Source und geschlossener Verwertung haben die Hersteller gelernt, Nutzergruppen über Steuerungspräzision zu segmentieren. Denn den Markt verändert künftig nicht mehr, was eine KI malen kann – sondern wie exakt der Mensch das Ergebnis beherrscht.
Weiterführende Links:
- Offizielle Website von Black Forest Labs
- BFL API-Entwicklerdokumentation