Das Git-Projekt peilt Ende 2026 für die Veröffentlichung von Git 3.0 an. Geplant ist, das Standard-Objektformat für alle neu initialisierten Repositories auf SHA-256 umzustellen. Zeitgleich soll dieser Meilenstein eine Rust-Build-Toolchain vorschreiben, das Reftable-Backend als Standard etablieren und eine Reihe veralteter Legacy-Befehle endgültig entfernen. Zwar bleibt bis zum Release noch eine Übergangsfrist, doch Entwicklerteams und Tooling-Entwickler müssen ihre Kompatibilitätsprüfungen jetzt in Angriff nehmen.
Ein geänderter Standardwert zwingt das gesamte Ökosystem zur Neuvalidierung
Das Kernentwicklerteam betont, dass bestehende Repositories im SHA-1-Format auch unter Git 3.0 stabil weiterlaufen werden. Diese offizielle Argumentation versucht, die Bruchstellen ausschließlich auf neue Projekte zu beschränken. In realen Entwicklungsumgebungen bedeutet ein Eingriff in den Standard für neue Repositories jedoch einen harten Bruch mit der gewohnten Evolution des Ökosystems. Sobald ein Entwickler lokal ein neues Experimentier-Repository (git init) anlegt, verweigern ältere IDE-Plugins den Dienst. Nicht mehr aktiv gewartete Deployment- und Release-Skripte prallen sofort gegen die Fehlermeldungen einer inkompatiblen Doppelstruktur.
Die gravierendste Schwachstelle liegt in der tief verankerten Annahme der Toolchain, dass Objekthashes stets aus 40 Hexadezimalzeichen bestehen. In neuen Repositories wachsen diese Bezeichner schlagartig auf 64 Zeichen an. Dieser Sprung in der Zeichenkettenlänge zerstört unzählige Parsing-Routinen, reguläre Ausdrücke und Log-Extraktoren, die in den vergangenen fünfzehn Jahren entstanden sind. Log-Analysemodule in CI/CD-Pipelines werfen beim ersten Kontakt mit SHA-256-Commit-Metadaten sofort Parsing-Fehler oder Truncation-Exceptions.
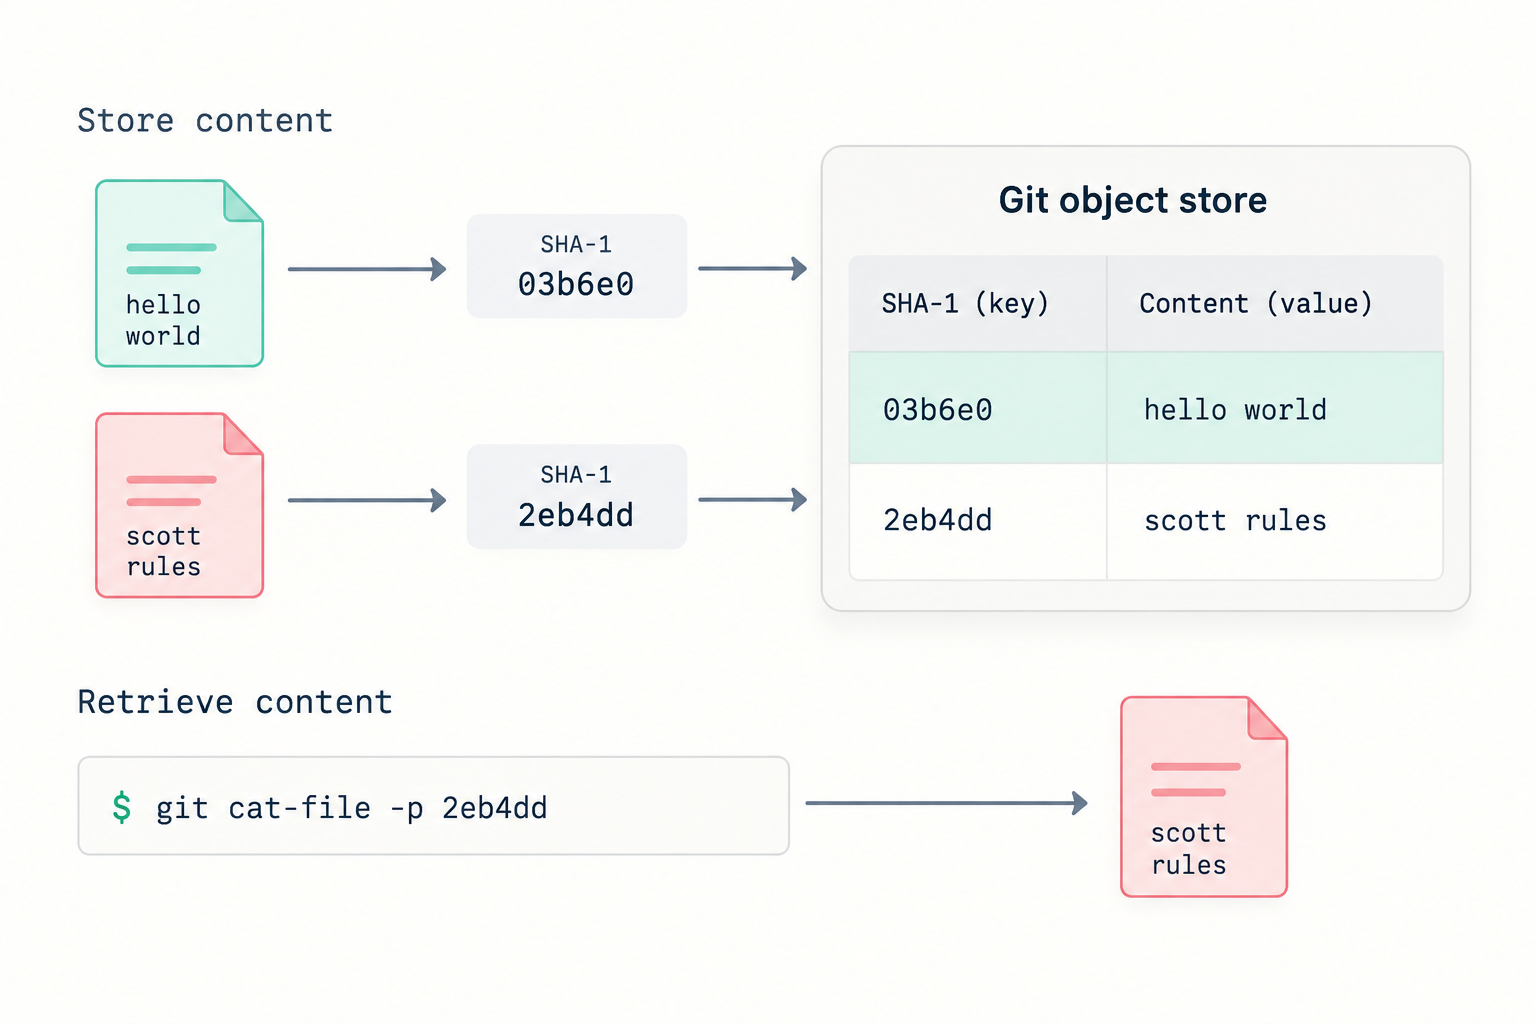 Abb.: Git als Key-Value-Objektdatenbank auf Basis von Content-Hashes. Quelle: GitButler / Butler’s Log
Git unterstützt die optionale Erstellung von SHA-256-Repositories experimentell bereits seit 2018; sicherheitskritische Projekte konnten den Wechsel schon damals freiwillig vollziehen. In diesem achtjährigen Zeitfenster war die Zahl der Projekte, die diese Migrationslast freiwillig auf sich genommen haben, jedoch verschwindend gering. Das Umlegen des Standardwerts wurde für das Kernteam somit zum einzigen Hebel, um die Umstellung in der Praxis überhaupt durchzusetzen.
Kollisionsangriffe und Second-Preimage-Angriffe sind grundlegend verschieden
Das NIST stufte SHA-1 bereits 2011 offiziell als veraltet ein; die Position der Standardisierungsgremien ist seit über einem Jahrzehnt eindeutig und verlangt die vollständige Ausmusterung bis 2030. Die Begründung des Git-Kernteams für den Wechsel ist naheliegend: Neu aufgesetzte Codebasen sollen nicht länger auf einem Algorithmus aufbauen, der offiziell als unsicher gilt.
Kritiker wie GitHub-Mitgründer und GitButler-Schöpfer Scott Chacon halten dem entgegen, dass diese Argumentation völlig unterschiedliche Bedrohungsszenarien vermengt. Die IT-Sicherheitsforschung demonstrierte mit dem SHAttered-Projekt 2017 und dem Paper „SHA-1 is a Shambles“ 2020 zwar praktische Kollisionsangriffe auf den Algorithmus. Doch zwei eigens präparierte Binärdateien mit identischem Hashwert zu erzeugen, ist etwas völlig anderes als ein sogenannter Second-Preimage-Angriff, bei dem ein Angreifer zu einem bestehenden, unbekannten Originalcode gezielt bösartigen Quelltext mit demselben Hashwert fälschen müsste.
In der Software-Engineering-Praxis bleibt ein Second-Preimage-Angriff auf bestehende Repositories astronomisch teuer und praktisch ausgeschlossen. Selbst wenn Git seine Integritätsprüfung auf das nachweislich gebrochene MD5 herabstufen würde, bliebe ein solcher Angriff unmöglich: Würde jede der rund 3 Milliarden GPUs weltweit magisch durch eine RTX 5090 ersetzt und unter Volllast betrieben, läge die voraussichtliche Berechnungsdauer für ein Second-Preimage immer noch in der Größenordnung von 16 Milliarden Jahren. Die weltweiten Hardwareressourcen können die gigantische Kluft zwischen theoretischer mathematischer Schwäche und praktischem Exploit schlicht nicht überbrücken.
Auch das Nachstellen akademischer Kollisionsangriffe im Entwicklungsalltag scheitert an der praktischen Umsetzbarkeit. Ein Angreifer müsste sich zunächst Schreibrechte im Ziel-Repository verschaffen, riesige Blöcke künstlicher Entropie in den Commit einschleusen und die Upstream-Maintainer anschließend dazu bringen, genau diesen manipulierten Branch zu mergen. Der Bau derart aufwendiger bösartiger Artefakte bietet für reale Cyberkriminelle schlicht keinen wirtschaftlichen Ertrag.
Vertrauen basiert auf der Bezugsquelle, nicht auf dem Krypto-Hash
Diese Kontroverse berührt die architektonischen Sicherheitsgrenzen moderner Versionskontrollsysteme. Linus Torvalds stellte schon 2005 klar: Die eigentliche Verteidigungslinie liegt im Verteilungsweg und nicht in einer mathematischen Formel. Was die Sicherheit einer Entwicklerumgebung bestimmt, ist allein die Frage, von welchem vertrauenswürdigen Server Aktualisierungen bezogen werden. Dieses Vertrauen wiegt ungleich schwerer als die Wahl der Prüfsumme, mit der Dateien auf der Festplatte abgelegt werden.
Reale Angriffe auf Software-Lieferketten setzen fast ausnahmslos auf Social Engineering statt auf Kryptoanalyse. Angreifer kaufen bevorzugt verwaiste Open-Source-Pakete auf oder schleichen sich über Monate hinweg als scheinbar verlässliche Mitwirkende ein, um Commit-Rechte zu erlangen – wie der xz-Backdoor-Vorfall von 2024 eindrucksvoll zeigte. Legitime Schreibrechte zu kapern und direkt einen Trojaner zu platzieren, ist um ein Vielfaches billiger, schneller und erfolgreicher, als Millionen in GPU-Farmen für eine Hash-Kollision zu verbrennen.
Die Bitlänge eines Algorithmus als Hauptverteidigung gegen bösartigen Code zu betrachten, blendet die eigentlichen Authentifizierungslücken in Build- und Release-Pipelines aus. Das Austauschen eines Release-Tarballs unter einem gültig signierten Tag erfordert keinerlei Hash-Kollision. Verunreinigten Code abzuwehren gelingt nur durch lückenlos kontrollierte Vertriebswege; ein längerer Hash vermag diese operative Sicherheitslücke nicht zu schließen.
Die unbezahlte Migrationsrechnung: Zwei inkompatible Formate prallen aufeinander
Die größte Hürde bei der Umstellung des Standardwerts ist die Migration bestehender Projekte – sie geschieht keineswegs geräuschlos im Hintergrund.
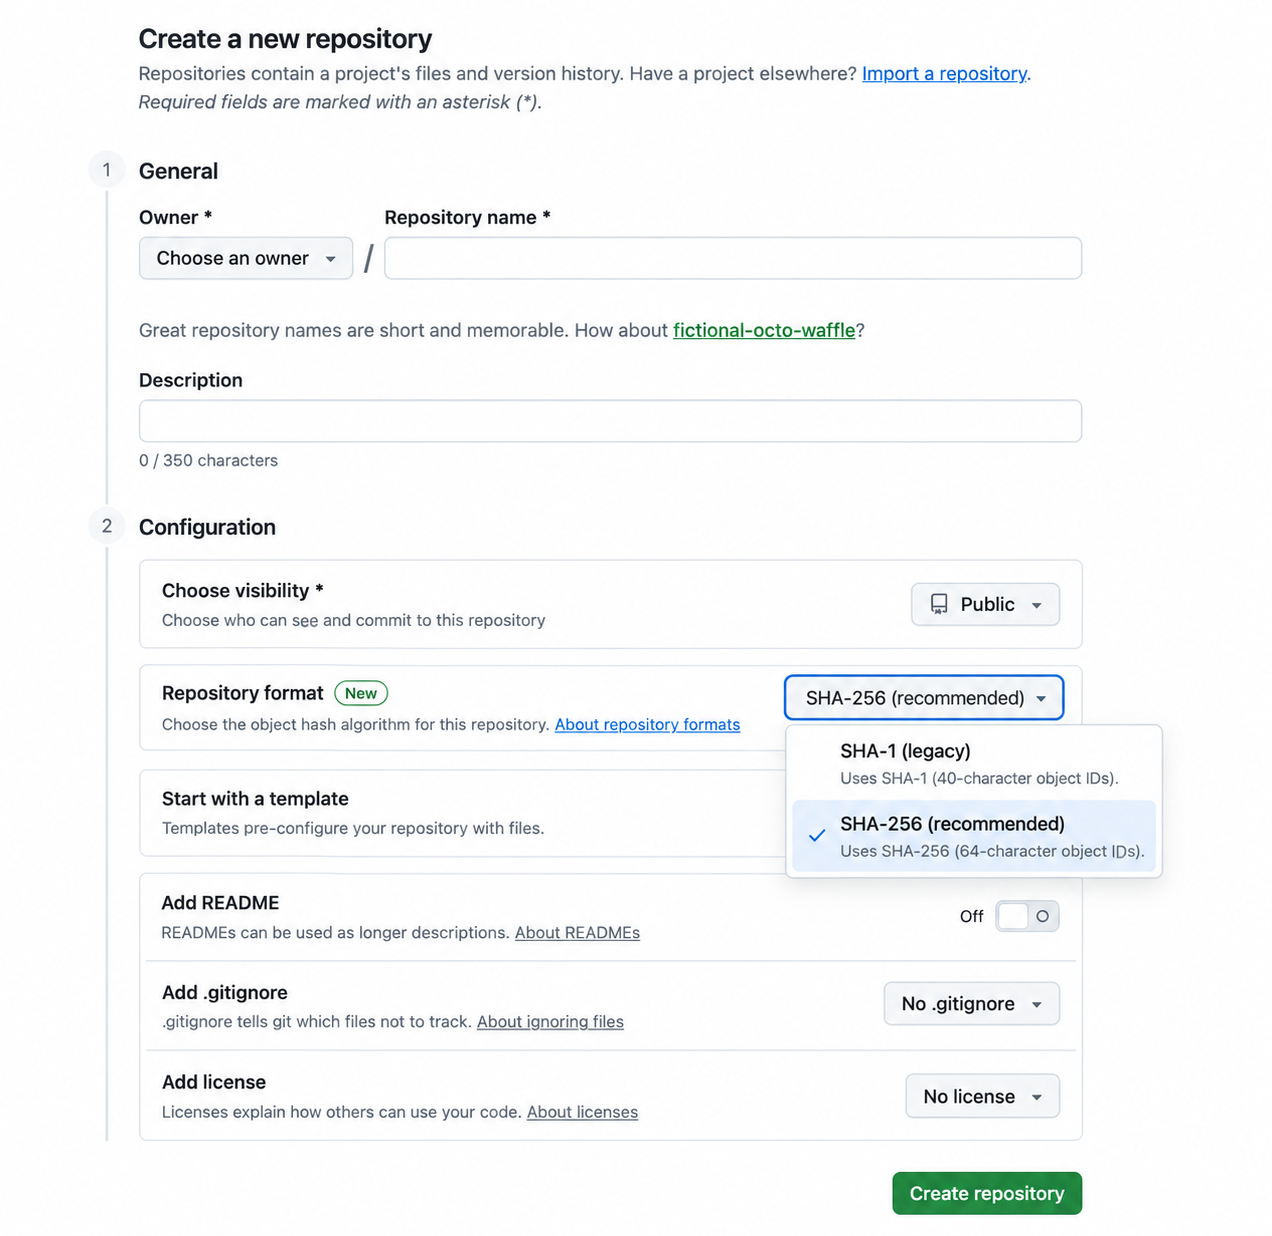 Abb.: Benutzeroberfläche einer Hosting-Plattform mit manueller Hash-Format-Auswahl bei der Repository-Erstellung. Quelle: GitButler / Butler’s Log
Teams, die Repositories auf privaten oder selbst gehosteten Plattformen betreiben, müssen Client- und Server-Konfigurationen manuell abgleichen. Sobald lokale Einstellungen und Remote-Unterstützung voneinander abweichen, schlägt der Push fehl und bricht mit einer Fehlermeldung ab: fatal: the receiving end does not support this repository's hash algorithm.
Die Konvertierung gewachsener Bestands-Repositories erzwingt das Umschreiben der gesamten Projekthistorie. Ein bestehendes SHA-1-Repository auf SHA-256 umzustellen bedeutet, jedes einzelne Blob-, Tree- und Commit-Objekt neu zu berechnen. Dieser totale Neustart entwertet mit einem Schlag sämtliche historischen GPG- und SSH-Signaturen. Zudem verweisen unzählige Dokumentationen, Ticketsysteme und Chat-Verläufe auf 40-stellige Commit-Hashes; nach einer Umstellung laufen all diese Verweise über Nacht ins Leere.
Die Submodul-Architektur von Git verschärft diese Fragmentierung zusätzlich. Nach aktuellem Regelwerk müssen verschachtelte Submodule dasselbe Objektformat wie das übergeordnete Repository nutzen. Hängt ein Projekt von einem externen SHA-1-Submodul ab, während das Hauptprojekt auf SHA-256 migriert, müssen CI-Server zwei getrennte Kopien beider Formate pflegen. Gerät diese parallele Synchronisation aus dem Tritt, steht die automatisierte Pipeline des gesamten Teams still.
Zudem hinken eigenständige Git-Bibliotheken und Re-Implementierungen (wie libgit2), die nicht auf die offiziellen Git-C-Binaries zurückgreifen, bei der Unterstützung des neuen Algorithmus deutlich hinterher. Gerüchten zufolge erwog man bei Google sogar unternehmensweite Vorgaben, die neue interne Projekte weiterhin auf das SHA-1-Format festlegen sollten. Große Technologiekonzerne frieren fundamentale Versions-Upgrades lieber ein, als teure Engineering-Kapazitäten mit der Fehlersuche in inkompatiblen Toolchains zu binden.
Der alternative Ansatz: Den Rechenaufwand in die Signatur verlagern
Der Vorstoß des Kernteams für den neuen Standard kommt nicht aus heiterem Himmel. Interoperabilitäts-Konzepte zur Verknüpfung beider Formate wurden auf den Mailinglisten über Jahre hinweg diskutiert. Aus Sicht der Infrastrukturentwickler ist es ein logischer Schritt, kurzzeitige Reibungsverluste in Kauf zu nehmen, um jahrzehntelange Manipulationssicherheit zu garantieren. Systemarchitekten neigen naturgemäß dazu, theoretische Schwachstellen direkt auf der untersten Speicherebene zu schließen.
Gegner in der Community plädieren hingegen dafür, den Verteidigungsaufwand in einem beherrschbaren Rahmen zu halten. Unabhängige Maintainer schlagen vor, auf den umwälzenden Umbau der Speicherformate komplett zu verzichten. Stattdessen solle ein unabhängig berechneter Content-Prüfsummen-Header (wie SHA-256 oder BLAKE3) direkt in die Commit- und Tag-Signaturobjekte eingebettet werden – angelehnt an Colin Walters’ Werkzeug git-evtag.
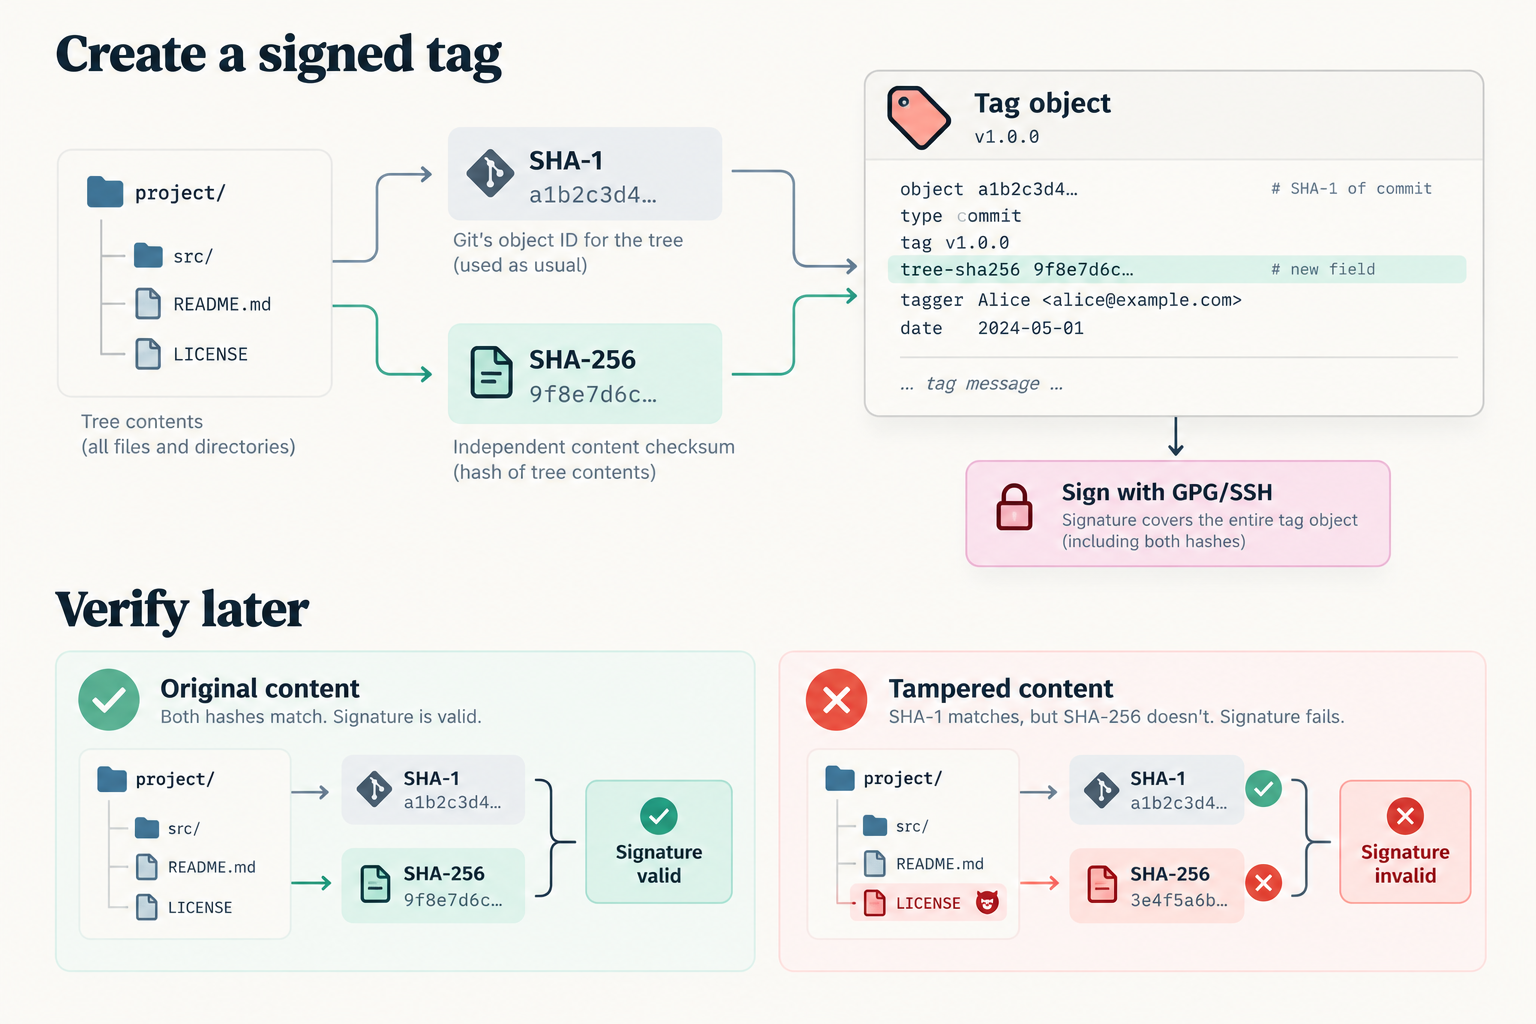 Abb.: Injektion eines unabhängigen Content-Hashes in die signierten Felder eines Git-Objekts. Quelle: GitButler / Butler’s Log
Dieses Konzept verlagert den kryptografischen Berechnungsaufwand vollständig in die Signaturphase. Ein Angreifer, der die Projekthistorie fälschen wollte, müsste zwei völlig voneinander entkoppelte Prüfsysteme zeitgleich überwinden.
Der größte Vorteil eines separaten Verifizierungs-Headers besteht darin, den täglichen Entwicklungsbetrieb von Performance-Einbußen abzuschirmen. Messungen zeigen, dass das Erzeugen einer unabhängigen Baum-Prüfsumme für das gewaltige Chromium-Repository (35 GB und 2,1 Millionen Dateien) lediglich 5 Sekunden dauert. Beim 1,5 GB großen Linux-Kernel-Baum sind es 257 Millisekunden, bei regulären kleineren Projekten sogar nur 17 Millisekunden. Wird der Rechenaufwand auf den Zeitpunkt des Signierens von Release-Tags beschränkt, bleiben die alltäglichen Commit-Zyklen von zusätzlichen Latenzen verschont.
Der Zwang zu SHA-256 erkauft theoretische Sicherheitsreserven für die kommenden Jahrzehnte; das Beibehalten des Status quo erspart dem Ökosystem eine astronomische Migrationsrechnung. Die Prämissen beider Lager sind klar definiert: Gilt der Speicher-Hash als primäre Vertrauensbasis, kann der Wechsel nicht früh genug kommen; entspringt Vertrauen der Verteilungskette und der Bezugsquelle, verliert die Umstellung ihre Dringlichkeit. Die seit Jahren diskutierte Interoperabilitäts-Abbildung auf den Mailinglisten bleibt das einzig realistische Polster, um diesen Übergang abzufedern.
Weiterführende Links:
- Git 3.0 and the SHA-256 Migration
- The hidden cost of Git’s SHA-256 migration