Störung im Rechenzentrum von Chase, Stocken bei fremden Überweisungen
„Einige Dienste sind vorübergehend nicht verfügbar. Wir arbeiten an einer Behebung, bitte versuchen Sie es später erneut.”
Am Montag, den 16. November 2026, füllte dieser Hinweis die Bildschirme der Mobiltelefone von JPMorgan-Kunden. Am selben Tag stellten Kunden zahlreicher großer US-Banken fest, dass ihre Online-Konten nicht erreichbar waren, und das Echtzeit-Überweisungsnetz Zelle fiel großflächig aus.
Die Berichterstattung der Associated Press vom selben Tag nannte die Ursache: Der Fehler lag im eigenen Rechenzentrum von JPMorgan Chase, ein Hackern-Angriff war nicht der Auslöser. Zum Vergleich: Bei Bank of America und Citigroup lief alles normal, ausgefallen war ausgerechnet bei jenen Banken, die Zahlungstransaktionen mit Chase abwickeln. Die Verteilung zeigte unmissverständlich: Der Ausfall folgte den Zahlungsströmen – er wurde keineswegs gleichmäßig umgelegt.
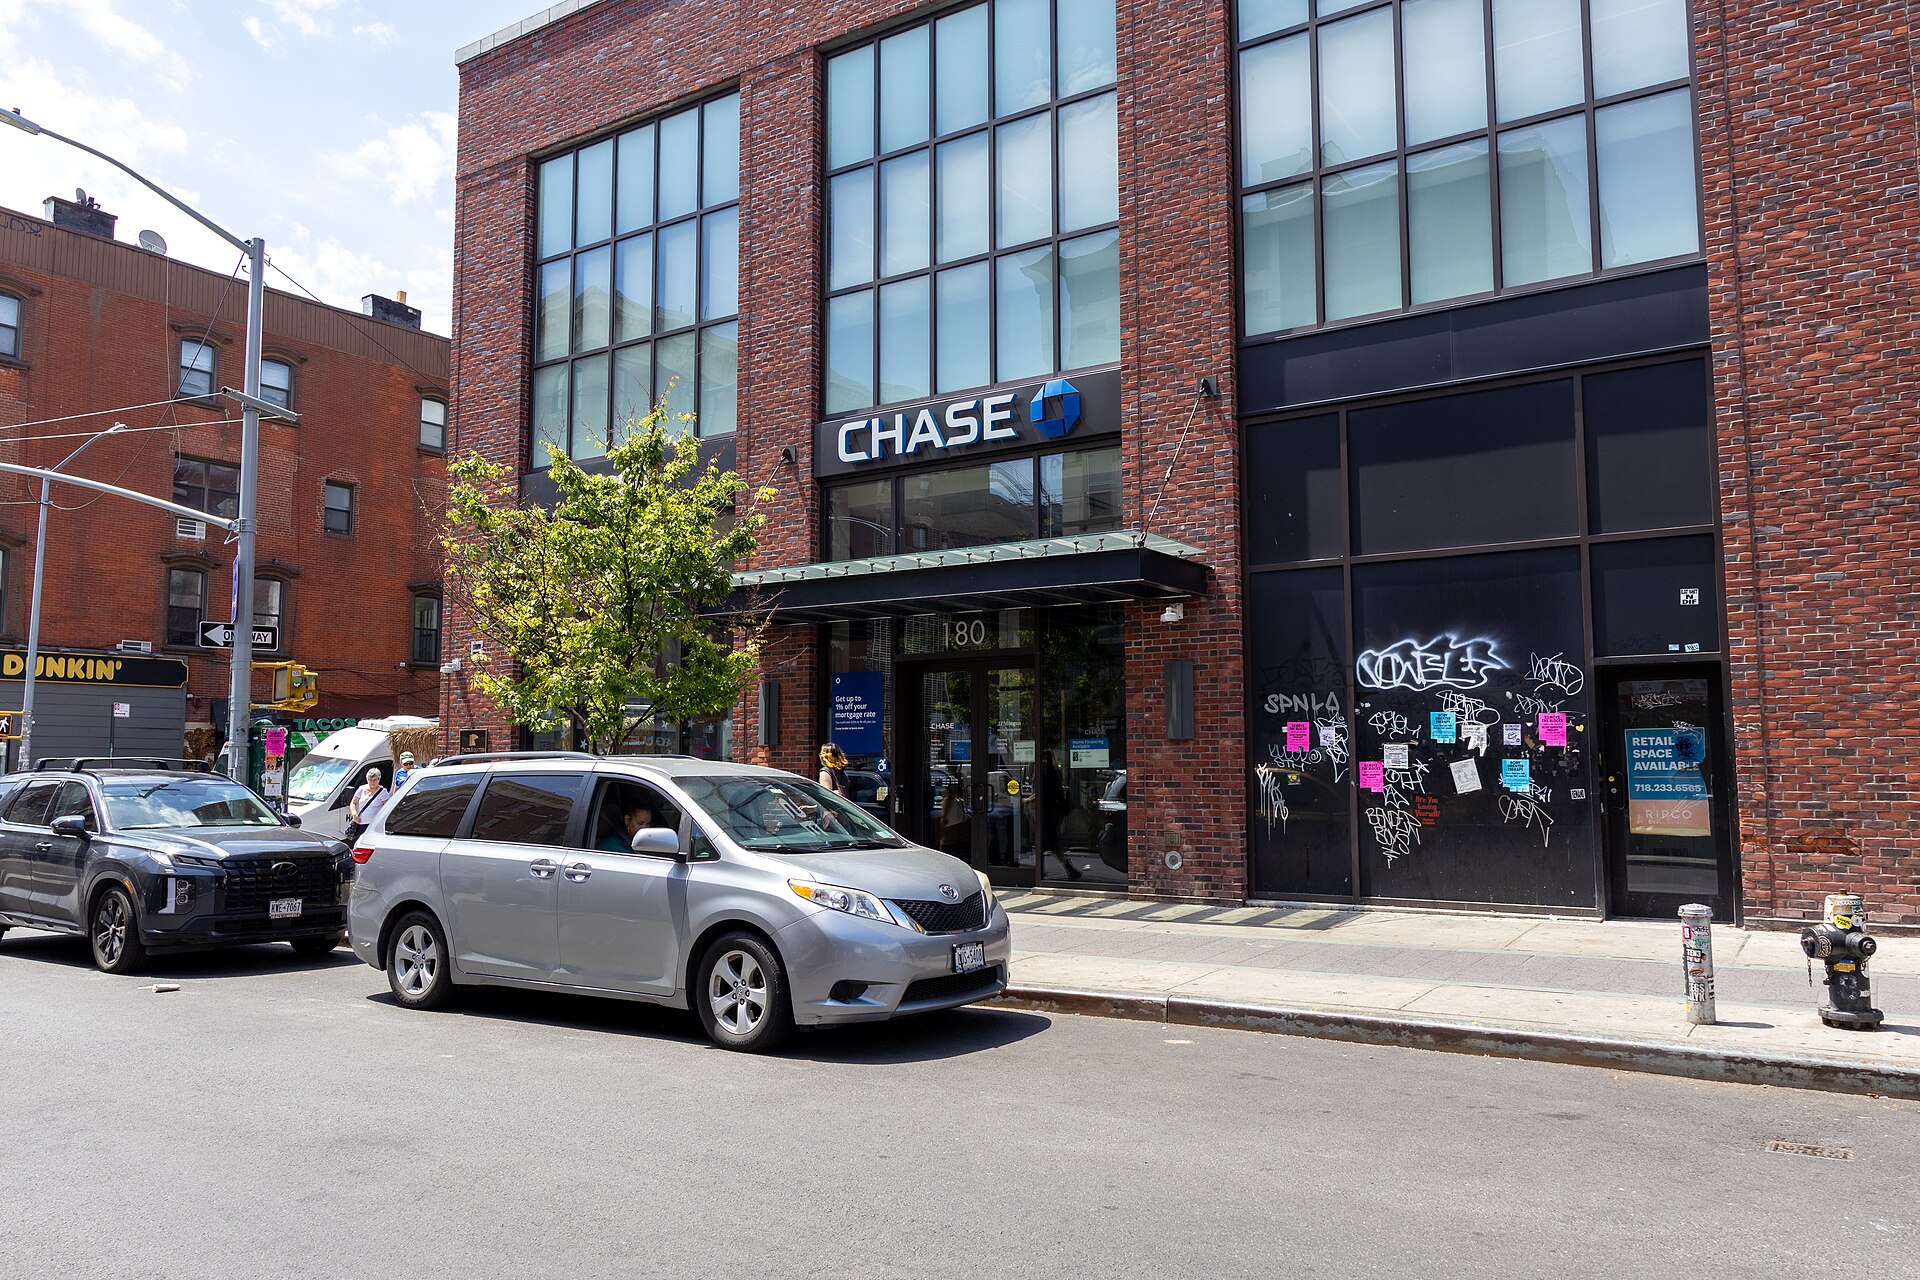 Abbildung: Eine Chase-Filiale in Brooklyn, New York. Die Ursache der Störung lag an diesem Tag im eigenen Rechenzentrum, nicht in der Filiale an der Straße. Quelle: Wikimedia Commons
Z erst die Hacker-Gerüchte ausgeräumt, dann der Verweis auf das eigene Rechenzentrum
Chase-Sprecher Joe Evangelisti brachte den Vorfall auf eine Formel: „JPMorgan hat ein temporäres Problem im Zusammenhang mit einem Softwarefehler in lokal betriebener Hardware – es bestand kein Zusammenhang mit einem Cyberangriff.” Die beiden gewichtigsten Begriffe dieses Satzes: lokal betrieben und Softwarefehler. Lokal betrieben bedeutet, dass die Systeme auf Servern laufen, die die Bank selbst gekauft und im eigenen Rechenzentrum installiert hat – die Hardware gehört ihr, die Betreuung ebenso.
Dass eine Bank mit Bilanzsumme im Billionenbereich im Jahr 2026 ihre Kernsysteme noch auf selbst gekaufter Hardware betreibt, ist keine Überraschung – die Migration von Bankensystemen verläuft traditionell langsam, und Aufsichtsbehörden wie Auditoren scheuen den Umzug. Chase erklärte noch vor den Gerüchten, es bestehe kein Zusammenhang mit einem Cyberangriff, denn bei Nachrichten über Bankausfälle verbreiten sich Hacker-Spekulationen häufig schneller als die offiziellen Mitteilungen.
Dieselbe Erklärung zog zudem eine Grenze: Andere Banken könnten allein dadurch beeinträchtigt sein, dass sie Transaktionen mit Chase abwickeln und sich dadurch die Transaktionsgeschwindigkeit verringert. Damit räumte Chase vorab ein: Meine Störung wird zu deiner Störung.
Wer mit Chase verrechnet hat, wird langsamer
Zelle wird von Early Warning Services mit Sitz in Arizona betrieben und ist der Echtzeitkanal, den Amerikaner im Alltag für Überweisungen zwischen verschiedenen Banken nutzen; Gutschriften erfolgen üblicherweise binnen Minuten. Der Betreiber zog die Verantwortungsgrenze klar: Das Zelle-Netz selbst funktioniere einwandfrei, das Problem liege auf Seite der Finanzinstitute und verzögere die Zahlungen eines Teils der Kunden.
Die Erklärung der U.S. Bank ergänzte das letzte Puzzleteil: Die eigenen Systeme seien nicht direkt betroffen, Kunden könnten jedoch Verzögerungen erleben, wenn sie Zelle-Zahlungen mit anderen Finanzinstituten senden oder empfangen. Übersetzt: Die Bank selbst ist unversehrt, die Staus vor der Tür gehören jemand anderem.
Vergleicht man das Interbanken-Zahlungswesen mit einem Straßennetz: Zelle ist die Schnellstraße, die alle Banken gemeinsam nutzen, und jede Bank besitzt ihre eigene Auffahrt. An der Auffahrt von Chase ereignete sich ein Unfall; die Schnellstraße selbst blieb intakt, doch alle Fahrzeuge, die über die Station Chase mussten, standen auf der Strecke. Der Verkehr von Bank of America und Citigroup nahm andere Auffahrten und floss ungehindert. Die Liste der Betroffenen ordnet sich nach den Zahlungsströmen: Wer Kontoverkehr mit Chase hat, steht auf der Liste – die Größe der Bank und ihr technisches Niveau sind keine Auswahlkriterien.
 Abbildung: Ein Geldautomat. Das Verkaufsargument der Echtzeitüberweisung lautet, die Gutschrift auf Sekundenebene zu drücken; blockiert der Kanal, fallen aus Sekunden Stunden. Quelle: Wikimedia Commons
Der Kanal Zelle gehört sieben Großbanken
Die Aktionärsliste von Early Warning Services ist bereits eine Vorankündigung des Ausfallumfangs: Bank of America, Capital One, JPMorgan Chase, PNC, Truist, U.S. Bank und Wells Fargo besitzen das Unternehmen gemeinsam. Der Kanal, den Kunden täglich für Überweisungen zwischen Banken nutzen, gehört ebendiesen sieben Banken, die er miteinander verbindet.
Diese Struktur erklärt, warum sich der Ausfall über Bankgrenzen hinweg ausbreiten konnte. Chase ist zugleich Eigentümer des Kanals und ein Knoten auf ihm – die Eigentümerrolle schützt nicht vor dem Ausfall eines Knotens. An dem Tag, an dem das Rechenzentrum von Chase ausfiel, standen auch die Kunden der sechs anderen Aktionäre in der Warteschlange. Der Kanal ist geteilt, und die Störung ist es ebenso: Die eingesparten Kosten eigener Kanäle werden mit einer Verfügbarkeit erkauft, die an die der anderen gekoppelt ist. Diesen Tausch halten die Aktionärsverträge seit langem schriftlich fest; gesehen haben die Kunden die Klauseln nie.
Dieselbe Woche: Cloud, Rechenzentrum und Flugsicherung fallen je einmal aus
Streckt man die Zeitachse auf sieben Tage: Am Donnerstag kam es zu einer großflächigen Störung der Microsoft-Cloud-Dienste, Outlook, Teams und Copilot fielen gemeinsam über mehrere Stunden aus; am Freitag versagte das US-Flugsicherungssystem, der Flugverkehr in den USA stand mehrere Stunden still und die Wochenendreisen gerieten weiter durcheinander; am Montag war das Rechenzentrum von Chase an der Reihe. Die AP-Berichterstattung brachte zudem den Zeitpunkt der Microsoft-Störung einmal durcheinander – zunächst als Freitag angegeben, dann auf Donnerstag korrigiert. In einer Woche dichter Ausfälle geriet auch die Zeitlinie der Medien in Unordnung.
Ein Vergleichsfall findet sich bereits im Vormonat: Der britische Anbieter Revolut war von einer Störung bei Google Cloud betroffen, die Behebung dauerte zwölf Stunden. Eigenbetriebene Rechenzentren und Cloud-Hosting liefern beide Single Points of Failure; gegen die Architekturwahl ist niemand immun. Wählbar bleibt nur der Radius des Ausfalls. Die drei Störungen verteilten sich auf drei Architekturen – die Cloud eines Großkonzerns, nationale Infrastruktur, das bankeneigene Rechenzentrum. Der Single Point of Failure wählt nicht nach Architektur, sondern danach, mit wem er verbunden ist.
Verfügbarkeit folgt den Zahlungsströmen, nicht dem technischen Niveau
Stellt man die drei Fakten dieses Vorfalls nebeneinander: keine Hacker, kein Datenleck, kein Cloud-Ausfall – die offiziellen Mitteilungen verengten den Problemkreis auf jene, die Transaktionen mit Chase abwickeln. Dennoch stockten die Interbanken-Überweisungen weiter, die Kunden warteten weiter, und andere Banken erklärten ihren Nutzern weiter: Unsere Systeme sind intakt, der Fehler liegt woanders.
Blickt man auf jenen Fehlertext zurück, so hatte „einige Dienste sind vorübergehend nicht verfügbar” am Folgetag eine Leserschaft, die die Kundenliste von Chase bei weitem übertraf. Die „Gutschrift in Echtzeit” ist ein Versprechen, das sieben Banken gemeinsam unterzeichnet haben – jede einzelne ist berechtigt, für alle auf Pause zu drücken, und das Wissensrecht der Kunden über diese versteckte Klausel beträgt null. Chase hat sein Rechenzentrum mit einer einzigen Softwarekorrektur repariert; den Zahlungsverbund abzubauen, der sieben Banken aneinanderbindet, wird dauern, bis die Aktionäre das nächste Mal an denselben Tisch sitzen.
Referenzen:
- AP-Bericht vom 16.11.2026
- Erläuterungen von Early Warning Services zum Zelle-Netz
- Community-Diskussionen zur Dienststörung bei Revolut