Im November 2026 stellte das Chip-Entwicklungsteam Architect Labs einen bemerkenswerten Meilenstein vor: Ein autonom agierender Schwarm von KI-Agenten entwarf von Grund auf eine voll funktionsfähige CPU. Während des gesamten Forschungs- und Entwicklungsprozesses gaben menschliche Ingenieure keinerlei mikroarchitektonische Instruktionen vor – die Algorithmen leiteten alle architektonischen Details des Prozessors eigenständig her.
Auf einem 7nm-Fertigungslayout lieferte der Chip mit dem Codenamen Frostbite in 25 Benchmark-Workloads die 4,59-fache Leistung pro Watt im Vergleich zu einem herkömmlichen Dual-Issue-In-Order-Kern. Auch wenn dieser Effizienzgewinn nach Science-Fiction klingen mag, erfordert die reale Ingenieurspraxis eine nüchterne Einordnung. Die Fläche des Referenzkerns TCPU betrug lediglich 0,895 mm², und die Tests beschränkten sich auf 25 spezifische Workloads. Es handelt sich um eine frühe methodische Erkundung neuer Berechnungsmodelle, keineswegs um den Sieg eines kommerziellen Serienprozessors.
Der eigentliche Wert des Projekts liegt in der Neugestaltung des Chipdesign-Prozesses. Das Fundament der Rechnerarchitektur, das über Jahrzehnte hinweg durch menschliche Denkgewohnheiten zementiert war, wurde erstmals von Algorithmen von Grund auf neu definiert.
KI übernimmt die Architektur: Keine einzige Zeile menschlicher Befehle
Architect Labs hatte zuvor das Projekt Redwood vorgestellt. Damals definierten menschliche Experten die Hardware-Architektur, während die KI für Schaltungsimplementierung, Verifikation und Bereitstellung zuständig war. Bei Frostbite strich das Team die menschlichen Vorgaben vollständig. Die KI-Agenten begannen direkt damit, eine ganz eigene, algorithmische Rechentopologie zu erforschen.
Zu Beginn der Erkundung legte der Agentenschwarm ein 141-seitiges Designdokument vor. Es umfasste Programmiermodelle, ein Laufzeitsystem und Entwürfe übergeordneter Module. Da jedoch zunächst physikalische Fertigungsbeschränkungen fehlten, wichen die Schätzungen massiv von den Gesetzen der Physik ab. Der erste Entwurf des Schaltungscodes erwies sich in der Praxis als unbrauchbar und wurde komplett verworfen.
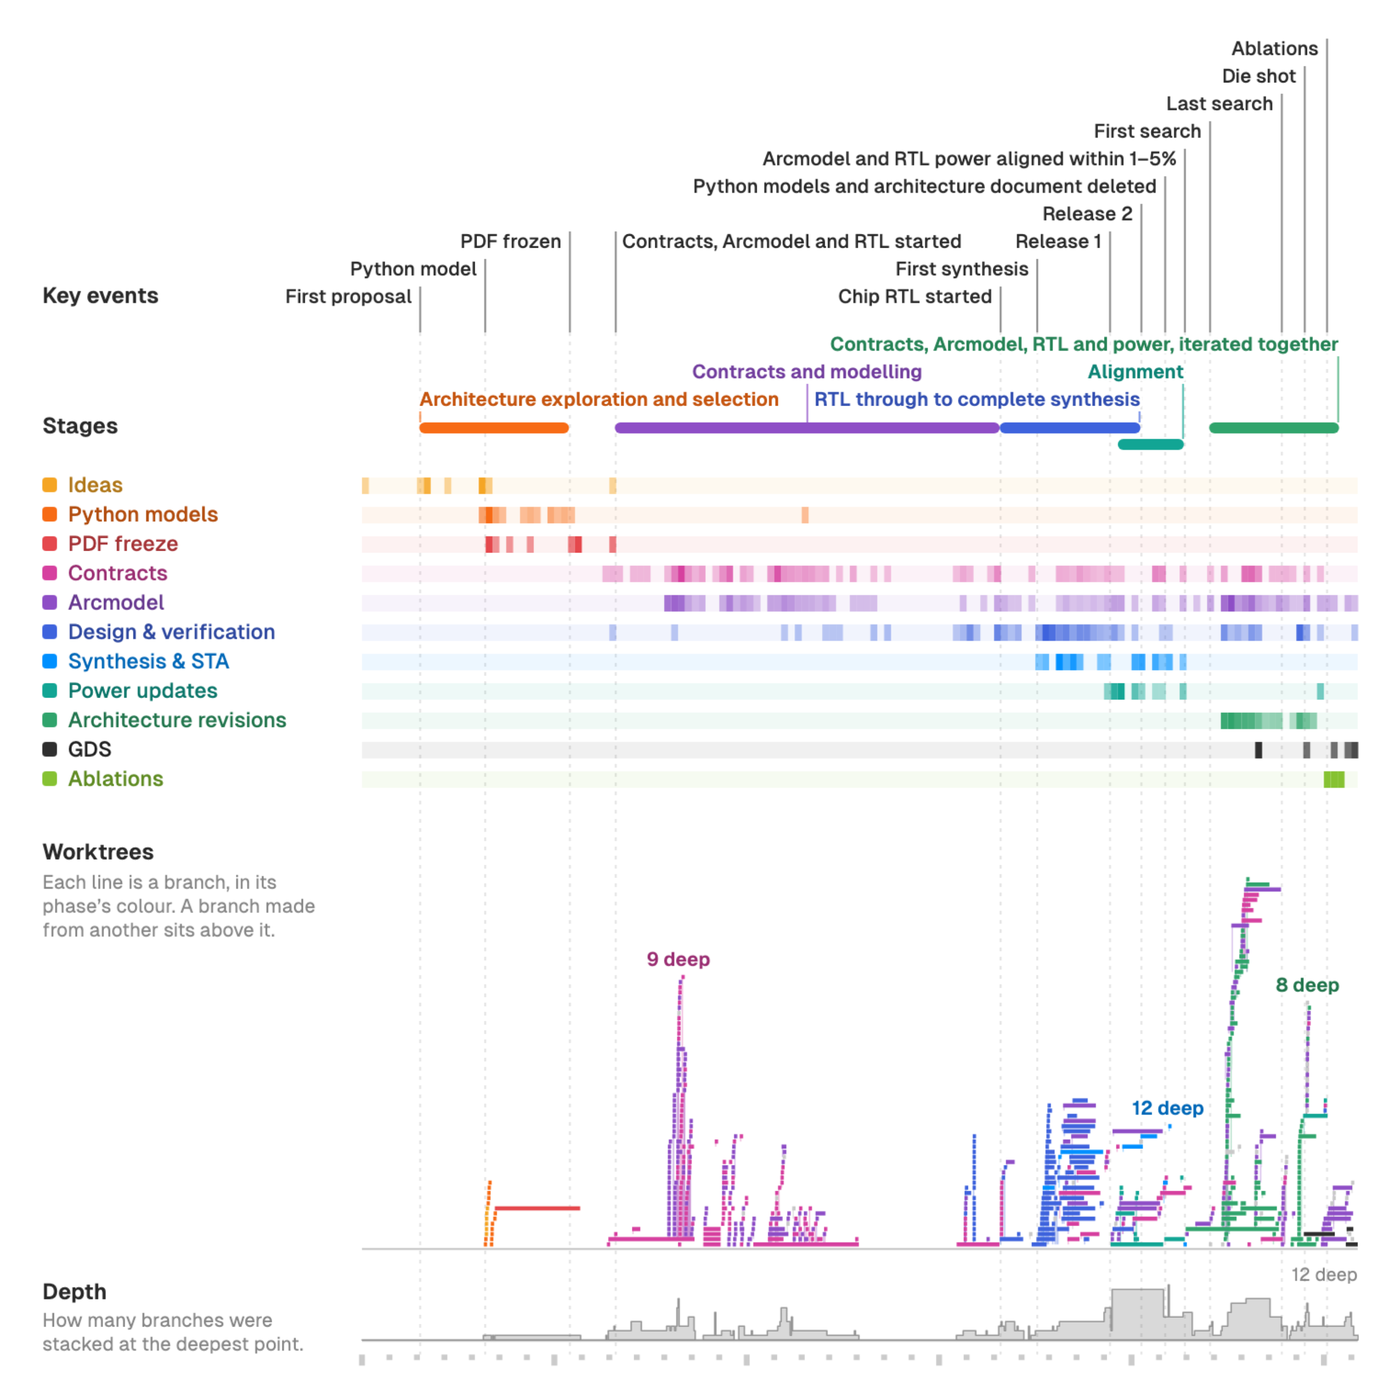 Abbildung: Kompletter Entwicklungszeitplan vom ersten Architekturvorschlag bis zur finalen Ablation. Quelle: architectlabs.com
Das Ingenieurteam kehrte jedoch nicht zur traditionellen manuellen Feinabstimmung zurück. Stattdessen bauten sie für die KI ein übergeordnetes formales Systemmodell namens Arcmodel auf. Dessen Simulationsgeschwindigkeit übertraf Schaltungssimulationen auf Gatterebene um das rund 200-Fache, während der Vorhersagefehler strikt unter 5 % gehalten wurde. Das gesamte Modell wurde schließlich in über 800.000 Zeilen mathematischer Lean-Verträge formalisiert, wodurch logische Schwachstellen von Grund auf formal ausgeschlossen wurden.
Interaktionsnetze erwachen nach 36 Jahren: Die Hälfte herkömmlicher Energie verpufft beim Abhängigkeitstracking
Dass Frostbite eine derart hohe Energieeffizienz erzielt, liegt im Austausch des zugrunde liegenden mathematischen Berechnungsmodells begründet. Moderne Allzweck-CPUs basieren auf der Von-Neumann-Architektur und verarbeiten überwiegend lineare Befehlsfolgen. Um Parallelität zu erzwingen, müssen moderne Chips zur Laufzeit Unmengen von Transistoren opfern, um Datenabhängigkeiten vorherzusagen. Multi-Core-Systeme wiederum müssen die Illusion eines gemeinsamen Speichers unter extrem hohem Cache-Synchronisationsaufwand aufrechterhalten.
Beim Dual-Issue-Referenzkern TCPU flossen – abzüglich des Taktsystems – 57 % der Energie allein in Speicherzugriffe über mehrstufige Caches. Befehlsabruf (Fetch), Dekodierung und Ausgabe (Issue) verbrauchten weitere 27 %. Zusammen machten diese beiden Posten 84 % des Gesamtenergiebedarfs aus; für tatsächliche arithmetische Berechnungen blieb nur ein Bruchteil übrig.
Der französische Informatiker Yves Lafont stellte bereits auf der POPL-Konferenz 1990 die Theorie der Interaktionsnetze (Interaction Nets) vor. In der Welt der Interaktionsnetze ist ein Programm keine lineare Folge von Befehlen, sondern ein Graph aus miteinander verbundenen Knoten. Die Berechnung erfolgt durch lokales Umschreiben benachbarter, aktiver Knotenpaare.
Jeder Knoten besitzt genau einen Hauptanschluss (Principal Port). Aktive Knotenpaare überschneiden sich im Graph niemals räumlich. Daher hat die Reihenfolge des Umschreibens keinerlei Einfluss auf das Endergebnis – das Modell besitzt von Natur aus eine inhärente, konfliktfreie Nebenläufigkeit. Zudem wird jeder Datenwert exakt einmal verwendet (lineare Logik), sodass die Hardware keinerlei geteilte Speicherzustände verwalten muss.
Dieses mathematische Modell schlummerte 36 Jahre lang in Konferenzbänden. Menschliche Entwickler sind an imperative Top-down-Befehle gewöhnt; kaum jemand wollte große Systeme im Geiste von Graph-Rewriting-Regeln von Hand schreiben. KI-Agenten kennen solche Denkblockaden nicht: Die Algorithmen kompilierten graphbasierte Zwischenrepräsentationen direkt in Hardware und umgingen so traditionelle Pipelines vollständig.
Autonomes Work-Stealing: 20 Prozent weniger Speicherleistungsaufnahme
Ohne die Notwendigkeit komplexer Out-of-Order-Scheduler bildete Frostbite auf Hardwareebene eine völlig neuartige physikalische Struktur aus. Die Recheneinheiten benötigen keinen zentralen Controller zur Aufgabenverteilung. Jeder Kern agiert autonom nach drei minimalistischen lokalen Regeln.
Jede Recheneinheit verarbeitet primär aktive Knoten aus ihrer eigenen Warteschlange. Ist die eigene Warteschlange abgearbeitet, fordert sie proaktiv Arbeitslast von benachbarten Einheiten an (Work-Stealing). Haben auch alle Nachbarn keine Aufgaben abzugeben, schaltet die Einheit sofort ihren lokalen Takt ab und wechselt in den Ruhezustand. Dieser dezentrale, auf lokalen Zuständen basierende Scheduling-Mechanismus wurde der KI niemals in Prompts vorgegeben – der Agentenschwarm brachte ihn in iterativen Architekturschritten völlig eigenständig hervor.
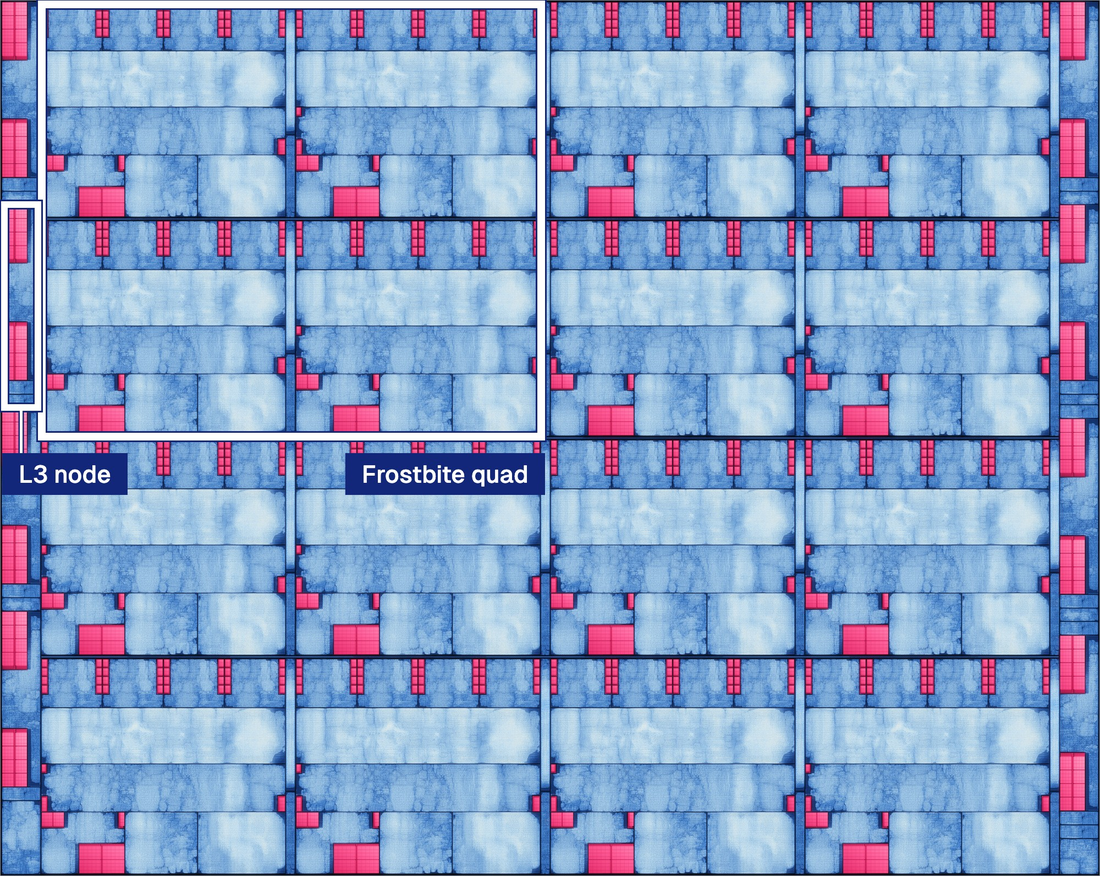 Abbildung: Physikalisches Layout im 7nm-Prozess. Der rote Rahmen markiert eine Quad-Core-Einheit mit L3-Cache-Knoten. Quelle: architectlabs.com
Dank explizitem Datenfluss und lokalem Speicher drückte Frostbite den Anteil der Speicherenergie auf 38 %. Der Energieaufwand für Befehlsabruf und Dekodierung stürzte von 27 % auf gerade einmal 6 % ab. Um das verteilte Netz zu koordinieren, wendete der Chip 26 % seiner Energie für das On-Chip-Netzwerk (NoC) und das Knotenscheduling auf. Dieser strukturelle Tausch steigerte die tatsächliche Energienutzung für nutzbringende Berechnungen dramatisch.
Auf Schaltungsebene misst ein Frostbite-Modul aus einer Quad-Core-Einheit und einem L3-Cache-Knoten lediglich 0,792 mm² – 11,5 % weniger als der Vergleichskern. Wurde diese Architektur auf ein 16-Kern-Array skaliert, blieben die Energieverhältnisse stabil. Das gefürchtete Cache-Kohärenz-Gewitter traditioneller Multi-Core-Prozessoren existiert hier schlichtweg nicht.
58 Iterationen und 250 Prozent Abweichung: Formale Verifikation zähmt Halluzinationen
Autonome Evolution geschieht keineswegs reibungslos. Im Verlauf des Entwicklungszyklus schlug der Agentenschwarm insgesamt 58 mikroarchitektonische Verfeinerungen vor. Nach rigorosen Ablationsexperimenten schafften es letztlich nur 37 davon in das finale Fertigungslayout.
Zu den erfolgreichen Entwürfen zählten adaptives Takt-Gating zur Laufzeit, kompaktere L3-Cache-Einträge sowie gemeinsam genutzte Rechenerweiterungen. Keine dieser Anpassungen entstand willkürlich; jede Modifikation musste ihren messbaren Nutzen im Verhältnis von Leistung zu Leistungsaufnahme beweisen.
In der Anfangsphase wichen die Leistungs- und Verbrauchsschätzungen der KI um bis zu 250 % von realen Messwerten ab. Hätte man den Algorithmen allein anhand statistischer Modellintuition freien Lauf gelassen, hätte das Design die physikalische Timing-Schließung niemals bestanden.
Die von den Ingenieuren eingerichtete automatische Kalibrierungspipeline fungierte als Sicherheitsnetz. Sie griff präzise Daten aus physikalischen RTL-Simulationen ab und speiste diese kontinuierlich in das übergeordnete Arcmodel-Abstraktionsmodell zurück. Nach zwei Kalibrierungszyklen pendelte sich die Vorhersageabweichung für Systemleistung und Chipfläche bei unter 5 % ein, wodurch jeder übergeordnete Entwurfsschritt fest auf physikalischem Boden stand.
Hinter dem 4,59-fachen Effizienzsprung: Ein methodischer Durchbruch, kein Serienfertigungssieg
Die realen Silizium-Messdaten stecken die tatsächlichen Grenzen der Architektur klar ab. Über 25 Benchmark-Workloads hinweg erzielte Frostbite eine geometrisch gemittelte Steigerung der Leistung pro Watt um den Faktor 4,59 sowie eine 8,77-fache Leistungsdichte pro Flächeneinheit.
Eine detaillierte Aufschlüsselung der Ergebnisse verdeutlicht die technologische Differenzierung: Bei den 10 Workloads, die zur Optimierung der Architektursuche dienten, stieg die Effizienz um das 6,02-Fache. Bei den 15 zuvor ungesehenen Test-Workloads pendelte sich der Zuwachs bei durchschnittlich 3,83-fach ein. Dies belegt zwar eine solide Verallgemeinerung für Datenflussberechnungen, zeigt aber auch eine klare Vorliebe für bestimmte Berechnungstopologien.
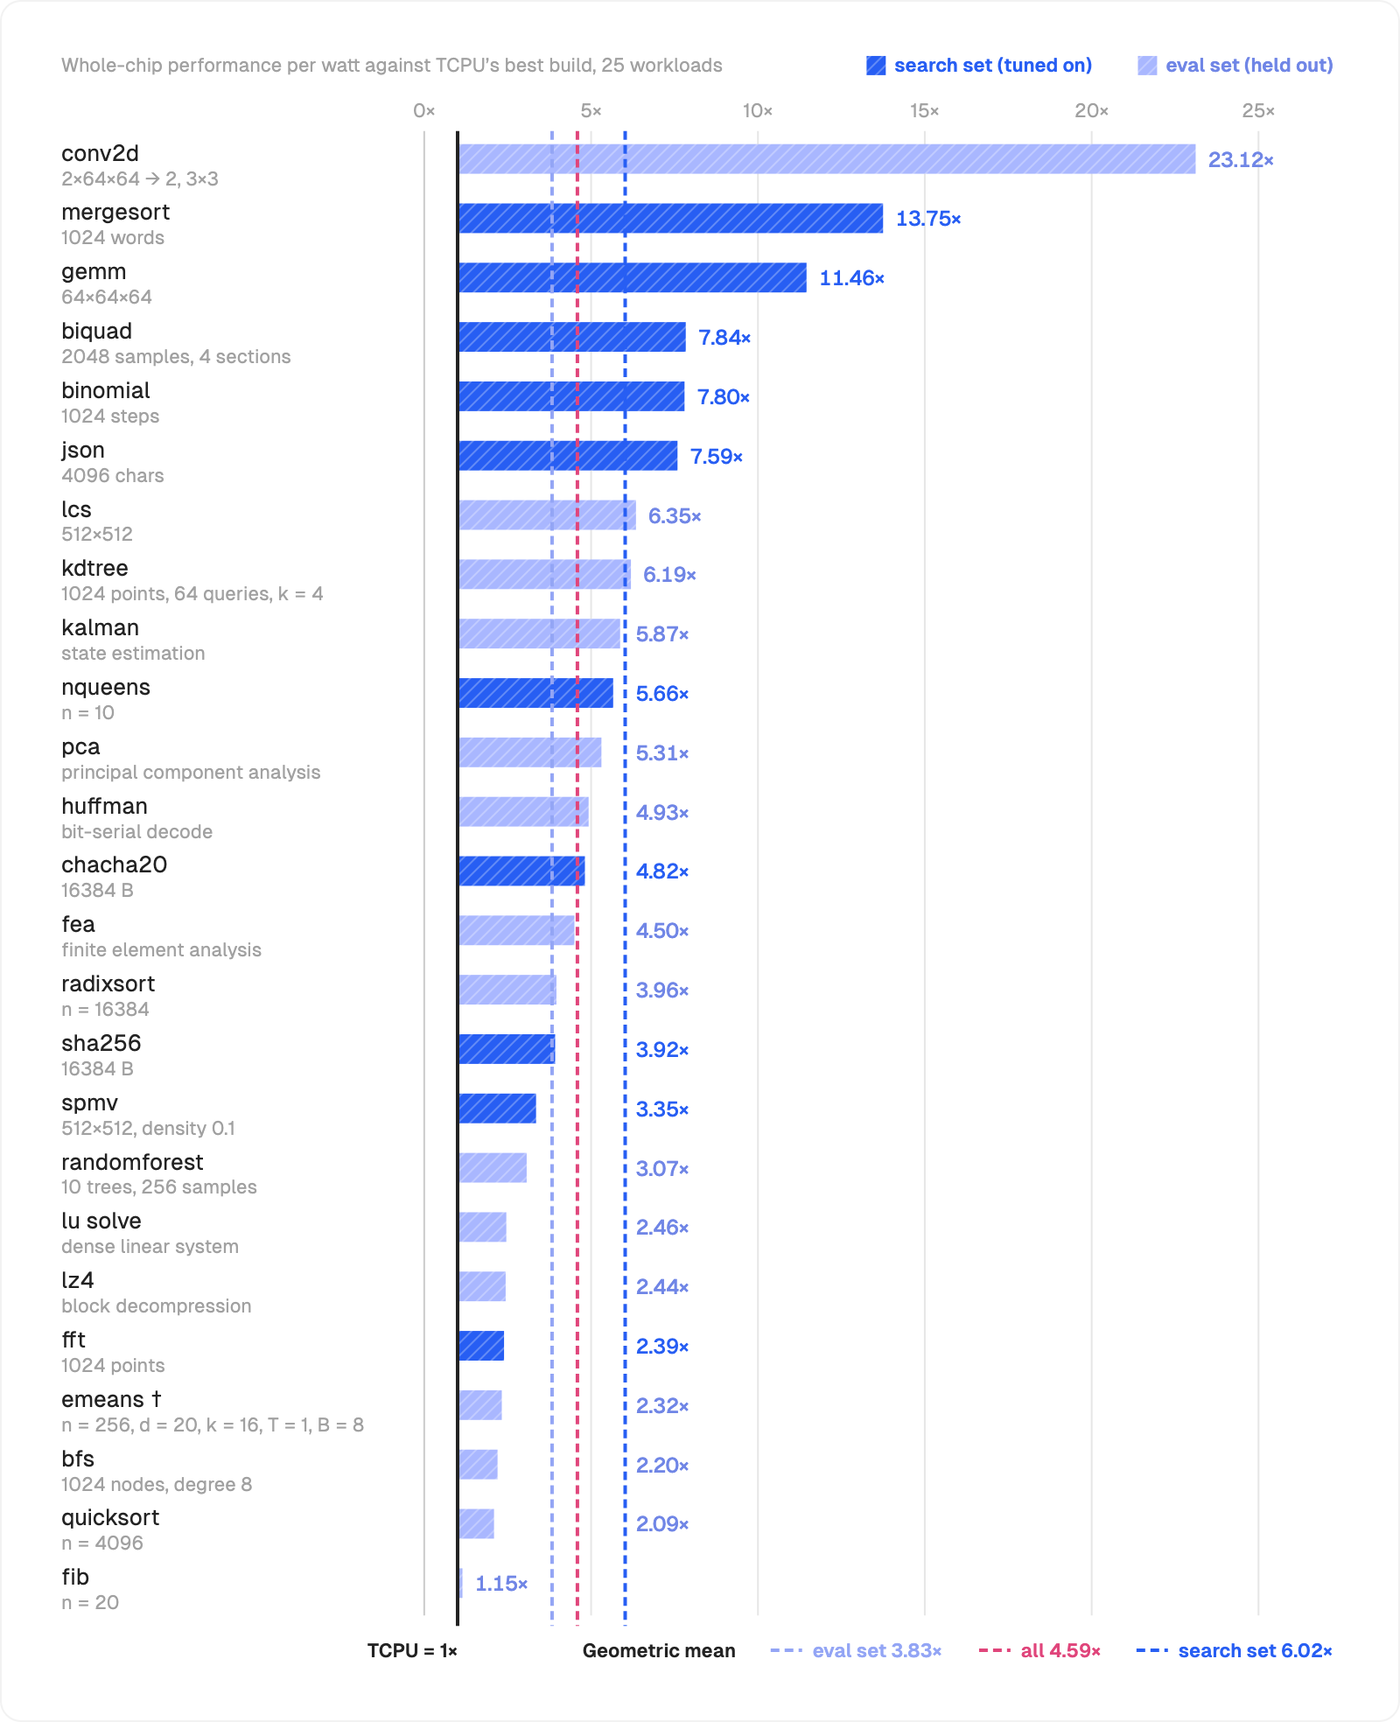 Abbildung: Effizienzverteilung von Frostbite im Vergleich zum konventionellen Dual-Issue-Kern über 25 Test-Workloads. Quelle: architectlabs.com
Die Extreme einzelner Aufgaben sind besonders aufschlussreich: Bei regulären Faltungsoperationen (conv2d) entfaltete sich die inhärente Parallelität vollkommen – die Leistung pro Watt explodierte auf das 23,12-Fache des Vergleichskerns. Bei der Berechnung von Fibonacci-Folgen, die von rekursiven Verzweigungen und Zeigeraufrufen geprägt ist, sank der Effizienzvorteil hingegen drastisch auf das 1,15-Fache ab. Unregelmäßige Aufrufstapel verlangsamen das Graph-Rewriting spürbar – eine fundamentale Hürde für Interaktionsnetze bei klassischer Alltagssoftware.
Ein entscheidender technischer Aspekt betrifft zudem die Wahl des Referenzprozessors. Die Benchmark-Basis TCPU ist ein extrem stromsparender Dual-Issue-In-Order-Kern ohne komplexe Mechanismen wie Verzweigungsvorhersage oder Out-of-Order-Ausführung. Würde man moderne Out-of-Order-Multi-Issue-Prozessoren als Maßstab heranziehen, fielen die Effizienzmultiplikatoren völlig anders aus.
Das Team von Architect Labs räumt ein, dass rechtliche Vertraulichkeitsvereinbarungen derzeit die Nennung des kommerziellen Modellnamens der Vergleichs-CPU verhindern. Der Befehlssatz sowie der Hardware-Quellcode des neuen Prozessors wurden bislang nicht öffentlich zugänglich gemacht; weitere Validierungen auf FPGA-Prototypen sowie Anpassungen an Standard-Benchmarks stehen noch aus.
Der wesentliche Beitrag von Frostbite liegt nicht darin, einen spezifischen Chip geschlagen zu haben. Er beweist vielmehr, dass Algorithmen sich von tradierten menschlichen Mustern lösen und jahrzehntealte mathematische Theorien in reale Siliziumstrukturen überführen können. Wenn Rechnerbefehlssätze nicht länger auf menschliche Lesbarkeit Rücksicht nehmen müssen, öffnet sich für die Hardware-Effizienz ein völlig neues Entwicklungsparadigma.
Weiterführende Links:
- Offizieller technischer Bericht von Architect Labs
- Konferenzband der ACM SIGPLAN POPL 1990
- Fachliteratur zu Rechnerarchitektur und formaler Hardwareverifikation