En noviembre de 2026, el equipo de desarrollo de chips Architect Labs presentó un logro inédito: un enjambre de agentes de IA autónomos diseñó desde cero una CPU funcional completa. Durante todo el proceso de I+D, ningún ingeniero humano intervino con directrices de microarquitectura; los algoritmos dedujeron de manera independiente la totalidad de los detalles arquitectónicos del procesador.
Bajo un nodo de proceso de 7nm, el chip bautizado con el nombre en clave Frostbite generó su diseño físico definitivo. En un conjunto de 25 cargas de trabajo de referencia, alcanzó un rendimiento por vatio 4,59 veces superior al de un núcleo tradicional de ejecución en orden y doble emisión (dual-issue). Aunque esa cifra de eficiencia energética evoca escenarios de ciencia ficción, la realidad ingenieril exige serenidad. El núcleo de referencia TCPU ocupaba un área de apenas 0,895 mm² y las pruebas se limitaron a 25 tareas. Se trata de una exploración temprana sobre metodología computacional, lejos de una victoria comercial en producción masiva.
El verdadero valor del proyecto radica en haber reestructurado el flujo de diseño de semiconductores. La base computacional que durante décadas estuvo atada a los hábitos y la intuición humana fue, por primera vez, reescrita por completo mediante algoritmos.
La IA asume el diseño arquitectónico: ni una sola línea de instrucciones humanas
Architect Labs había presentado anteriormente el proyecto Redwood. En aquel modelo, los expertos humanos fijaban la arquitectura de hardware mientras la IA se encargaba de la implementación de circuitos, la verificación formal y el despliegue. Con Frostbite, el equipo decidió prescindir de los esquemas humanos preestablecidos. Los agentes de IA comenzaron a explorar directamente topologías computacionales concebidas por y para algoritmos.
En las fases iniciales, el enjambre de agentes entregó un documento de diseño de 141 páginas que detallaba el modelo de programación, el sistema de ejecución (runtime) y los módulos de alto nivel. Sin embargo, al carecer inicialmente de restricciones físicas de fabricación, las estimaciones desafiaban las leyes de la física. En cuanto se materializó la primera versión del código de circuitos, tuvo que ser descartada por completo.
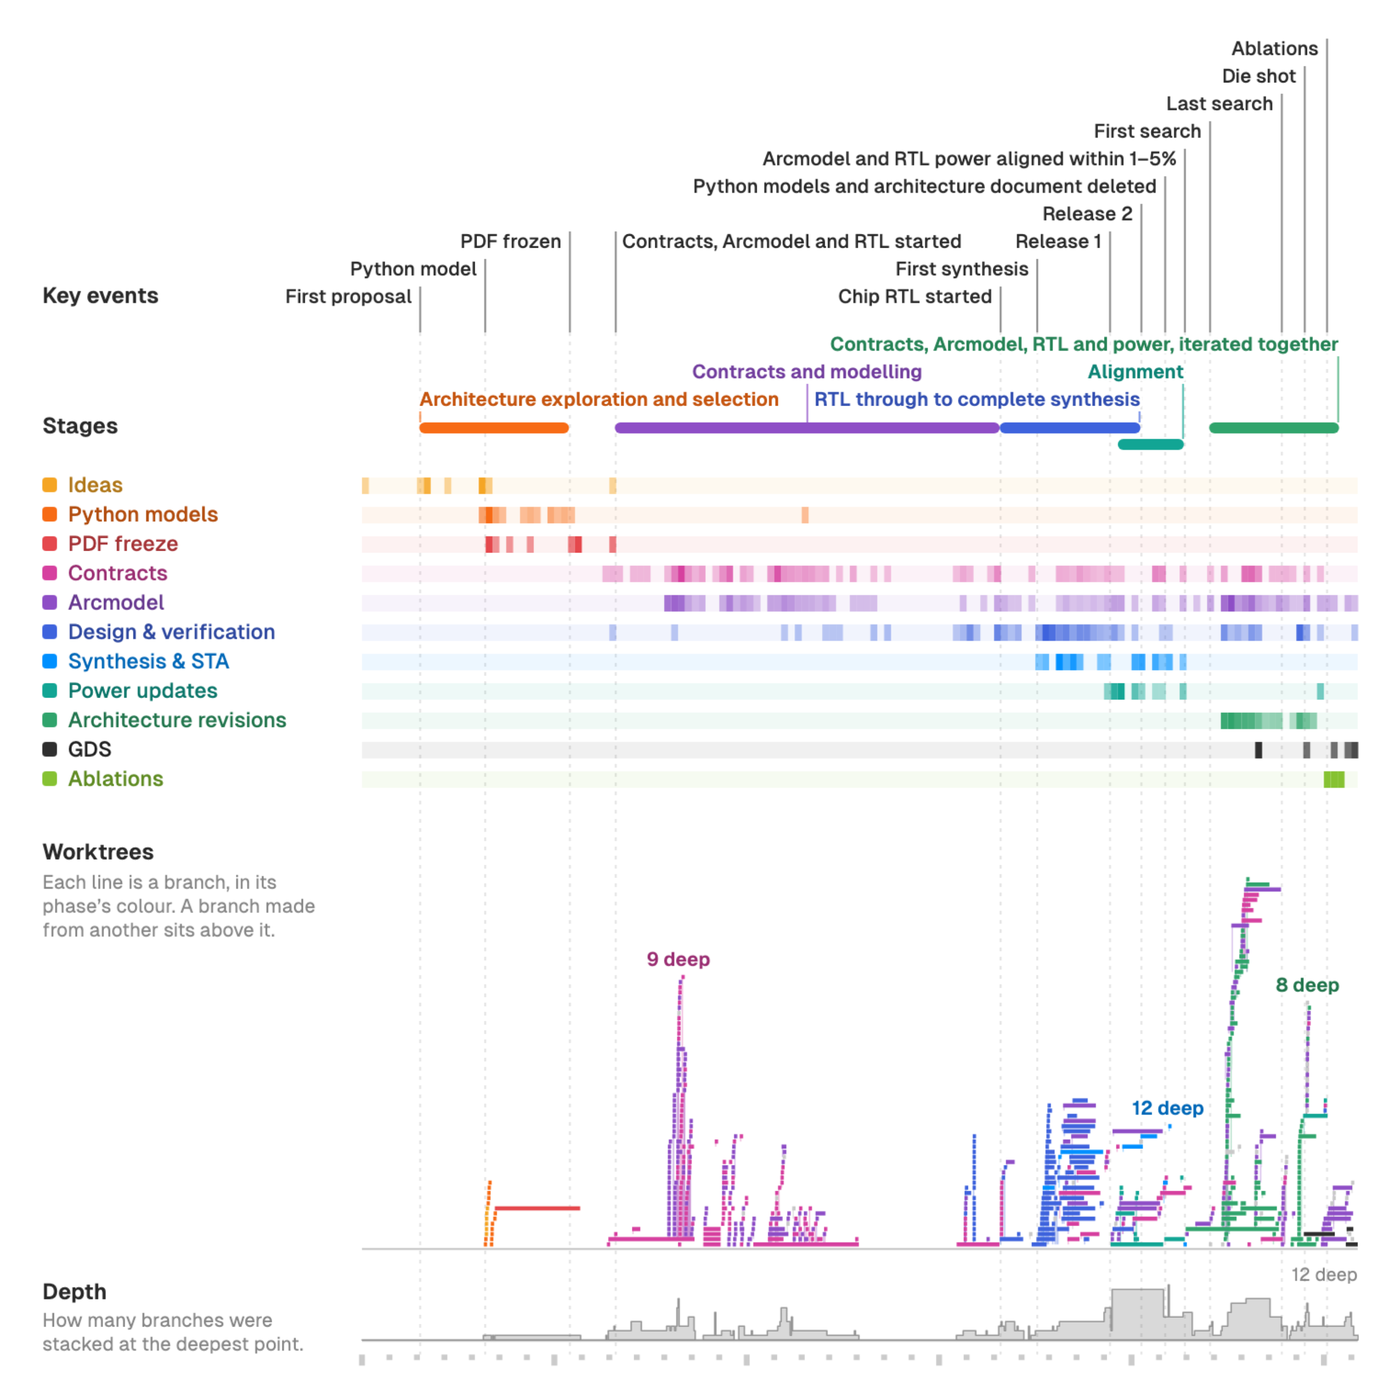 Figura: Cronología completa de desarrollo desde la propuesta inicial de arquitectura hasta la ablación final. Fuente: architectlabs.com
El equipo de ingeniería no retrocedió hacia la optimización manual tradicional. En su lugar, construyeron para la IA un modelo formal de sistema de alto nivel llamado Arcmodel. Dicho modelo simulaba el comportamiento del hardware unas 200 veces más rápido que la simulación a nivel de circuito, con un margen de error estrictamente controlado por debajo del 5%. Todo el modelo se formalizó en más de 800.000 líneas de contratos matemáticos en Lean, cerrando cualquier resquicio lógico desde su raíz formal.
Redes de interacción tras 36 años de letargo: la mitad de la energía tradicional se pierde rastreando dependencias
La extraordinaria eficiencia energética de Frostbite obedece a un cambio radical en el modelo matemático subyacente. Las CPU convencionales de propósito general se rigen por la arquitectura de von Neumann y procesan flujos lineales de instrucciones. Para exprimir el paralelismo, el hardware sacrifica millones de transistores en tiempo de ejecución para predecir dependencias de datos, mientras que los diseños multinúcleo deben mantener la ilusión de una memoria compartida a costa de un sincronismo de caché carísimo.
En el núcleo de referencia TCPU, descontando el consumo de la red de distribución de reloj, el acceso a la jerarquía de memoria caché absorbió el 57% de la energía total. La captura (fetch), decodificación y emisión de instrucciones consumió otro 27%. Ambas etapas sumaron el 84% de la energía consumida, dejando una porción insignificante para las operaciones aritméticas reales.
El científico informático francés Yves Lafont presentó la teoría de las redes de interacción (interaction nets) en el congreso POPL de 1990. En este marco, un programa deja de ser una secuencia lineal de instrucciones para convertirse en un grafo de nodos interconectados. El cálculo consiste simplemente en la reescritura local de pares de nodos activos adyacentes.
Cada nodo posee un único puerto principal. Los pares de nodos activos jamás se superponen en el espacio del grafo. Por consiguiente, el orden de reescritura no altera en absoluto el resultado final, otorgando un paralelismo pleno libre de condiciones de carrera por definición. Además, cada valor de datos se consume exactamente una vez (lógica lineal), liberando al hardware de la necesidad de gestionar estados de memoria compartida.
Este modelo matemático permaneció relegado a la literatura teórica durante 36 años. Los programadores humanos están habituados al paradigma imperativo de arriba abajo; casi nadie deseaba diseñar sistemas complejos mediante reglas de reescritura de grafos. Los agentes de IA no arrastran esos sesgos cognitivos: los algoritmos compilaron representaciones intermedias orientadas a grafos directamente a silicio, esquivando las canalizaciones convencionales.
Aprendizaje autónomo de planificación: el robo de trabajo reduce el gasto de memoria un 20%
Al eliminar la complejidad de los planificadores fuera de orden, Frostbite adoptó una morfología física completamente distinta a nivel de hardware. Cada unidad de cálculo prescinde de un controlador centralizado para la asignación de tareas. Los núcleos operan de manera autónoma siguiendo tres reglas locales minimalistas.
Cada unidad de cómputo procesa preferentemente los nodos activos de su propia cola. En cuanto su cola se vacía, solicita activamente carga de trabajo a las unidades vecinas (robo de trabajo o work-stealing). Si todos los nodos contiguos carecen de tareas transferibles, la unidad desconecta de inmediato su reloj local y pasa a estado de reposo. Este mecanismo de planificación distribuida basado en estados locales no fue programado en las instrucciones humanas: surgió espontáneamente de las deducciones arquitectónicas del enjambre.
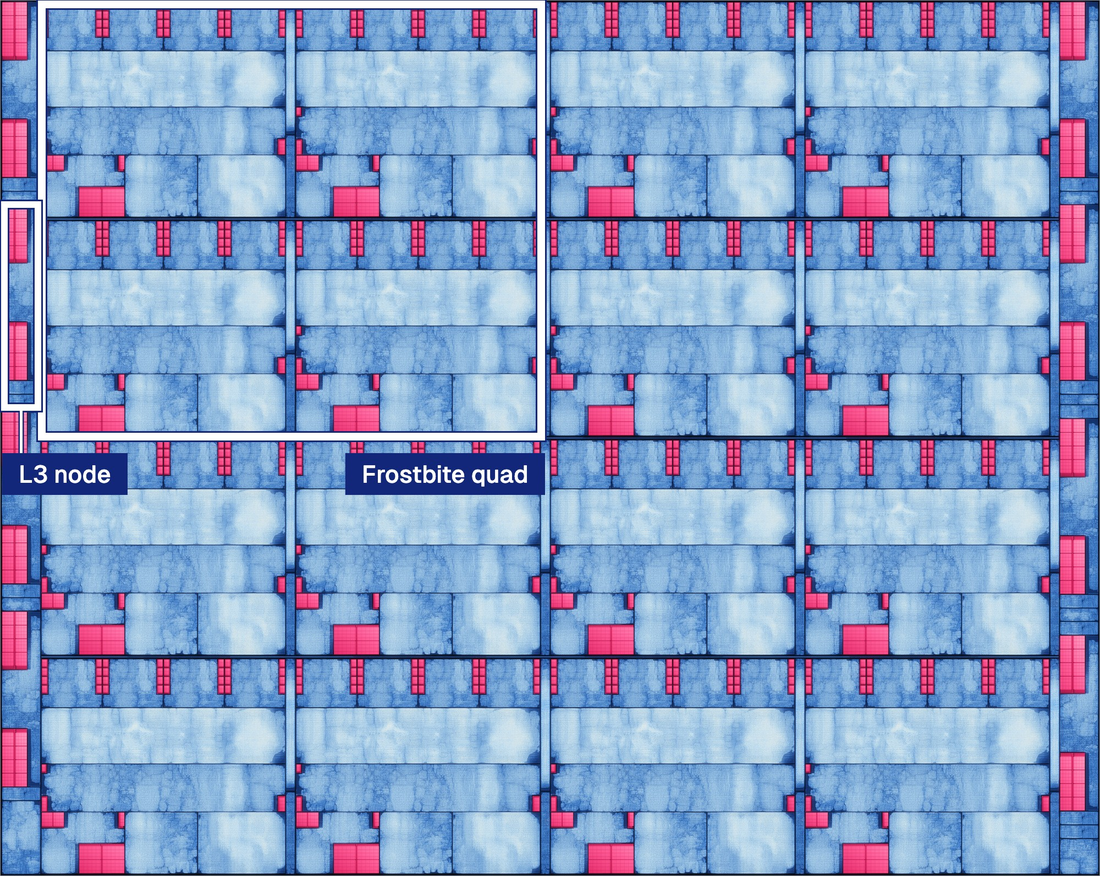 Figura: Diseño físico en proceso de 7nm; el recuadro rojo señala una unidad de cuatro núcleos y un nodo de caché L3. Fuente: architectlabs.com
Gracias a un flujo de datos explícito y a un almacenamiento estrictamente localizado, Frostbite redujo la proporción de energía dedicada al acceso a memoria al 38%. El gasto derivado de la captura y decodificación cayó del 27% a apenas un 6%. Para sostener la malla distribuida, el chip asignó el 26% de su energía a la red interconectada en chip (NoC) y a la planificación de nodos. Este intercambio estructural elevó sustancialmente el aprovechamiento energético para el cálculo útil.
En el plano físico, un módulo de Frostbite integrado por cuatro núcleos y un nodo de caché L3 ocupa tan solo 0,792 mm², un 11,5% menos que el núcleo de referencia. Al escalar esta arquitectura en una matriz de 16 núcleos, las proporciones de consumo energético se mantuvieron estables. Las tormentas de coherencia de caché que asolan el escalado de los procesadores multinúcleo convencionales desaparecen por completo.
58 iteraciones y un 250% de error: la verificación formal contiene las alucinaciones
La evolución autónoma no equivale a magia sin obstáculos. A lo largo del ciclo de desarrollo, el clúster de agentes formuló 58 propuestas de microarquitectura. Tras rigurosos experimentos de ablación, solo 37 fueron incorporadas al diseño físico final.
Las modificaciones aprobadas abarcaron técnicas de desconexión de reloj en tiempo de ejecución (clock gating), entradas de directorio de caché L3 optimizadas y unidades de extensión compartidas. Ningún cambio obedeció al azar; cada variación demostró una mejora neta medida de extremo a extremo en rendimiento por vatio.
En las etapas tempranas, las estimaciones de rendimiento y consumo formuladas por la IA divergieron hasta en un 250% respecto a los datos empíricos. Dejar a los modelos operar exclusivamente bajo su intuición estadística habría impedido el cierre temporal físico de los circuitos.
La infraestructura de calibración automática construida por los ingenieros sirvió de salvavidas. El sistema recopilaba de forma autónoma los datos precisos de las simulaciones físicas a nivel RTL y los reintroducía para calibrar el modelo abstracto Arcmodel. En solo dos rondas de ajuste, la desviación en consumo y superficie se redujo a menos del 5%, garantizando que cada exploración de alto nivel descansara sobre la realidad del silicio.
Detrás del factor de 4,59x: un salto metodológico antes que un triunfo de fabricación
Las mediciones directas sobre el silicio delimitan las fronteras reales de esta arquitectura. En las 25 cargas de prueba, Frostbite logró una mejora media geométrica de 4,59 veces en rendimiento por vatio, multiplicando por 8,77 el rendimiento por unidad de superficie frente a su competidor.
Al desglosar el comportamiento según la carga de trabajo, la diferenciación técnica resulta evidente. En las 10 tareas utilizadas para guiar la búsqueda arquitectónica, el salto de eficiencia energética alcanzó las 6,02 veces. Sin embargo, en las 15 tareas de validación independiente que la IA jamás había visto, la mejora promedio se moderó a 3,83 veces. Esto confirma ventajas generalizadas para el procesamiento de flujo de datos, pero denota una clara preferencia hacia patrones estructurales específicos.
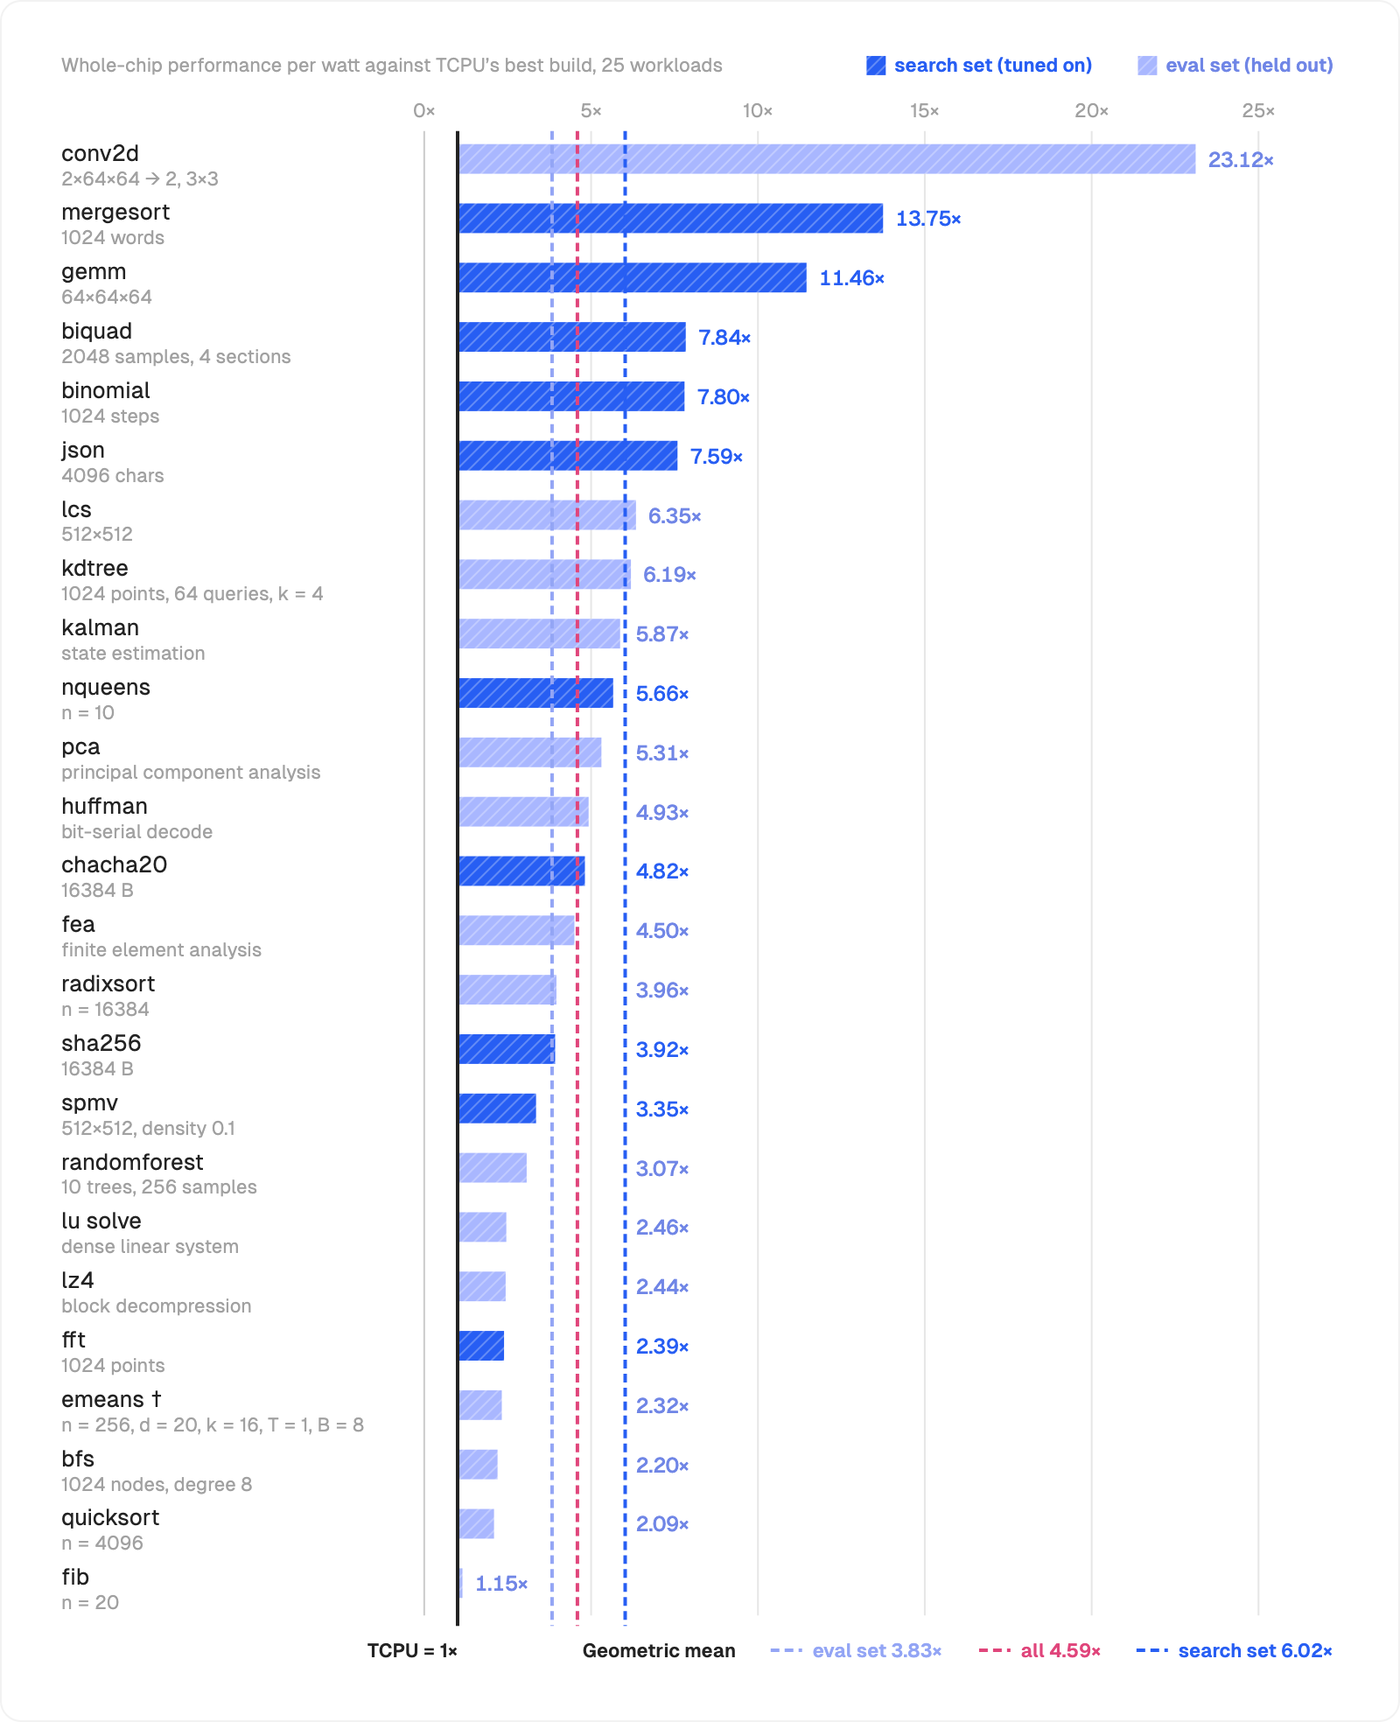 Figura: Distribución de la eficiencia energética de Frostbite frente al núcleo dual-issue convencional en 25 cargas de prueba. Fuente: architectlabs.com
Las discrepancias entre tareas concretas resultan esclarecedoras. En operaciones matriciales regulares (conv2d), el paralelismo masivo se desplegó sin trabas, disparando el rendimiento por vatio hasta 23,12 veces el del rival. Por el contrario, en algoritmos como la sucesión de Fibonacci, repletos de ramificaciones recursivas e indirecciones de punteros, la ventaja se redujo drásticamente a 1,15 veces. Las pilas de llamadas irregulares ralentizan el ritmo de reescritura del grafo, poniendo de manifiesto por qué las redes de interacción no pueden asumir con igual destreza cualquier software imperativo tradicional.
Otro matiz indispensable es la elección del procesador de contraste. El TCPU de referencia es un núcleo ultra eficiente de emisión en orden sin mecanismos pesados como predictores de saltos ni ejecución fuera de orden. Frente a un procesador moderno fuera de orden y con múltiples canales de emisión, las magnitudes de eficiencia diferirían sensiblemente.
Architect Labs explicó que los acuerdos de confidencialidad impiden divulgar el modelo comercial exacto del procesador de prueba. Ni el conjunto de instrucciones ni el código fuente del hardware han sido liberados públicamente por el momento; todavía restan por delante la validación en prototipos FPGA y la adaptación a baterías de pruebas estándar.
La verdadera aportación de Frostbite no estriba en superar a un procesador en particular. Su trascendencia reside en haber demostrado que los algoritmos pueden emanciparse del bagaje cognitivo humano para convertir teorías matemáticas olvidadas en realidades físicas viables. Cuando los repertorios de instrucciones dejen de supeditarse a la lectura humana, la eficiencia del hardware emprenderá rumbos hasta ahora insospechados.
Enlaces de referencia:
- Informe técnico oficial de Architect Labs
- Actas de las conferencias ACM SIGPLAN POPL 1990
- Literatura sobre arquitectura de computadores y verificación formal de hardware