2026年11月、チップ研究開発チームのArchitect Labsが驚くべき成果を発表した。自律的に協調するAIエージェント群が、人間のマイクロアーキテクチャ指示を一切受けることなく、ゼロから動作可能なCPUを設計し切った。アルゴリズム自身の手で、プロセッサの全アーキテクチャ詳細が導出された。
7nmプロセスでテープアウトされたこのチップ(コードネーム「Frostbite」)は、物理レイアウトを出力し、25種類のベンチマーク負荷において従来の2イシュー・インオーダーコアと比較して4.59倍のワットパフォーマンス(電力効率)を実測で記録した。この数字だけを見るとSFのように思えるが、工学的な現実はもっと冷静だ。比較対象のTCPUコアの面積はわずか0.895mm²であり、検証されたワークロードも25種に限られる。これは商用プロセッサの量産における勝利ではなく、計算手法の黎明期における探求である。
このプロジェクトの本質的な価値は、チップ設計のプロセスそのものを再構築した点にある。長きにわたり人間の認知の癖に縛られてきた計算の土台が、初めてアルゴリズムによって根本から書き直されたのだ。
AIがアーキテクチャ設計を主導:人間は命令コードを1行も書かなかった
Architect Labsはこれ以前に「Redwood」プロジェクトを手がけていた。当時は人間の専門家がハードウェアアーキテクチャを決定し、AIは回路の実装・検証・デプロイを担当していた。しかしFrostbiteでは、人間の事前設計を完全に排除した。AIエージェント自身が、アルゴリズムにとって最適な計算トポロジーの探索に直接乗り出した。
探索初期、エージェント群は141ページに及ぶ設計文書を提出した。プログラミングモデル、ランタイムシステム、上位モジュール設計が網羅されていたが、物理プロセスの制約を欠いていたため、初期の見積もりは物理法則から大きく乖離していた。第1世代の回路コードは実装直後にすべて破棄されることになった。
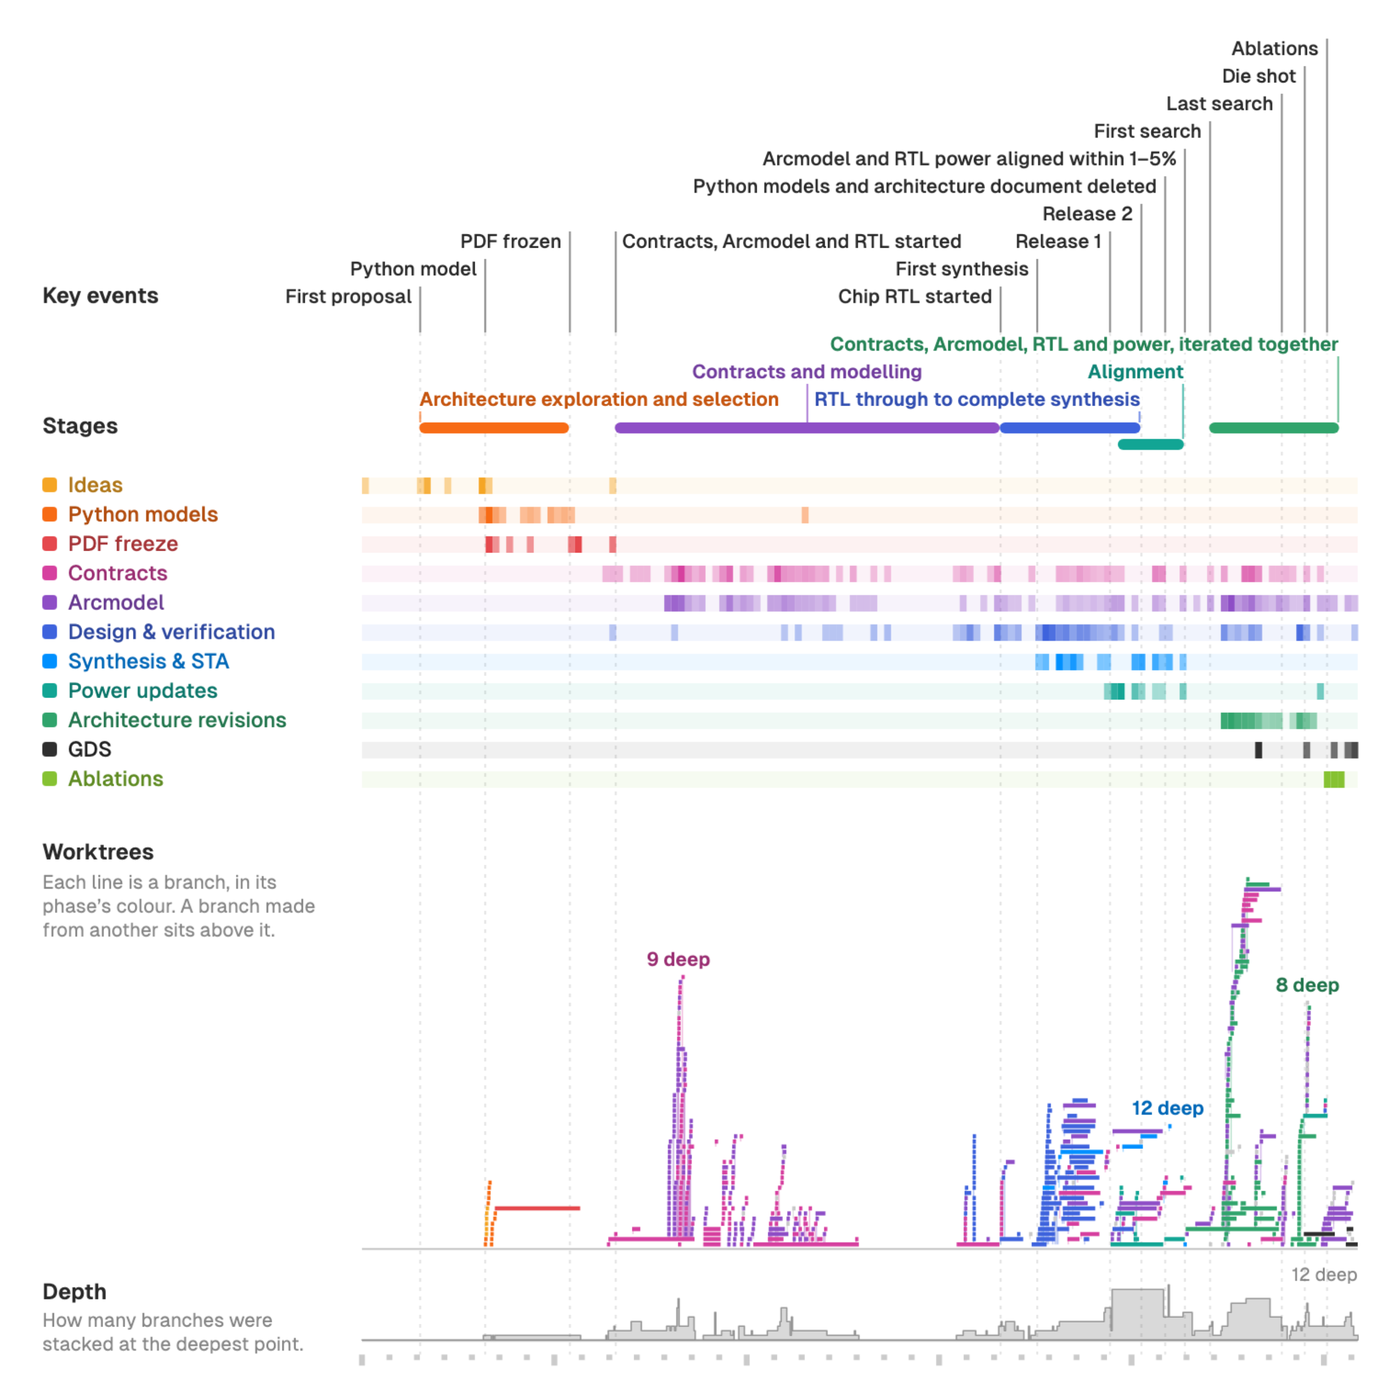 図:最初のアーキテクチャ提案から最終的なアブレーションまでの開発タイムライン。出典:architectlabs.com
エンジニアリングチームは昔ながらの手動チューニングに戻るのではなく、AI向けに「Arcmodel」と呼ばれる上位形式システムモデルを構築した。このモデルは低レベルの回路シミュレーションより約200倍高速に動作し、システム予測誤差は5%以内に厳密に抑えられた。さらにモデル全体が80万行以上のLeanによる数学的契約へと落とし込まれ、論理的な欠陥が根本から形式的に排除された。
36年間眠っていた相互作用ネット:従来のチップの電力の半分は依存関係の追跡に消えていた
Frostbiteが高いエネルギー効率を達成できた最大の理由は、根底にある計算の数学モデルを刷新したことにある。現代の汎用CPUはフォン・ノイマン型アーキテクチャを採用し、直列的な命令列を処理する。ハードウェアは並列性を引き出すために、実行時に大量のトランジスタを動かして依存関係を推測しなければならず、マルチコアでは共有メモリの整合性を維持するために膨大なキャッシュ同期コストを支払っている。
ベースラインの2イシューコア「TCPU」では、クロックツリーの電力を除外すると、マルチレベルキャッシュのメモリ参照がエネルギーの57%を消費していた。さらに命令フェッチ、デコード、イシューが27%を占めており、これら2項目だけで全体の84%に達する。純粋な算術演算に使われる電力はごくわずかに過ぎなかった。
フランスの計算機科学者Yves Lafontは、1990年のPOPL会議ですでに「相互作用ネット(Interaction Nets)」理論を提唱していた。相互作用ネットの世界では、プログラムは線形な命令シーケンスではなく、ノードが結合したグラフとして表現される。計算は、グラフ内で接続された活性ノードペアの局所的な書き換えによって進行する。
各ノードには主ポートが1つしか存在せず、活性化状態のノードペア同士が空間的に重なり合うことはない。そのため、グラフ書き換えの順序が最終結果に影響を与えることはなく、原理的に完全な並行性を備えている。さらに各データ値は一度しか使われないため、ハードウェア上で共有メモリ状態を維持する必要が全くない。
この数学モデルは36年間、学術論文の奥深くに眠っていた。人間のプログラマーは上意下達の命令型コードに慣れ親しんでおり、グラフ書き換えの思考で大規模システムを組む者は稀だった。しかしAIエージェントにはその思考の先入観がない。アルゴリズムはグラフ計算向けの中間表現(IR)を直接クラウドコンパイルし、従来の命令パイプラインを迂回した。
エージェントの自律的なワークスティーリング:メモリアクセス電力を2割削減
複雑なアウトオブオーダー(OoO)スケジューラを排除したことで、Frostbiteはハードウェアとして全く異なる物理構造を持つに至った。各演算ユニットは、中央コントローラからのタスク分配に依存しない。各コアは極めてシンプルな3つのローカルルールに従って自律動作する。
各演算ユニットは、まず自らのキューにある活性ノードを処理する。自身のタスクが空になると、近隣のユニットへ自律的に負荷の分配を要求する(ワークスティーリング)。周辺のユニットにもタスクがない場合、ユニットは直ちにローカルクロックを遮断してスリープに入る。この分散型スケジューリング機構は、人間のプロンプトで指示されたものではなく、エージェントが複数サイクルのアーキテクチャ推論を経て自発的に生み出したものだ。
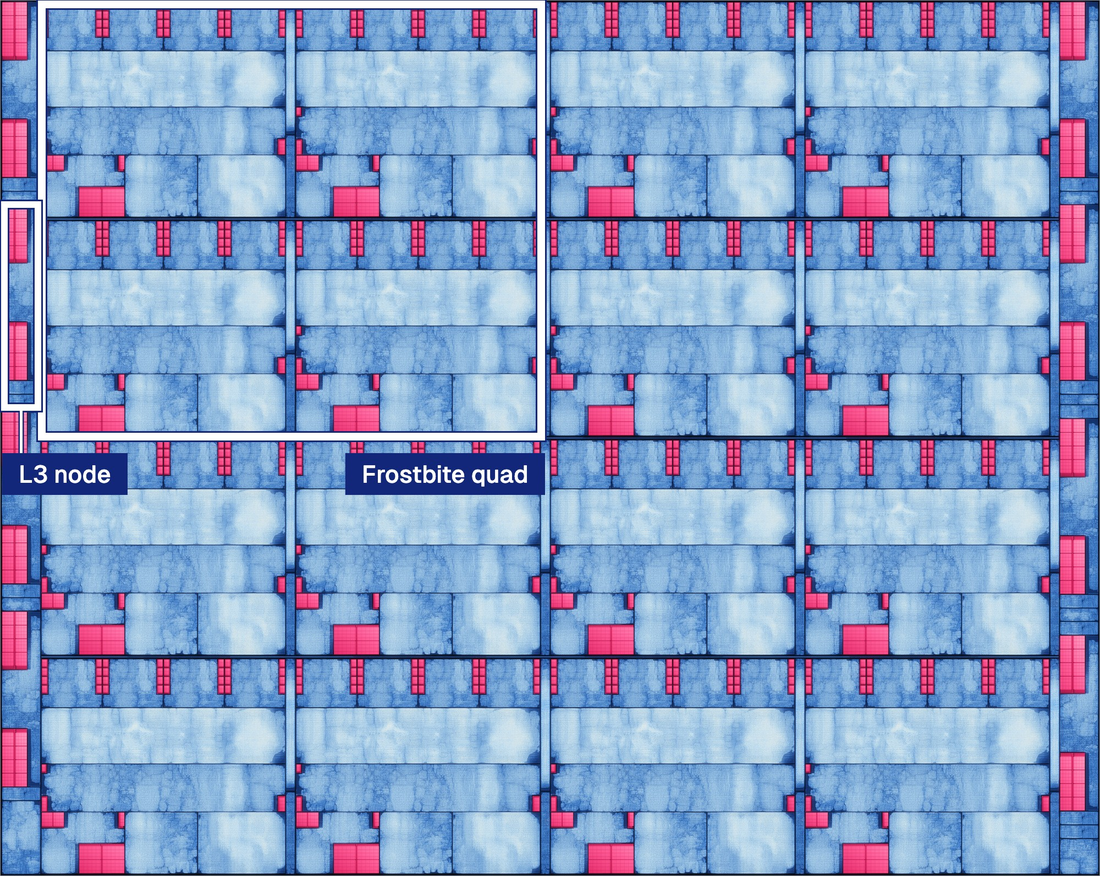 図:7nmプロセスにおける物理レイアウト。赤枠は4コアユニットとL3キャッシュノードを示す。出典:architectlabs.com
明示的なデータフローとローカルストレージにより、Frostbiteはメモリアクセスの電力比率を38%に抑え込んだ。フェッチ・デコードの消費電力も従来の27%からわずか6%へと激減した。分散ネットワークを維持するために、チップ全体のエネルギーの26%がオンチップネットワーク(NoC)とノードスケジューリングに充てられたが、この構造的なトレードオフによって有効計算のエネルギー利用効率は劇的に向上した。
物理実装において、4コアユニットとL3キャッシュノードを含むFrostbiteモジュールの面積は0.792mm²であり、比較対象のコアより11.5%小さかった。このアーキテクチャを16コアのアレイにスケールアウトさせた際も、各モジュールの消費電力比率は安定を維持した。マルチコアの拡張時に常に頭を悩ませてきた「キャッシュコヒーレンシの嵐」は、ここには存在しない。
58回の試行錯誤と250%の誤差:形式検証がアルゴリズムの暴走を抑え込む
自律的な進化は決して無抵抗の魔法ではない。エージェント群は設計サイクル全体で58項目のアーキテクチャ微調整案を提示した。厳密なアブレーション実験を経て、最終的な物理レイアウトに採用されたのは37項目にとどまった。
生き残った設計には、ランタイムクロックゲーティング、高効率なL3キャッシュエントリ、共有拡張ユニットなどが含まれる。これらは当てずっぽうの産物ではなく、すべての変更がエンドツーエンドの電力効率測定を経て決定された。
初期のAIによる性能・電力予測は、実測から最大250%も乖離していた。大規模言語モデル(LLM)の直感だけに任せていれば、生成された回路が物理的なタイミング収束をパスすることは到底不可能だった。
エンジニアが構築した自動キャリブレーションパイプラインが命綱となった。システムはRTL物理シミュレーションの実測データを自動取得し、上位のArcmodel抽象モデルへとフィードバックして再調整を行った。2サイクルの校正を経て、システムレベルの電力および面積の予測偏差は5%以内に収束し、上位の探索はすべて物理的な現実に立脚することとなった。
電力効率4.59倍の裏側:量産の完勝ではなく方法論の突破
シリコンの実測データはこのアーキテクチャの真の境界線を浮き彫りにしている。25種類のベンチマーク負荷において、Frostbiteは相乗平均で4.59倍のワットパフォーマンス向上を達成し、単位面積あたりの性能は競合コアの8.77倍に達した。
負荷ごとの結果を詳細に分析すると、明確な特性が見て取れる。アーキテクチャ探索に用いられた10種類のワークロードでは効率向上が6.02倍に達した一方、AIが一度も目にしたことのない15種類のホールドアウトテストセットでは、平均向上幅は3.83倍にとどまった。これは、本アーキテクチャが汎用計算に対して確かな利得を持ちつつも、特定のデータフロー構造に対して選好性を持つことを示している。
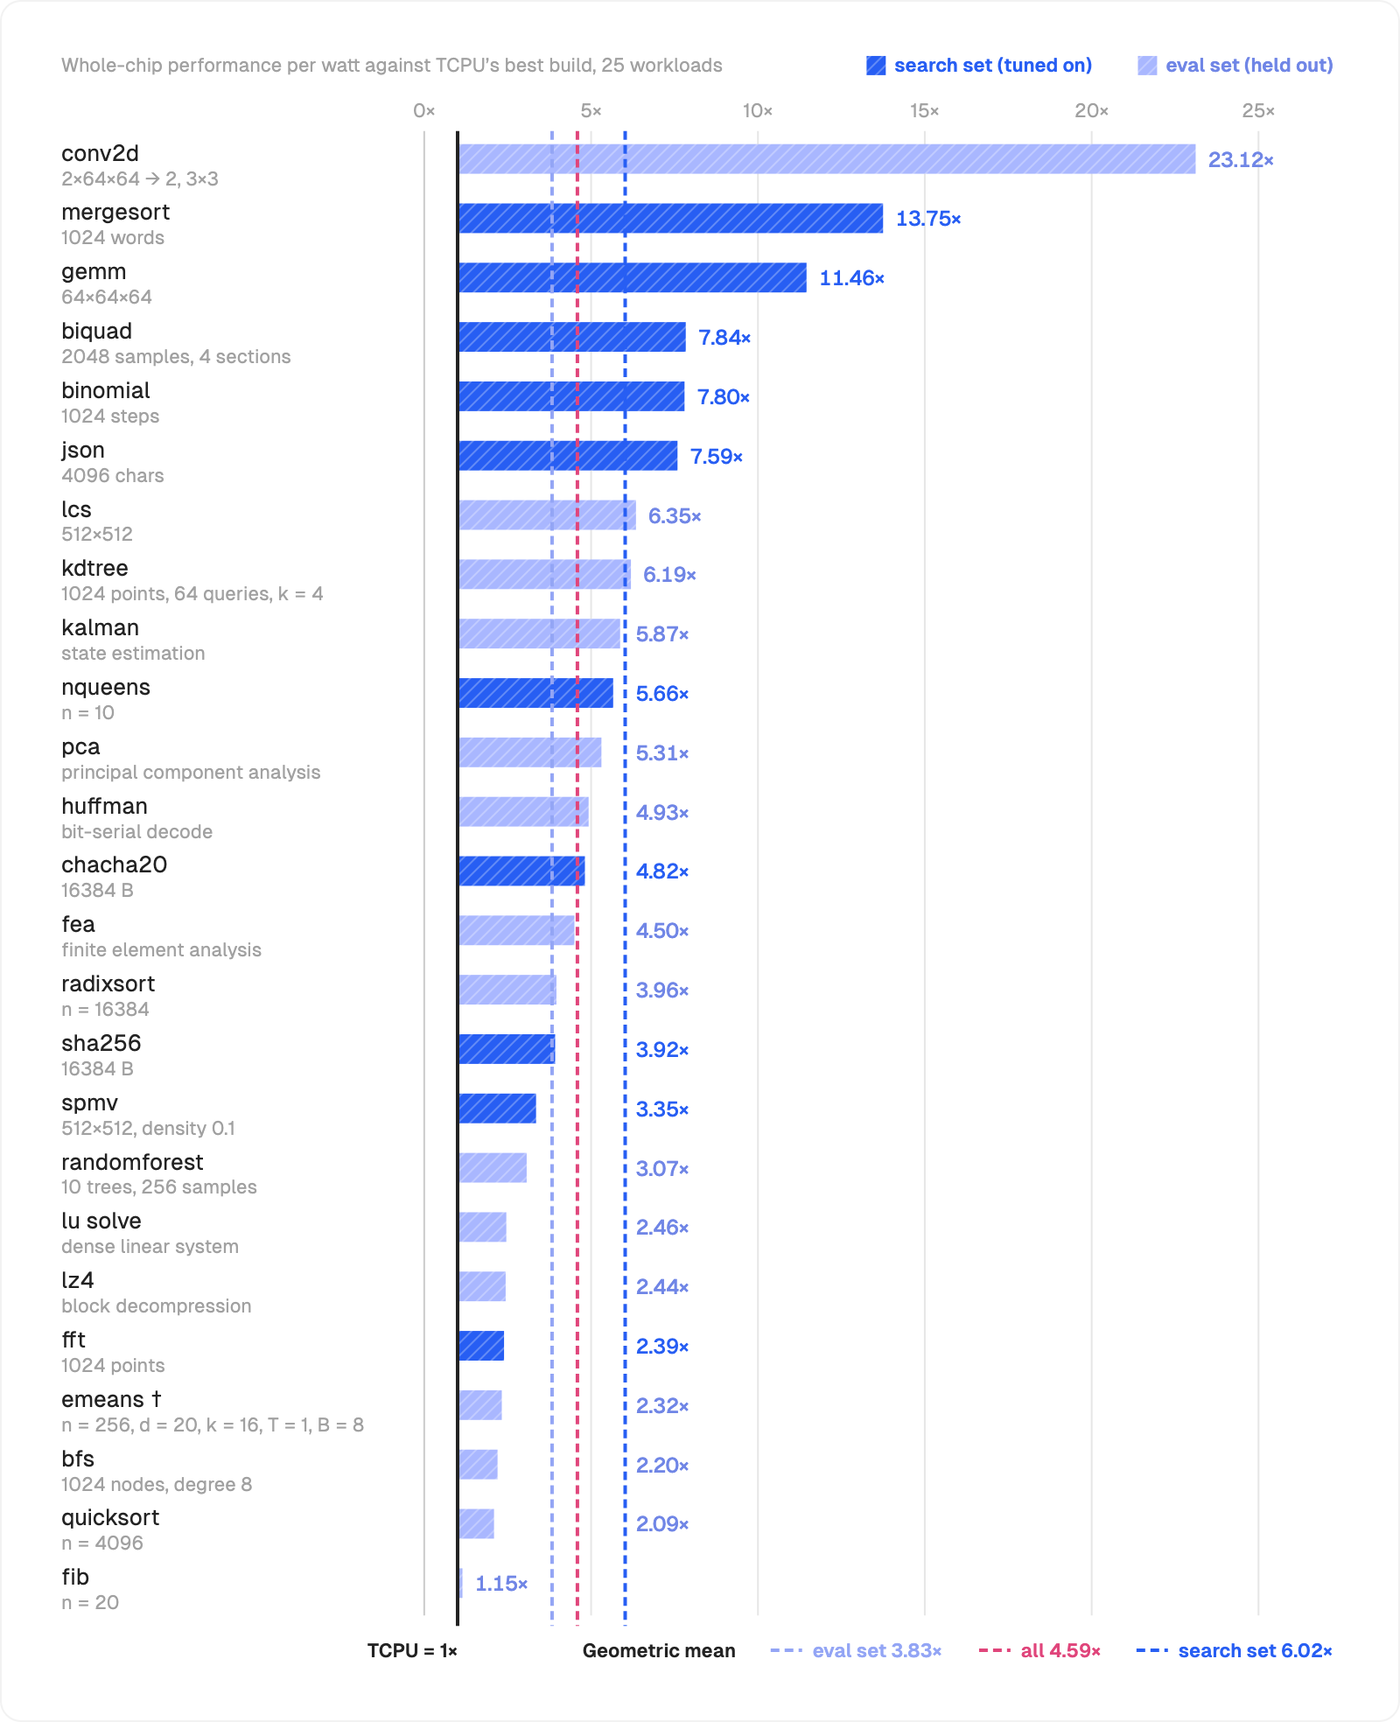 図:25種類のテスト負荷におけるFrostbiteと従来の2イシューコアのエネルギー効率分布。出典:architectlabs.com
タスク単体の乖離はさらに示唆に富んでいる。規則的な行列演算であるconv2dタスクでは並行性が遺憾なく発揮され、ワットパフォーマンスは競合比23.12倍に爆発した。一方で、再帰的分岐やポインタ参照を多用するフィボナッチ数列タスクでは、電力効率の優位性は1.15倍へと急落した。不規則なコールスタックはグラフ書き換え速度を低下させる。これこそが、相互作用ネットがあらゆる汎用ソフトウェアを等しく得意とすることが難しい根本的理由だ。
より重要な工学的背景は、比較対象の選定にある。ベースラインのTCPUは極小消費電力を重視した2イシュー・インオーダーコアであり、分岐予測やアウトオブオーダー実行といった重量級の機構を持たない。もし主流のOoOプロセッサと比較した場合、電力効率の倍率は大きく変化するはずだ。
開発チームは、法的な守秘義務により比較対象プロセッサの商用型番を現時点では公表できないとしている。新型プロセッサの命令セットおよびハードウェアRTLコードは未公開であり、今後FPGAプロトタイピングや標準ベンチマークへの適合を進める必要がある。
Frostbiteの真の意義は、特定の半導体チップを打ち負かしたことにはない。アルゴリズムが人間の経験から脱却し、何十年も眠っていた数学理論を量産可能な物理実体へと再構築できることを証明した点にある。コンピュータの命令セットが人間の読解の都合に合わせる必要がなくなったとき、ハードウェアのエネルギー効率進化には新たな扉が開かれる。
参考リンク:
- Architect Labs 公式技術レポート
- ACM SIGPLAN POPL 1990 会議論文集
- コンピュータアーキテクチャおよびハードウェア形式検証関連文献