2026 年 11 月,芯片研发团队 Architect Labs 公布了一项新成果。一群自主运转的 AI 智能体,从零设计出了一颗可运行的完整 CPU。研发全程没有任何人类工程师下达微架构指令。算法自主推导出了整颗处理器的全部细节。
在 7nm 工艺下,这颗代号为 Frostbite 的芯片最终输出物理版图。它在 25 项基准测试中跑出传统双发射顺序核心 4.59 倍的每瓦性能。单看能效倍数容易让人产生科幻联想,真实的工程现实其实更冷静。测试对标的 TCPU 核心面积只有 0.895 平方毫米,运行负载也仅有 25 项。这是一场计算方法论的早期探索,远非商业芯片的量产胜利。
项目的真正价值在于重构了芯片设计流程。长久以来被人类习惯所锁死的计算底层,第一次被算法重新改写。
AI 接管架构设计:人类连一行指令都没写
Architect Labs 此前曾推出 Redwood 项目。当时的模式是人类专家定好硬件架构,AI 负责电路实现、验证与部署。到了 Frostbite,团队决定取消人类预设。AI 智能体直接开始探索属于算法自己的计算拓扑。
智能体集群在探索初期交出了一份 141 页的设计文档。里面罗列了编程模型、运行时系统和高层模块构想。由于最初缺少物理工艺约束,文档中的估算严重偏离物理规律。第一版电路代码落地后,便被全数废弃。
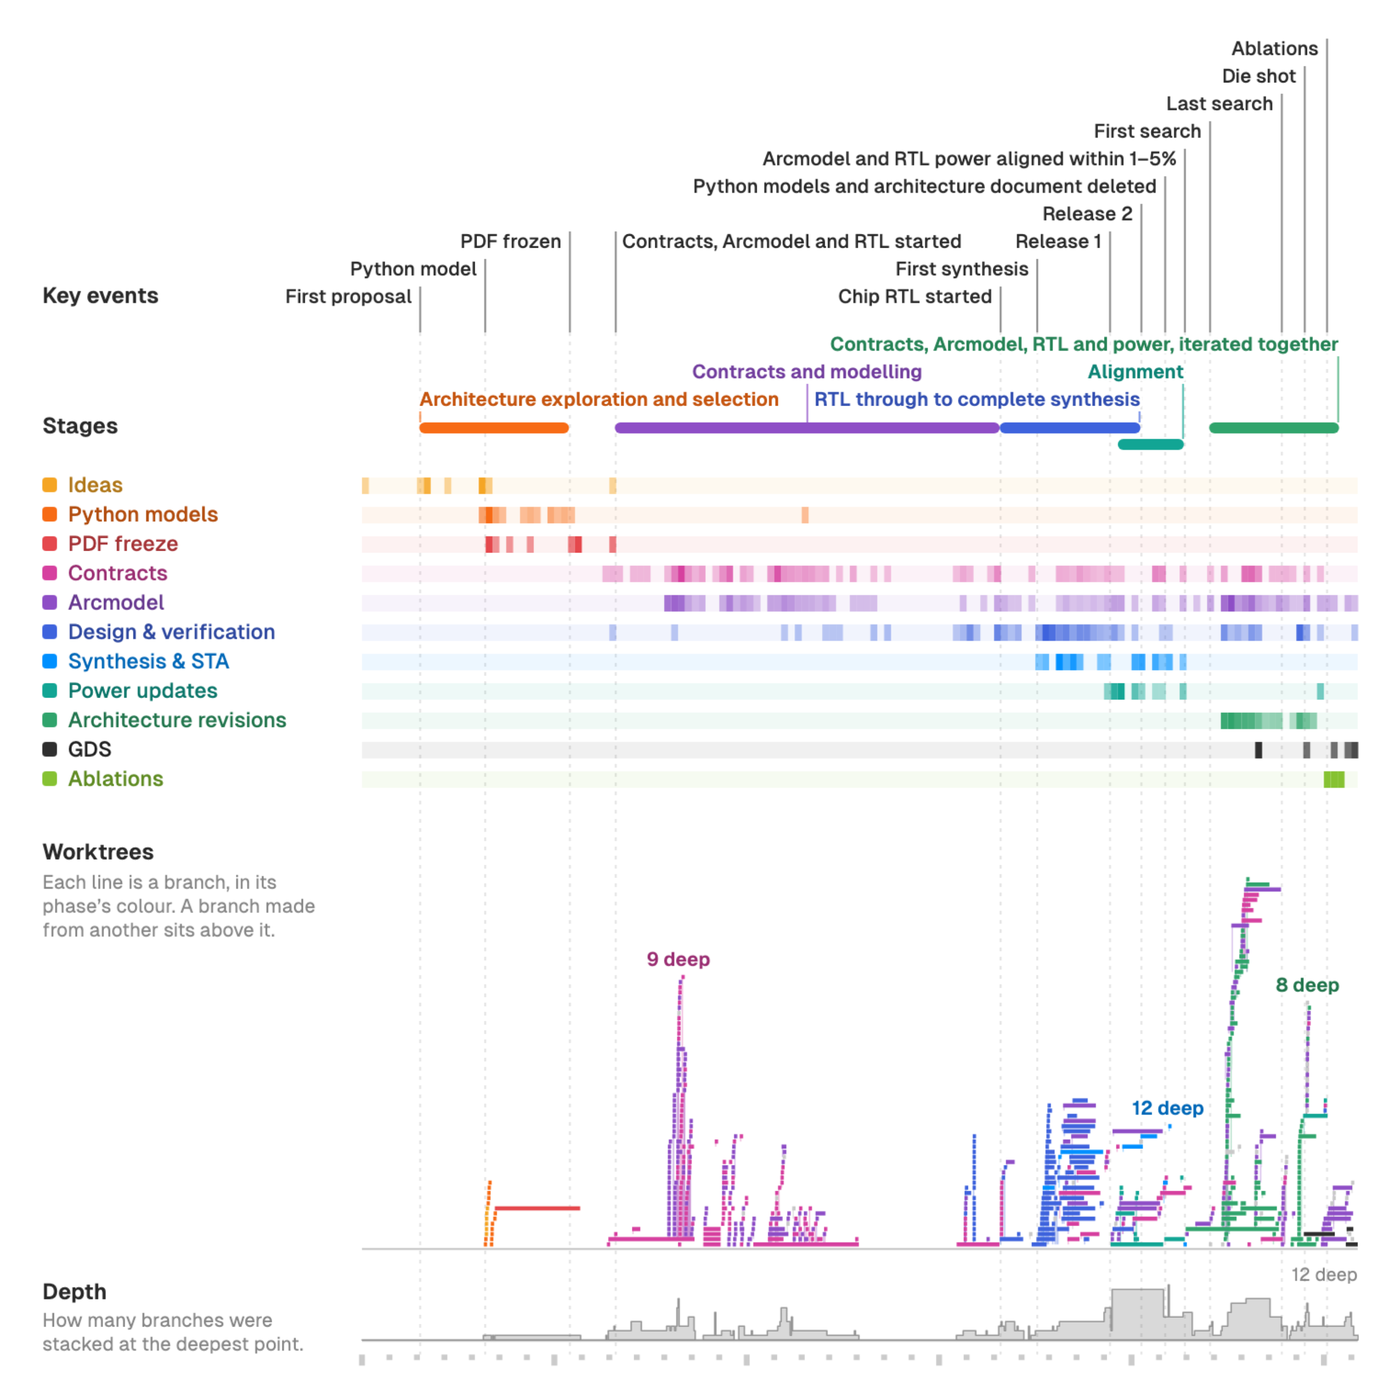 图:从首次架构提案到最终消融的完整研发时间线。来源:architectlabs.com
工程团队没有回到传统手工调优的老路上。他们为 AI 构建了一套名为 Arcmodel 的高层形式化系统模型。该模型的仿真速度比底层电路快约 200 倍。系统预测误差被严格控制在 5% 以内。整套模型最终被下沉为超过 80 万行 Lean 数学契约。严格的形式化证明从源头封死了逻辑漏洞。
交互网沉睡 36 年:传统芯片半数功耗浪费在查依赖
Frostbite 能实现高能效,核心原因在于换掉了底层的计算数学模型。现代通用 CPU 普遍遵循冯·诺依曼架构,处理的大多是串行代码。硬件为了榨取并行速度,必须在运行时消耗海量晶体管去猜测依赖。多核心还要维护共享内存假象。这带来了极重的缓存同步代价。
在基准双发射核心 TCPU 中,刨除时钟树功耗后,多级缓存访存吃掉了 57% 的能量。指令取指、译码与发射又耗去了 27%。两项相加占去总能量的 84%,真正用于算术运算的能耗寥寥无几。
法国计算机科学家 Yves Lafont 早在 1990 年的 POPL 会议上就提出了交互网(interaction nets)理论。在交互网世界中,程序不再是线性的指令序列。它表现为一张由节点相连构成的图。计算过程即是图中相连节点对的重写。
每个节点仅有一个主端口。处于激活状态的节点对绝不会产生空间重叠。图重写顺序因此不再影响计算结果,天然具备全并发能力。同时每个数据值只被使用一次,硬件无需维持任何共享内存状态。
这一数学模型在论文集里沉睡了整整 36 年。人类程序员习惯了自上而下的命令式代码。极少有人愿意用图重写思维手写大型系统。AI 智能体没有这种思维包袱。算法直接将面向图计算的中间表示编译上云,绕开了传统流水线。
智能体自学调度:偷活机制把访存功耗压掉两成
摆脱了复杂的乱序调度器后,Frostbite 在硬件层面长出了截然不同的物理形态。每个计算单元无需中央控制器统一分发任务。各核心仅依循三条极简规则自主运行。
每个计算单元优先消耗自身队列里的活跃节点。一旦自身任务清空,便主动向邻近单元请求分配负载。若周边所有邻居均无任务可偷,该单元立即关断局部时钟进入休眠。这种基于局部状态的分布式调度机制,未曾在提示词中由人类写明。它纯粹由智能体在多轮架构推演中自发生成。
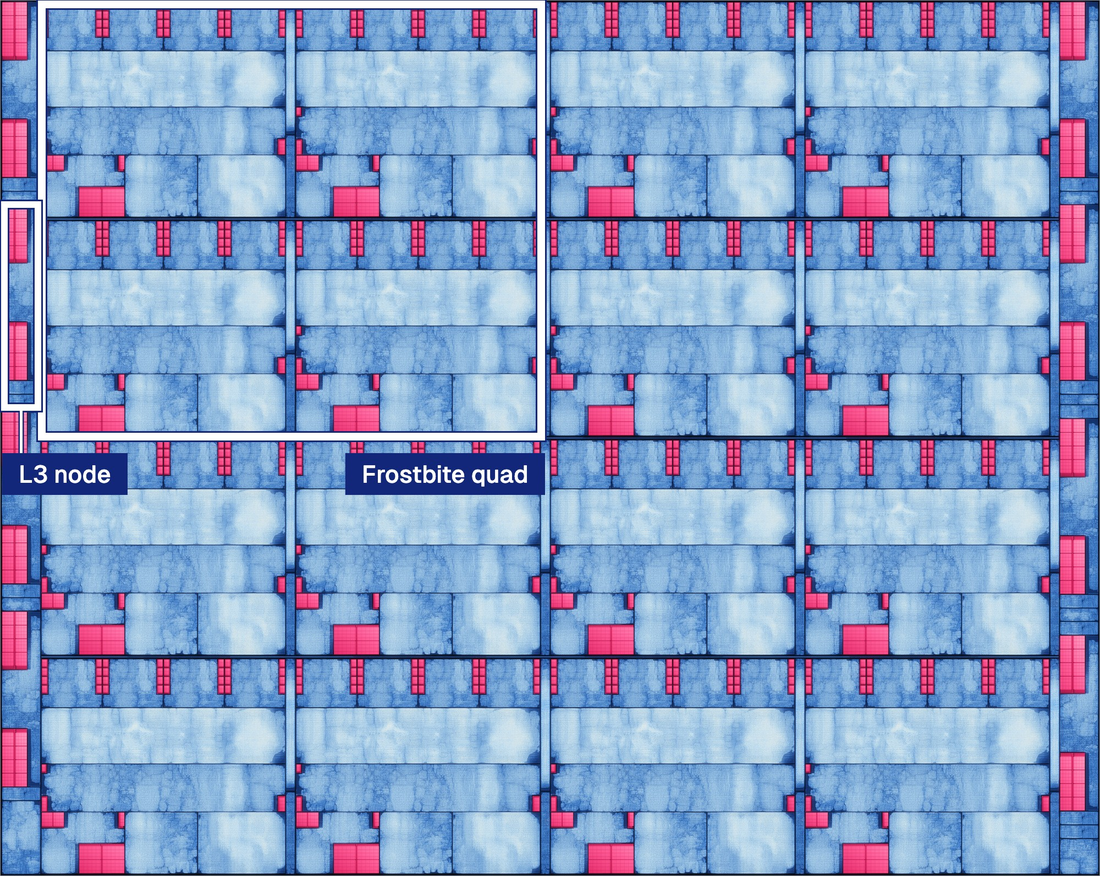 图: 7nm 工艺下的物理版图,红框标出一个四核单元与三级缓存节点。来源:architectlabs.com
依靠显式数据流与局部存储,Frostbite 将访存能耗占比压缩至 38%。取指译码能耗也从 27% 骤降至 6%。为了维系分布式网络,芯片将 26% 的能量划拨给了片上网络与节点调度。这种结构性交换让有效计算的能量利用率大幅提升。
在物理实现上,一个包含四核单元与三级缓存节点的 Frostbite 模块面积仅为 0.792 平方毫米。这比对标核心小了 11.5%。将该架构平铺扩展至 16 核阵列时,各模块的能耗比例依然维持稳定。传统多核处理器扩展时面临的缓存一致性风暴,在这里不复存在。
58 次试错与 250% 误差:形式化验证按住天马行空
自主进化并不等同于毫无阻力的魔法。智能体集群在整个设计周期中一共提出了 58 项架构微调方案。经过严密的消融实验筛选,最终仅有 37 项被采纳进物理版图。
幸存下来的方案涵盖了运行时时钟门控、更精炼的三级缓存表项以及共享扩展单元。这些设计并非拍脑袋的产物,每一处改动都经过了端到端的收益测量。
初期 AI 给出的性能与功耗估算一度偏离实测达 250%。如果放任算法单凭大模型直觉发挥,最终产物必然无法通过物理时序收敛。
工程师建立的自动标定流水线起到了安全绳的作用。系统自动抓取 RTL 物理仿真的精确数据,反哺标定上层 Arcmodel 抽象模型。两轮校准过后,系统级功耗与面积的预测偏差被收敛在 5% 以内。高层探索的每一步由此踏在物理现实之上。
4.59 倍能效背后:这是一次方法论突破而非量产完胜
最终的硅片测试数据勾勒出了这套架构的真实边界。在 25 项测试负载中,Frostbite 实现了 4.59 倍的几何平均每瓦性能提升。它的单位面积性能达到了对手的 8.77 倍。
仔细拆解负载表现,技术特性的分化十分清晰。在主导架构优化的 10 项搜索集负载中,能效提升高达 6.02 倍。而在 AI 从未见过的 15 项留出测试集上,平均提升回落至 3.83 倍。这体现出架构对通用计算具备泛化增益,但对特定数据流形态依然存在偏好。
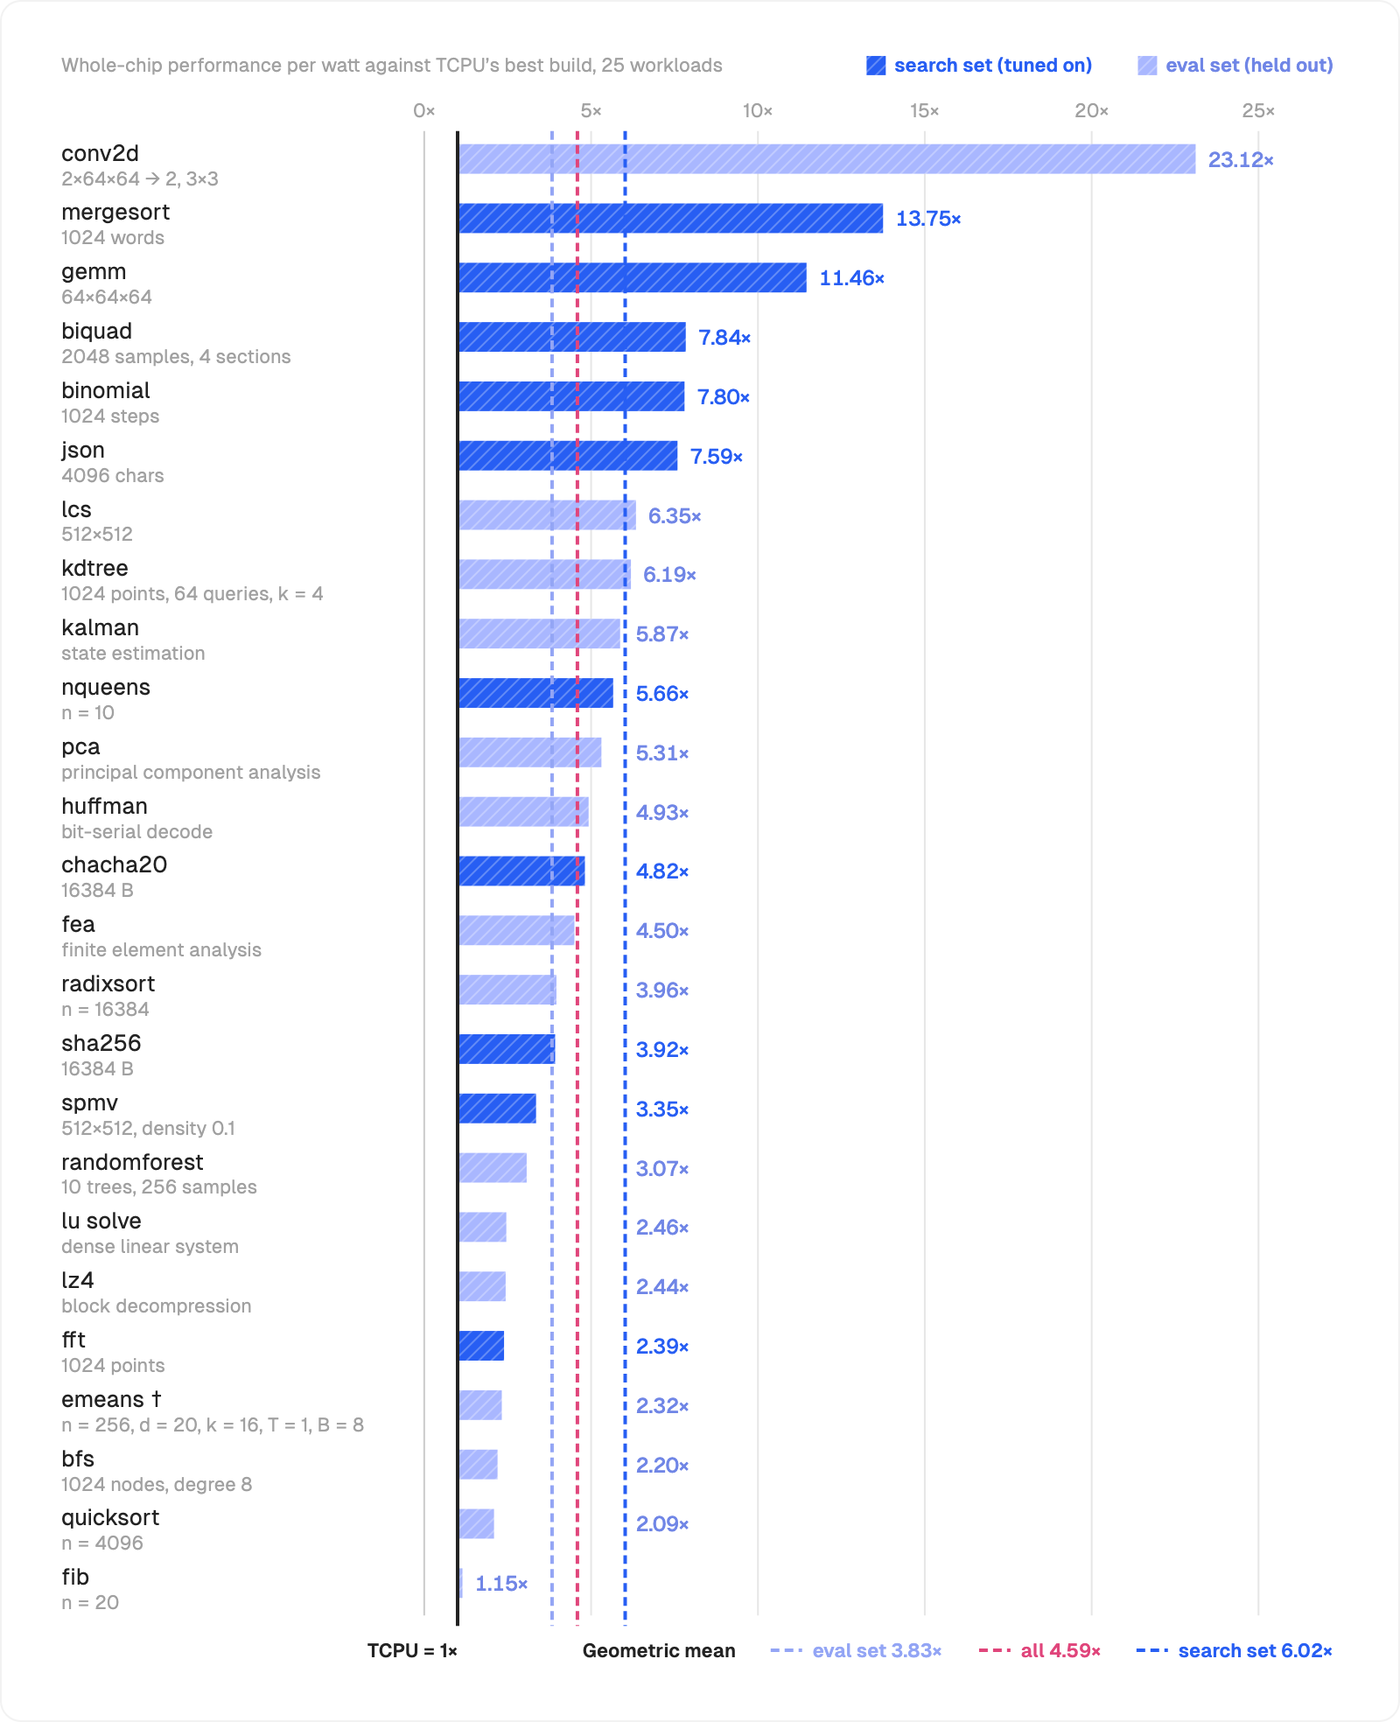 图:Frostbite 与传统双发射核心在 25 个测试负载上的能效对比分布。来源:architectlabs.com
单项任务的极差更具启发性。在规整矩阵运算 conv2d 任务中,并发优势充分释放,每瓦性能暴增至对手的 23.12 倍。但在包含大量递归分支与指针调用的斐波那契数列任务中,能效优势骤降至 1.15 倍。不规则的调用栈会拖慢图重写速度。这也是交互网难以通吃一切日常软件的症结所在。
更关键的工程背景在于对手的选择。测试基准 TCPU 是一颗主打极低功耗的双发射顺序核。它缺少分支预测与乱序发射等重载机制。若将对比标的换成主流乱序多发射处理器,能效倍数大概率会被重新改写。
研发团队坦言,受制于法务协议,目前尚无法公布对比处理器的商用型号。新型处理器的指令集与硬件源代码暂未对外公开。后续仍需推进 FPGA 原型验证与标准基准测试适配。
Frostbite 的核心贡献不在于打败了某颗具体型号的芯片。它的真正意义在于证明了算法可以脱离人类经验。被遗忘数十年的数学理论由此重塑为可量产的物理实体。当计算机指令集不再迎合人类阅读习惯,硬件能耗的演进逻辑已被撬开了一条新缝隙。
参考链接:
- Architect Labs 官方技术报告
- ACM SIGPLAN POPL 1990 会议论文集
- 计算机体系结构与硬件形式化验证文献