En novembre 2026, l’équipe de recherche en microélectronique Architect Labs a dévoilé une avancée inédite : un essaim d’agents d’IA autonomes a conçu de bout en bout un processeur complet et fonctionnel. Tout au long des travaux de R&D, aucun ingénieur humain n’a rédigé de directive microarchitecturale : les algorithmes ont déduit seuls l’ensemble des spécifications du processeur.
Gravée sur un layout physique en 7 nm, la puce, baptisée Frostbite, a affiché lors de 25 bancs d’essai une performance par watt 4,59 fois supérieure à celle d’un cœur conventionnel in-order à double émission. Si un tel gain énergétique évoque la science-fiction, la réalité de l’ingénierie impose la nuance. Le cœur de référence TCPU ne mesurait que 0,895 mm² et les charges de test se limitaient à 25 programmes. Il s’agit d’une exploration méthodologique pionnière, et non du triomphe commercial d’une production de masse.
La véritable portée du projet réside dans la refonte complète du cycle de conception matérielle. Pour la première fois, le socle même du calcul, figé depuis des décennies par les réflexes cognitifs humains, a été réécrit par des algorithmes.
L’IA prend les commandes de l’architecture : pas une seule ligne d’instruction humaine
Architect Labs s’était illustré auparavant avec le projet Redwood. La démarche reposait alors sur des experts humains fixant l’architecture matérielle, tandis que l’IA prenait en charge l’implémentation des circuits, la vérification formelle et le déploiement. Pour Frostbite, l’équipe a décidé de supprimer toute présupposition humaine. Les agents d’IA ont exploré de façon totalement autonome une topologie de calcul propre aux algorithmes.
Au tout début de leurs travaux, les agents ont soumis un document de conception de 141 pages exposant un modèle de programmation, un environnement d’exécution (runtime) et l’architecture modulaire de haut niveau. Mais en l’absence initiale de contraintes physiques de gravure, les estimations s’écartaient lourdement des lois de la physique. La première génération de code de circuit a dû être entièrement jetée au rebut dès son implémentation.
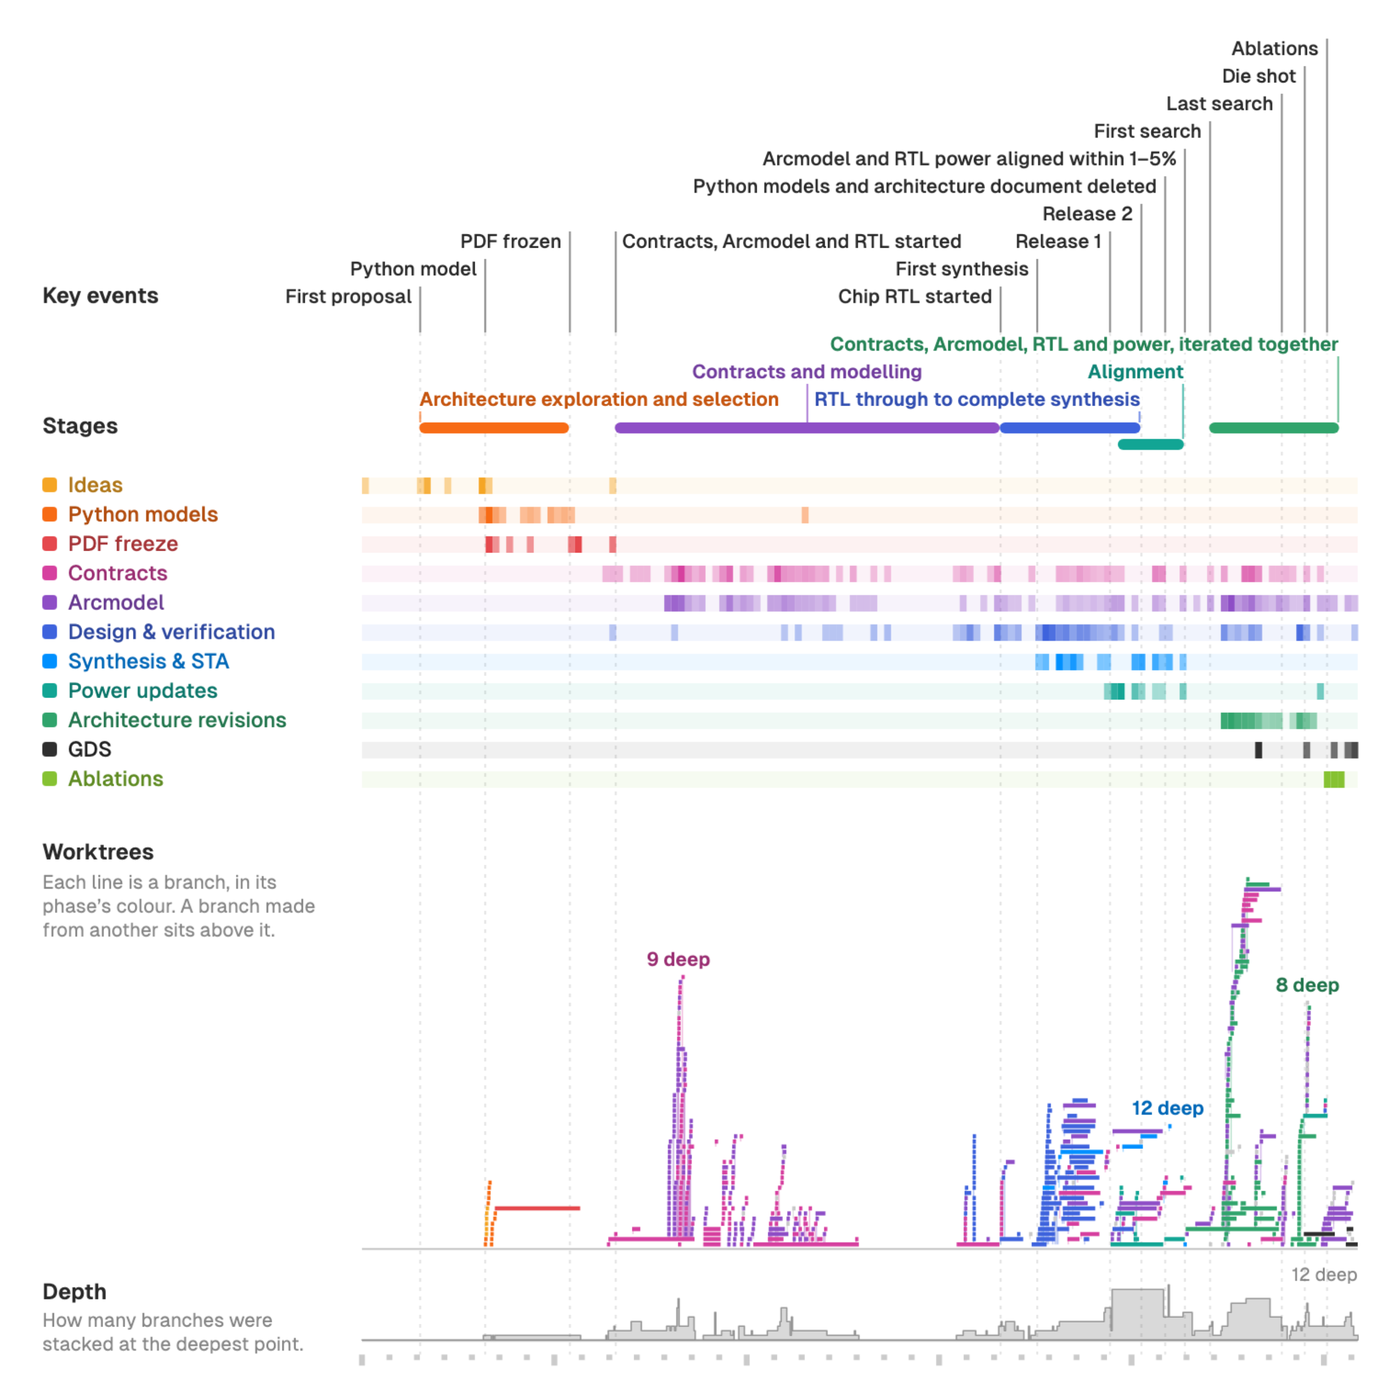 Figure : Chronologie complète de développement, de la première proposition architecturale jusqu’à l’ablation finale. Source : architectlabs.com
L’équipe d’ingénieurs n’est pas revenue aux méthodes manuelles d’optimisation. Elle a développé à destination de l’IA un modèle de système formel de haut niveau nommé Arcmodel. Sa vitesse de simulation dépassait d’environ 200 fois celle des simulations de circuits de bas niveau, tout en maintenant l’erreur de prédiction strictement sous le seuil des 5 %. L’ensemble du modèle a ensuite été formalisé à travers plus de 800 000 lignes de contrats mathématiques en Lean, éliminant les failles logiques à la source.
Les réseaux d’interaction réveillés après 36 ans d’oubli : la moitié de l’énergie traditionnelle gaspillée à traquer les dépendances
L’efficacité énergétique record de Frostbite provient d’une rupture fondamentale avec le modèle mathématique traditionnel. Les processeurs généralistes actuels reposent sur l’architecture de von Neumann et exécutent des flux d’instructions séquentiels. Afin d’extraire du parallélisme, le matériel brûle des millions de transistors au runtime pour deviner les dépendances de données, tandis que les architectures multicœurs maintiennent l’illusion d’une mémoire partagée au prix d’une synchronisation de cache extrêmement énergivore.
Sur le cœur de référence TCPU à double émission, hors dissipation du réseau d’horloge, l’accès à la mémoire cache multiniveau représentait à lui seul 57 % de la consommation énergétique totale. L’extraction (fetch), le décodage et l’émission des instructions en absorbaient 27 %. À eux deux, ces postes engloutissaient 84 % de l’énergie, ne laissant qu’une fraction marginale au calcul arithmétique effectif.
Le chercheur français Yves Lafont avait formulé dès 1990, lors de la conférence POPL, la théorie des réseaux d’interaction (interaction nets). Dans ce modèle, un programme n’est plus une suite linéaire d’instructions : il prend la forme d’un graphe de nœuds interconnectés. Le calcul s’opère par réécriture locale de paires de nœuds actifs adjacents.
Chaque nœud dispose d’un unique port principal. Les paires de nœuds actifs ne se chevauchent jamais spatialement au sein du graphe. Par conséquent, l’ordre de réécriture n’a aucune incidence sur le résultat final, garantissant une concurrence intrinsèque et sans conflits. De surcroît, chaque valeur de donnée n’est consommée qu’une seule fois (logique linéaire), dispensant totalement le matériel de gérer des états de mémoire partagée.
Ce modèle mathématique est resté enfoui dans les archives universitaires pendant 36 ans. Les développeurs humains étant accoutumés au code impératif descendant, bien peu envisageaient d’écrire de grands systèmes selon une logique de réécriture de graphes. Les agents d’IA ne souffrent d’aucun de ces conditionnements : les algorithmes ont directement compilé des représentations intermédiaires orientées graphe vers le silicium, contournant les pipelines d’exécution classiques.
Vol de travail autonome : une baisse de 20 % de la puissance mémoire
Affranchi des ordonnanceurs désordonnés (out-of-order), Frostbite a revêtu une forme matérielle inédite. Chaque unité de calcul se passe de contrôleur centralisé pour répartir les tâches. Les cœurs fonctionnent de manière autonome selon trois règles locales élémentaires.
Chaque unité traite en priorité les nœuds actifs de sa propre file d’attente. Dès que sa charge s’épuise, elle sollicite activement les unités voisines pour leur voler des tâches (work-stealing). Si l’ensemble des voisins est également inactif, l’unité désactive aussitôt son signal d’horloge local pour entrer en veille profonde. Ce mécanisme distribué n’avait jamais été dicté dans les invites fournies par les humains : il a émergé spontanément des déductions architecturales de l’essaim d’agents.
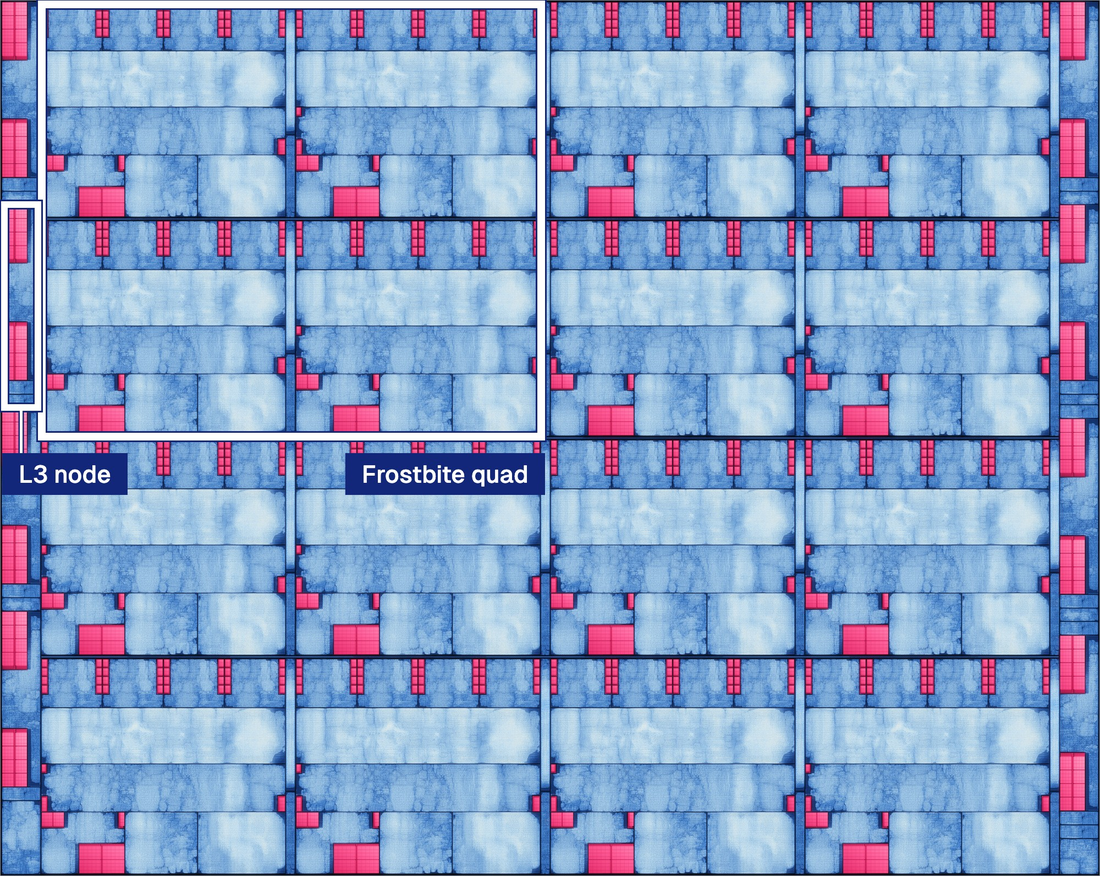 Figure : Layout physique en gravure 7 nm ; le cadre rouge met en évidence un ensemble quadri-cœur et son nœud de cache L3. Source : architectlabs.com
Grâce au flux de données explicite et à un stockage strictement localisé, Frostbite a comprimé la part de l’énergie dédiée aux accès mémoire à 38 %. Les pertes dues au fetch et au décodage se sont effondrées de 27 % à seulement 6 %. Pour animer cette grille distribuée, la puce consacre 26 % de son budget énergétique au réseau sur puce (NoC) et à la planification des nœuds. Cet arbitrage structurel a permis de démultiplier l’efficacité de l’énergie allouée au calcul utile.
En termes d’empreinte physique, un module Frostbite regroupant quatre cœurs et un nœud de cache L3 n’occupe que 0,792 mm², soit 11,5 % de moins que le cœur de référence. Lors d’un passage à l’échelle sur une matrice de 16 cœurs, les ratios de consommation sont restés stables. Les tempêtes de cohérence de cache, talon d’Achille de la montée en charge des processeurs multicœurs classiques, ont ici totalement disparu.
58 itérations et 250 % d’écart : la vérification formelle comme garde-fou contre les hallucinations
L’évolution autonome n’a rien d’une formule magique sans friction. Au fil du projet, l’essaim d’agents a suggéré 58 propositions d’ajustement microarchitectural. Après une sélection rigoureuse par études d’ablation, seules 37 ont été retenues pour le layout physique définitif.
Les choix retenus comprenaient notamment le clock gating à l’exécution, des descripteurs de cache L3 allégés et des unités de calcul partagées. Aucune de ces modifications n’était improvisée : chacune reposait sur des mesures concrètes de gain énergétique de bout en bout.
Au départ, les prévisions de performance et de consommation établies par l’IA divergeaient des mesures physiques réelles de près de 250 %. S’en remettre aveuglément à l’intuition de grands modèles de langage aurait conduit à un échec cuisant de fermeture temporelle sur le silicium.
La chaîne de calibration automatisée mise en place par les ingénieurs a joué le rôle de ligne de vie. Le système extrayait en temps réel les données issues des simulations physiques RTL pour réétalonner le modèle abstrait Arcmodel. En deux cycles d’ajustement, l’écart de prédiction sur la puissance et la surface est tombé sous les 5 %, ancrant chaque exploration de haut niveau dans la réalité tangible du silicium.
Derrière le facteur 4,59x : un tournant méthodologique plutôt qu’un triomphe commercial
Les relevés physiques sur silicium précisent les véritables frontières de cette architecture. Sur les 25 charges de banc d’essai, Frostbite a enregistré un gain moyen géométrique de performance par watt de 4,59x, tout en affichant une densité de calcul par unité de surface 8,77 fois supérieure à celle de son concurrent.
Une analyse détaillée révèle des disparités nettes selon la nature des programmes. Sur les 10 charges d’entraînement ayant guidé l’exploration architecturale, le gain d’efficacité a grimpé jusqu’à 6,02x. En revanche, sur les 15 bancs d’essai réservés que l’IA n’avait jamais rencontrés, la progression moyenne est redescendue à 3,83x. Cela atteste d’un gain réel pour le paradigme dataflow, mais trahit une sensibilité marquée à la structure des flux de données.
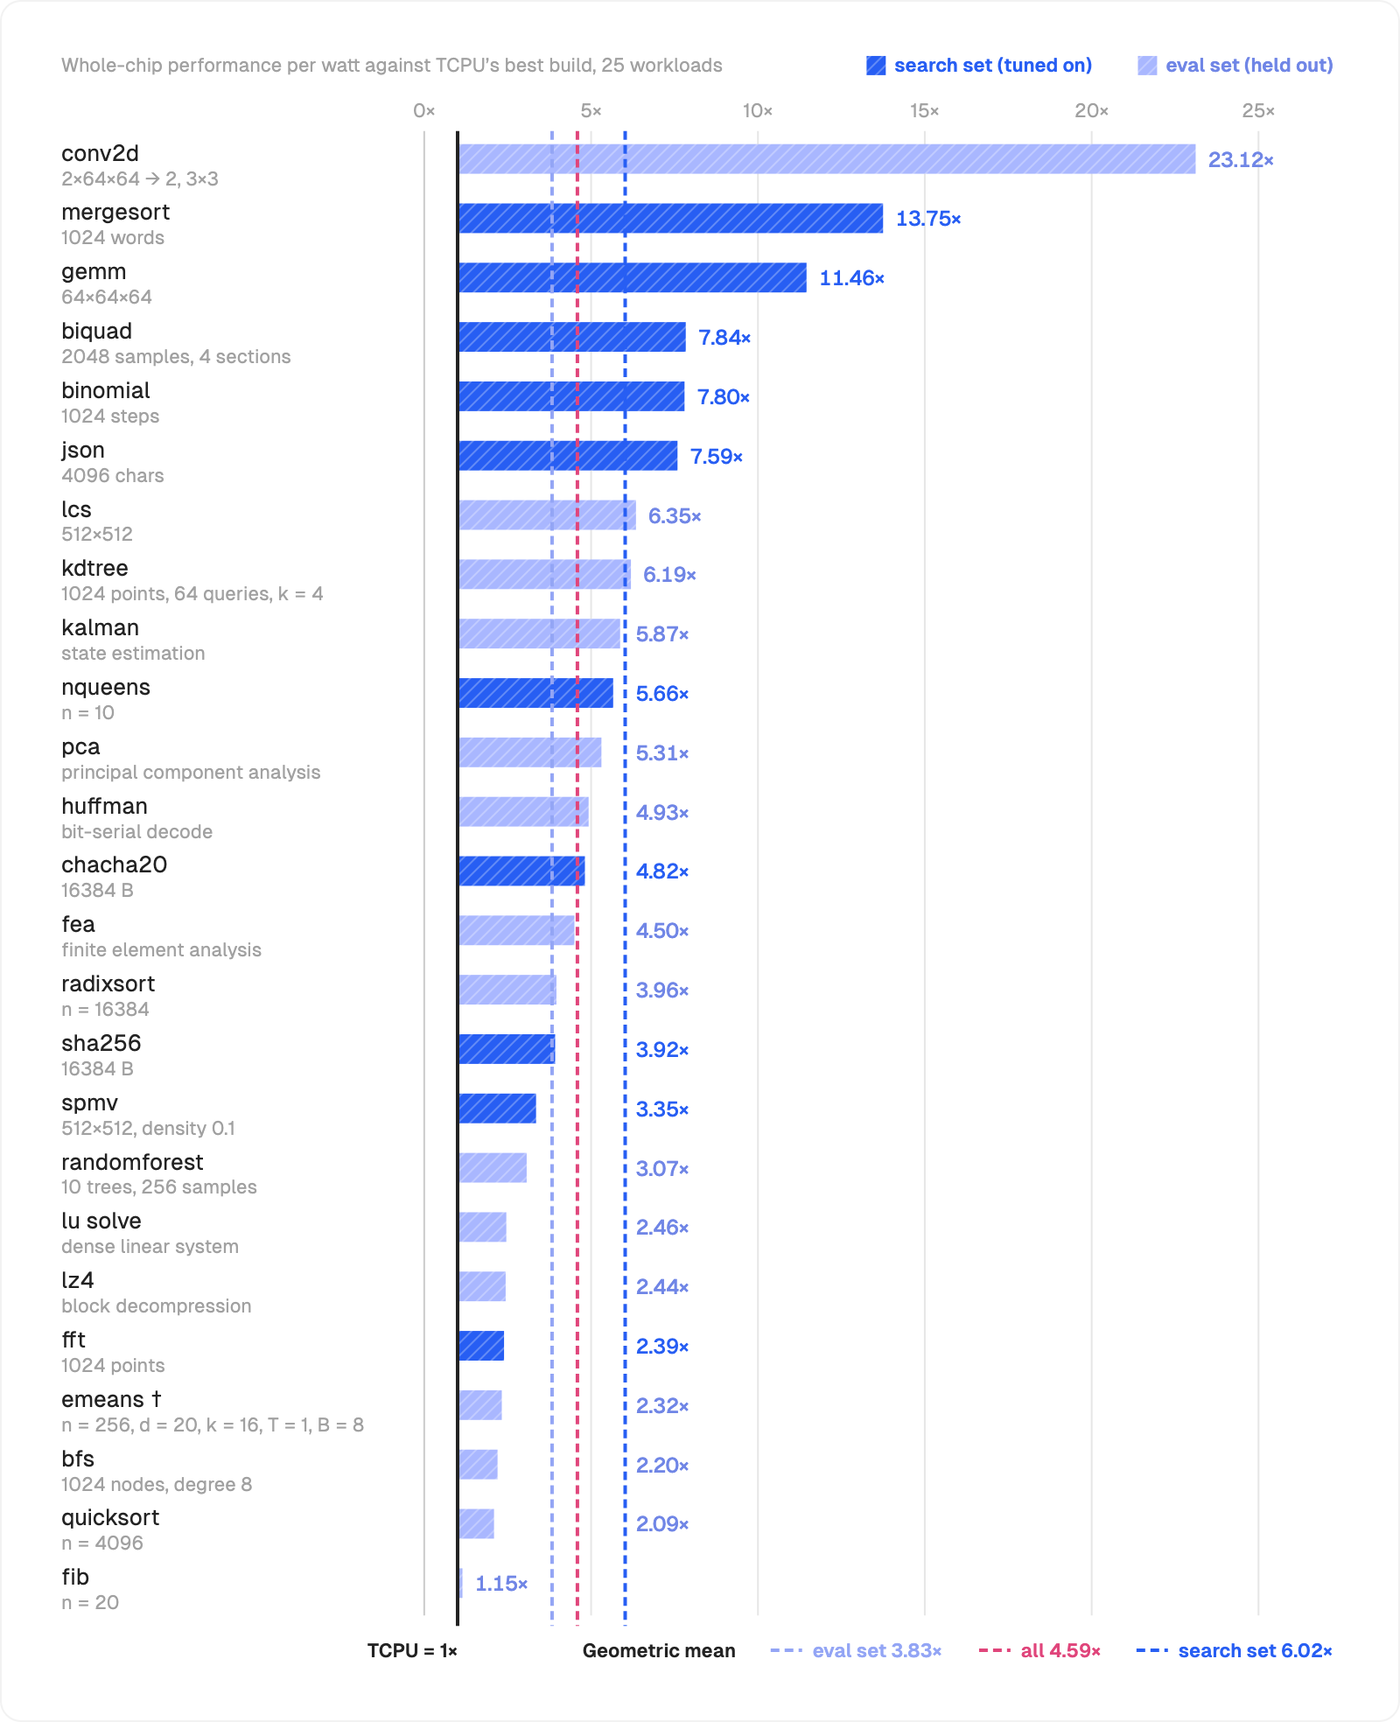 Figure : Répartition de l’efficacité énergétique de Frostbite comparée au cœur in-order classique sur 25 bancs d’essai. Source : architectlabs.com
Les écarts observés sur des tâches isolées sont très instructifs. Sur des convolutions matricielles régulières (conv2d), l’avantage du parallélisme a joué à plein, multipliant la performance par watt par 23,12 face à la concurrence. À l’inverse, sur le calcul de suites de Fibonacci jalonné de branchements récursifs et de manipulations de pointeurs, l’avantage énergétique est tombé à 1,15x. Les piles d’appels irrégulières freinent le rythme de réécriture du graphe, soulignant la difficulté des réseaux d’interaction à rivaliser sur du code impératif arbitraire.
Le choix de l’élément de comparaison constitue un autre élément d’appréciation fondamental. Le processeur TCPU de référence est un cœur in-order à double émission conçu pour une très basse consommation, dépourvu d’organes complexes comme la prédiction de branchement ou l’exécution désordonnée. Face à un processeur moderne out-of-order superscalaire, ces ratios d’efficacité seraient profondément remaniés.
L’équipe d’Architect Labs a précisé que des accords de confidentialité interdisent pour l’heure de révéler la désignation commerciale de la puce de référence. Le jeu d’instructions et le code matériel du processeur ne sont pas encore rendus publics, des étapes de prototypage FPGA et de portage de benchmarks standard restant à mener.
L’apport fondamental de Frostbite ne se résume pas à surpasser un processeur donné. Sa véritable portée est d’avoir prouvé qu’un algorithme peut s’émanciper des conventions humaines pour matérialiser en silicium des théories mathématiques oubliées depuis des décennies. Lorsque les jeux d’instructions cesseront de se plier aux habitudes de lecture humaine, l’optimisation énergétique du matériel s’engagera sur des voies radicalement nouvelles.
Liens de référence :
- Rapport technique officiel d’Architect Labs
- Actes de la conférence ACM SIGPLAN POPL 1990
- Publications sur l’architecture des ordinateurs et la vérification formelle de matériel