工程师习惯用增加节点的方式解决分布不均。2026年,Cloudflare 性能团队接到工单,Pingora Backend Router(PBR)中部分进程内存飙升至 6GB。这是一笔数学债务。在一致性哈希架构下,单台服务器虚拟节点数被推到了令人咋舌的 100000 个。系统规模突破阈值后,沿用旧参数带来的不再是性能提升,而是基础设施的重负。
查清内存黑洞必须回到一致性哈希基本盘。朴素的算法实现中,请求和服务器映射到同一根数轴上。没有虚拟节点干预时,一百台服务器集群里,单台机器任务分配变异系数高达 99%。业界针对倾斜早有成熟解法。NGINX 源码将每台服务器虚拟哈希点硬编码为 160 个。160 这个数字能将变异系数压低到 8% 的合理区间,Pingora 重写时沿用了该数值。
 图:Cloudflare 的一致性哈希架构全景。来源:Cloudflare Blog
默认哈希数被加权因子放大了六百倍
问题出在节点加权机制与业务复杂度的重叠上。ketama 算法允许系统根据服务器规格,按特定系数缩放虚拟节点数量。Cloudflare 团队使用各节点磁盘容量作为核心权重指标。硬件更迭后,加权因子最大取值达到 625。
当 160 个默认节点碰上 625 的加权因子,高配服务器在哈希环上的虚拟节点数量膨胀到了 100000 个。单条全局哈希环的内存消耗尚可忍受。但在真实生产环境中,业务请求面临严苛合规要求和缓存隔离特性限制。不同的请求特征对应不同的可用服务器子集。
每个合规组合都需要在内存中维护独立的一致性哈希环。随着路由逻辑迭代,组合数量呈指数级增长。数以万计的哈希环频繁创建,每条环承载百万级虚拟节点。这些结构将 PBR 进程常驻内存推高到了 6GB。业务灵活性的隐形成本转化为了内存账单。
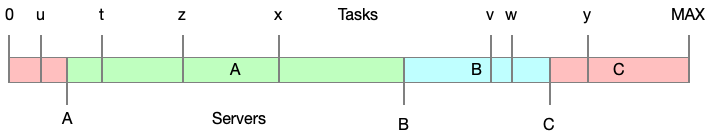 图:数轴上的哈希着色,展示每台服务器实际覆盖的区间。来源:Cloudflare Blog
六字节结构体绕开底层存储对齐边界
面对巨大内存开销,团队首先审视底层存储结构。原有 Rust 代码中,哈希环上的虚拟节点由 struct Point { hash: u32, index: u32 } 表示。这两个字段占据 8 字节物理空间。
数据中心服务器总数远未达到 32 位整数上限。使用 16 位数值型索引足以覆盖 65536 台服务器。Rust 编译器强制要求,结构体整体大小必须是其最大对齐字段字节数的整数倍。
若将结构体修改为 u32 和 u16 组合,编译器会在末尾自动填充两字节空白占位符。团队采用定长字节数组 struct Point([u8; 6]) 绕过对齐限制,配合自定义 getter 接口进行位掩码操作。改动在读取时增加了计算损耗,但直接砍掉 25% 常驻开销。
| 结构体实现方案 | 字段宽度 | 对齐要求 | 单节点占用 | 降幅 | 工程评价 |
|---|---|---|---|---|---|
| 原始基础结构 | u32, u32 | 4 字节 | 8 字节 | 0% | 读取最快,存在严重字段冗余浪费 |
| 简单缩小索引 | u32, u16 | 4 字节 | 8 字节 | 0% | 受限于编译器底层规则,无法带来空间收益 |
| 强制紧凑排列 | 标注 packed | 1 字节 | 6 字节 | 25% | 存在非对齐内存访问的系统崩溃风险 |
| 字节数组封装 | [u8; 6] | 1 字节 | 6 字节 | 25% | 绕开限制,存在微小掩码开销但运行安全 |
增加最后九万哈希只换来微小改善
数据结构的位级别优化仅是治标,重新审视虚拟节点概率模型才是治本。工程师回到数学演算原点,推导出了 ketama 算法标准差闭式解:CV_k = sqrt((N-1)/(N·k+1))。
数学曲线直观揭示了边际递减现实:工程师每希望将负载分配误差缩小一个数量级,所需虚拟哈希数需要增加近一个数量级。系统将单台服务器虚拟哈希数从一万激增到 100000 个时,收益曲线进入长尾区间。最后 90000 个哈希点的注入,仅换来了 0.7% 的误差改善。
随着密度增加,系统撞上 32 位运算空间的生日悖论上限墙。大量点位被塞入有限整数范围时,哈希重叠碰撞概率急剧攀升。在拥有 2048 台服务器的数据中心中,单台机器节点数跨过一万大关继续攀升时,分配误差因为剧烈碰撞开始反弹。沿着堆积点位方向优化负载,只会反噬基础架构稳定性。
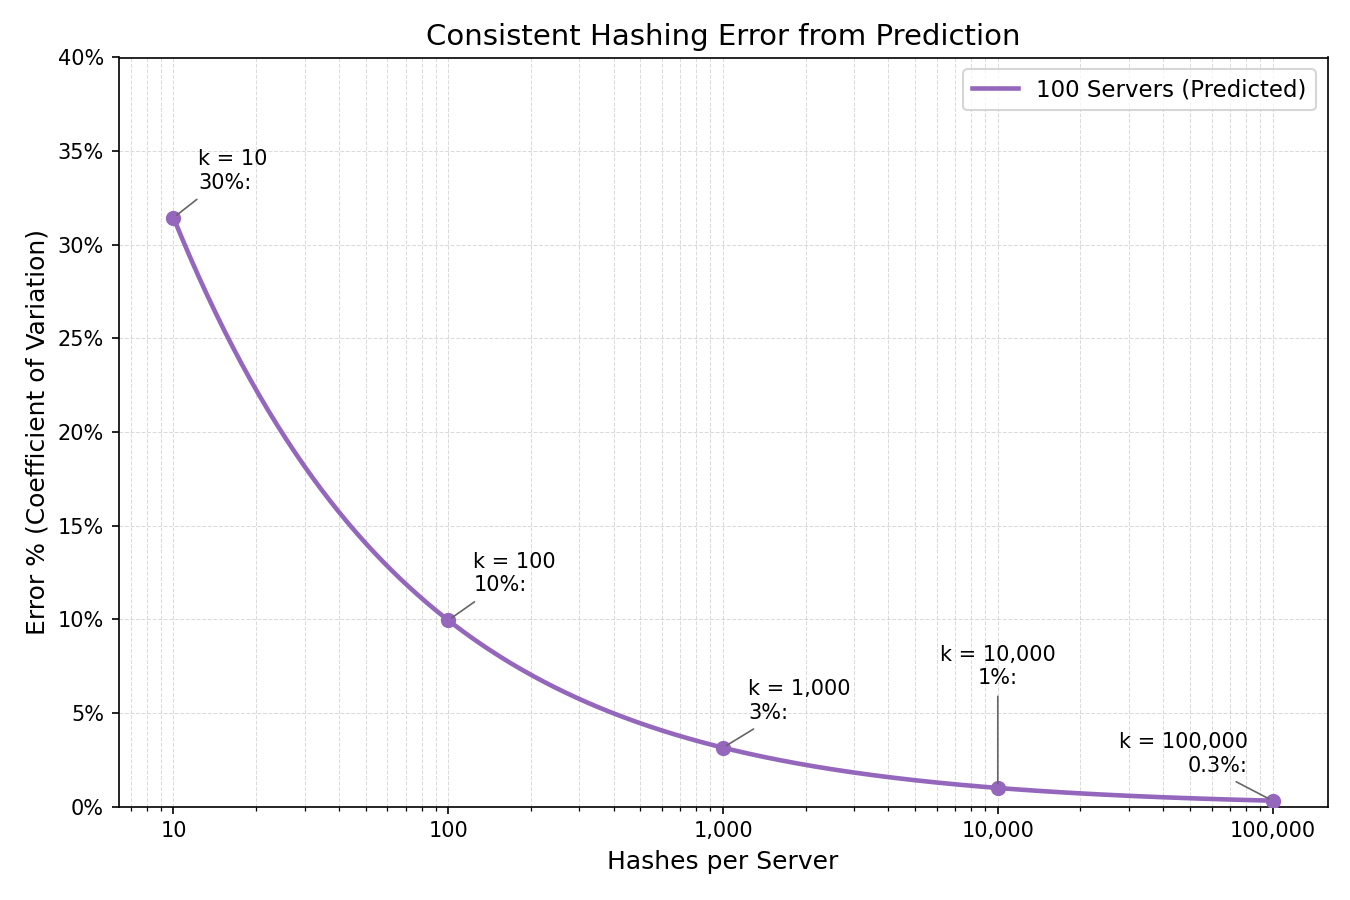 图:CV_k 曲线显示哈希数翻倍带来的误差改善迅速衰减。来源:Cloudflare Blog
全局下调九成配置并分层平滑灰度
确认统计模型和碰撞边界后,研发团队把每台服务器的默认哈希数量直接下调 90%。这个改动抛弃了此前被认为能提供极佳均匀度的高水位参数,让系统回到基础参数区间。省下这批内存靠的是把分布算清楚,机器一台没换。
承载边缘网络核心流量的路由网关无法承受剧烈震荡。工程团队设计了双轨并存的无缝灰度切换方案。架构过渡期间,旧版本哈希环和精简后的新环同时暂存于进程内存中。路由程序根据请求哈希指纹,决定连接走向哪条映射环。
控制平面被精细拆分成「新版本环承载比例」与「流量迁移数据中心」两个独立维度。分层灰度策略有效限制了早期版本的爆炸半径。旧版结构正式移除那天,PBR 进程内存消耗曲线呈现出断崖下跌。全球边缘节点累计回收 100TB 物理内存,配合 DNS 团队早前省下的另 100TB,这次优化大幅降低硬件采购压力。
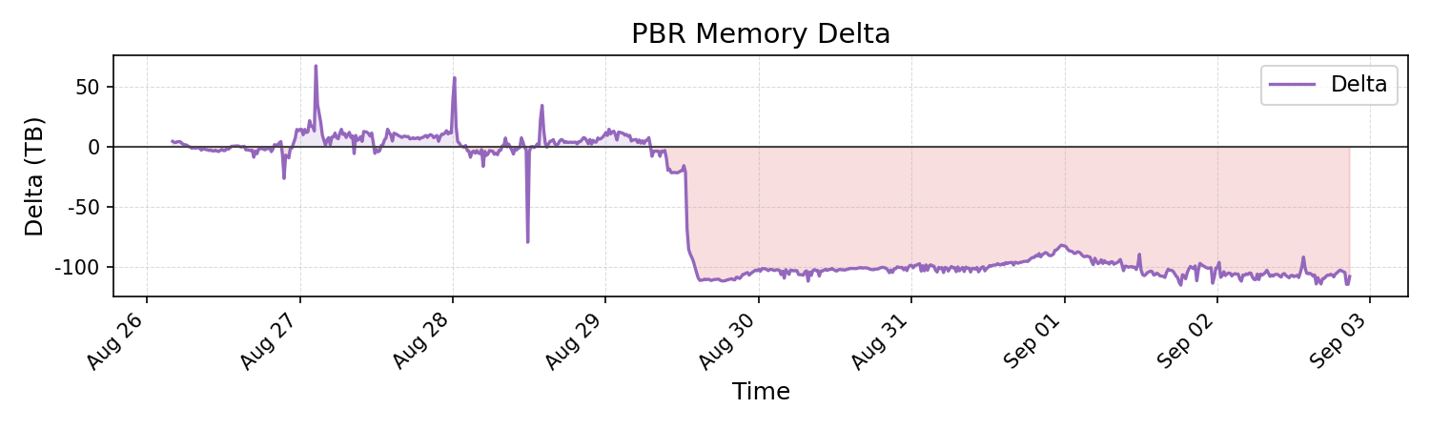 图:改动前后 PBR 内存曲线对比。来源:Cloudflare Blog
社区争议揭示基础设施的妥协边界
这篇展示数学推导的博客在 Hacker News 引发同行讨论。不同背景的工程师基于基础设施真实规模,做出了不同的架构经济学评判。有开发者在评论区指出,按绝对内存节省量计算这仍是一个 1% 级别的改善。在常规规模场景中,加内存条远比重写路由组件划算。
另一部分架构师主张抛弃传统 ketama 环状算法。有从业者提出提取请求 Key 哈希值的首部 N 位数值作为分片依据,配合预先计算生成的扁平哈希数组,理论上能为全局系统释放大量存储空间。用 CPU 计算空间换物理内存空间的思路,在计算密集场景颇受青睐。
面对延迟增加疑虑,部分熟悉内核的开发人员厘清事实。PBR 庞大哈希计算过程只发生在构建底层哈希环的冷启动更新阶段。在处理热路径路由中,系统只需计算一次请求哈希,随后在连续映射中执行极低开销的 lower_bound 二分查找。这场争议揭示了行业真相:部署规模跨越两个数量级后,基础算法选型也会面临不同妥协方向。
「多加点哈希」这条路径十年前就走到头了:每台服务器从 1 个哈希加到 100000 个,最后 90000 个只买到 0.7% 的误差改善,还撞上 32 位哈希的碰撞墙——继续堆数不如回去把分布算清楚。
参考链接:
- Cloudflare Blog
- pingora-ketama 源码
- Hacker News 讨论