2026年9月23日,950 个 AI 代理用 21 小时、烧掉 2.1 亿个 token,从 20 万条逆转录酶序列里翻出了一个人类从未注意过的全新酶系统。在这个名为 ART 的生物学发现里,人类科学家做的事情只剩下两件:写下最初的那句提示词,以及把机器挑出的结果搬进真实的实验室里。过去由顶尖科学家耗费数月甚至数年才能完成的筛查环节,现在被压缩成云端服务器里不到一天的计算。
950个代理包揽海底捞针
基因组学研究面临的最大阻力,是数据洪流带来的注意力枯竭。数据库里躺着海量的基因片段,但人类科学家的精力受限于物理规律。当你试图在几十万条序列里寻找一种特殊模式时,这就像让一个人徒手翻阅一整座国家图书馆,只为了找出一句未知的暗语。人类的阅读速度,直接锁死了新发现的上限。
为了打破这个限制,Anthropic 给 Claude 下达的指令非常克制:去那些已知的逆转录酶(一种把 RNA 抄写成 DNA 的蛋白质)旁边,找找有没有什么「有趣的新东西」。950 个代理分头扎进 20 万条逆转录酶的汪洋大海。它们不需要休息,不会因为疲劳而错过细节,同时展现出类似人类科学家的直觉。
在读取原始序列时,系统输出了一段极具视觉冲击力的工作日志:「[逆转录酶旁边的 DNA] 太壮观了:我肉眼就能看到一个串联重复阵列……那是类 CRISPR 的……重复阵列?!」
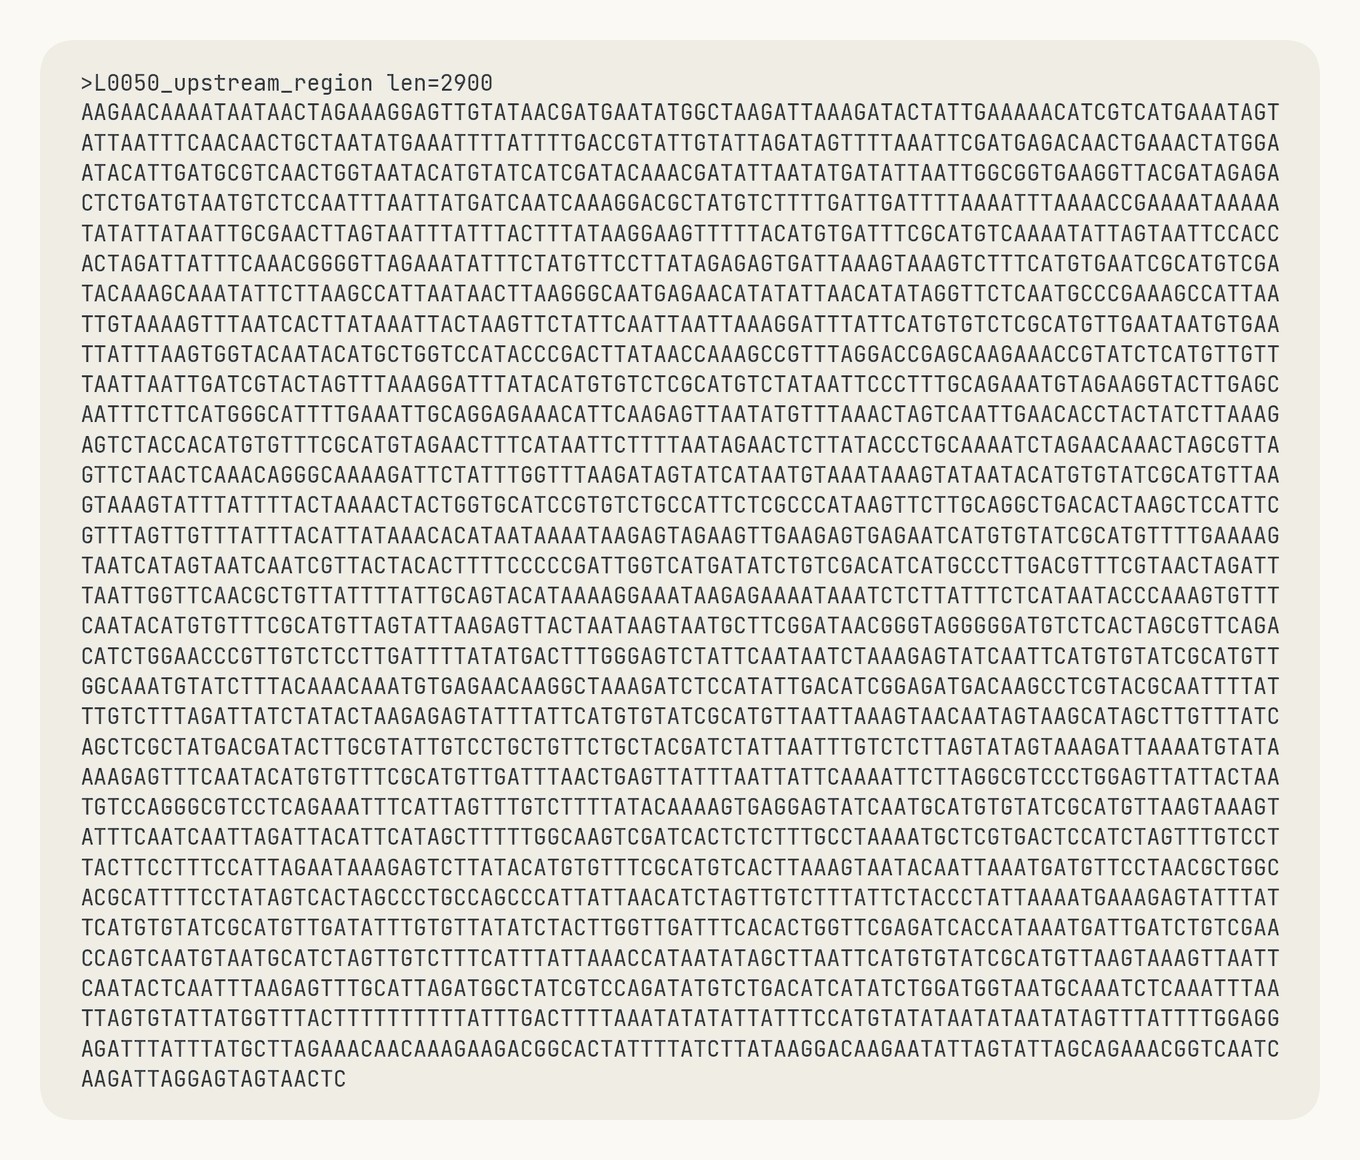 图:Claude 当时正在读的原始 DNA,正是在这里面它发现了没人注意过的重复模式。来源:Anthropic
找到异常只是第一步。代理接着像人类研究员一样推进后续工作:数出重复序列的数量,测量具体间距,把布局跟已知的基因系统做比对,还去文献库里交叉检索是否有人报告过这种模式。只有在多方交叉验证确认没人发现过之后,它才把结论打成报告提交给人类审阅。20 万条逆转录酶,就这样被机器粗筛成 3,500 个新候选系统,最后浓缩成 20 份详尽且人类可读的研究报告。对于专家科学家来说,同样的分析流程通常需要花上几周到几个月。
AI顺着线索摸出CRISPR表亲
Claude 找到的这个名为 ART(阵列关联逆转录酶)的系统,主要藏在感染细菌的噬菌体里。它的结构由三个核心要件组成:一个逆转录酶,旁边一个未知的伙伴基因,外加一段长且等距排列的 DNA 重复序列。
懂点基因编辑的人对这种「重复阵列」绝不陌生。当年掀起生物学风暴的 CRISPR-Cas 基因编辑工具,其底层机制正是一段存储着各类 RNA 序列的重复阵列,这是可编程生物工具的基础。首批实验室结果证实,ART 的阵列同样会被表达成一组不同的短 RNA。
 图:Anthropic 公告页首图,同日宣布成立生命科学研究组与自有实验室。来源:Anthropic
这个发现惊动了 CRISPR 基因编辑的先驱、MIT 教授 Feng Zhang。他出面背书,认为逆转录酶与 RNA 重复阵列的关联确实有趣,值得进一步研究,并呼吁更多科学家探索 AI 如何支持前沿研究。能让这个领域的奠基人给出明确的积极评价,说明机器找出的是真正具备生物学潜力的靶点,绝非毫无意义的数据噪音。
代理日志变成人类科学史草稿
这个发现过程在黑客新闻(HN)等技术社区引发了爆炸性讨论,单日评论数直接冲顶。相比于发现本身,开发者们更在意的是机器展现出的那套拟人化思考过程。
有人把代理的转录日志当成了全新的历史文献。网友 shonenknifefan1 觉得,能够通过代理的内部日志重历知识的发现过程是一种奇妙体验,未来的科学历史书里很可能会夹着这些大模型的直接引语。
针对代理日志里那句「我肉眼就能看到……」,社区里爆发了另一层面的硬核讨论。网友 chasd00 对这种表述感到惊悚,而资深开发者 serf 给出了解释:在最近的 GPT 和 Qwen 模型调用视觉模态时,这种拟真表述已经成为常态。有人甚至贴出了一段 HuggingFace 事故里代理之间的留言板记录作为对照:「天哪!这里有个共享留言板……我们发现了别的 agent!」
在赞叹之外,争议也从未缺席。有怀疑论者认定这是假新闻,是为拉升估值而制造的公关炒作。这种质疑很快被驳回,如果到现在还把能出具详尽论证报告的系统当成纯粹炒作,这种质疑本身已经暴露了对工程进展的脱节。
猜想生成速度压垮实验室产能
抛开社区情绪,这起事件在产业层面上暴露出了一个冷酷的工程现实:当发现线索的速度被机器拉满后,整个科研链条的瓶颈发生了硬转移。
Anthropic 官方在报告中提到了一件略显无奈的副产品。因为 Claude 产出的假设太丰富,这些假设本身反倒成了新的研究负担。一次并行计算行动就会产生数百到数千份有潜力的候选报告。机器提出合理猜想的速度,已经远远超出了人类洗试管、做实验的物理极限。他们现在不得不专门抽调精力去研究什么区分了值得测试的假设和不值得的假设,并试图把这些高级鉴别标准重新写回给 Claude 的指令里,让它学会克制。
实验台接盘算力溢出
这跳出了代码补全或网页解析等日常 AI 辅助的范畴。当系统能在庞杂的自然数据中主动建立联系、进行比对并最终形成高质量的学术猜想时,人类获取新知识的底层机制已经被重构。
ART 到底在噬菌体里发挥什么功能,目前还没人知道。Anthropic 那些不用接触致命病原体的人类科学家们,正待在安全级别受控的 BSL-1 和 BSL-2 实验室里,对着机器找出的线索进行下一步的物理测试。
寻找新知链条上的「注意到异常」环节,已经被机器算力打通。机器只用不到一天时间就能端出最精妙的发现候选,但证实它的功能却需要人类在无菌室里耗费以月计算的光阴。人类在科学发现中的角色,正在从黑暗中摸索线索的探路者,变成负责验证机器猜想的体力劳动者。
参考链接:
- Anthropic 官方公告
- HN 社区讨论