一个 1 KiB 的包,在 Linux 的 GRO 批量收包路径上会被复制进一个 64 KiB 的缓冲。这个尺寸错配在 Tailscale 的数据面里存在了很久,直到团队决定让包留在原地。省下来的内存没有闲置,它变成了 subnet router、app connector 和 exit node 开启多队列的本钱。
1 KiB 数据跑在 64 KiB 缓冲道上
2026 年 9 月 22 日,Tailscale 工程师 Kabir Sikand 和 Kevin Purdy 联合多位贡献者,公布了数据面提速的工程细节。他们此前已经在 Linux 上拉升了 TCP 吞吐,推动 wireguard-go 在裸机上突破 10Gb/s。团队后来利用 segmentation offload 技术,让 UDP 应用吞吐翻了 4 倍以上。成绩单背后,开发团队撞上了 Linux 高效机制带来的副产物。
 图:官方博客头图,这次优化覆盖 subnet router、app connector 与 exit node。来源:Tailscale 博客
Linux 的 GRO 机制要求接收端准备 64 KiB 的流量缓冲,以此实现最高效的批量收包。真实的日常流量里,绝大多数包的体积其实只有约 1 KiB。wireguard-go 过去只提供单一的 64 KiB 缓冲尺寸。每次收到 1 KiB 包,系统就会把它单独复制进独立的 64 KiB 缓冲区。吞吐优化带来的内存开销,在微小数据包的冲击下被指数级放大了。
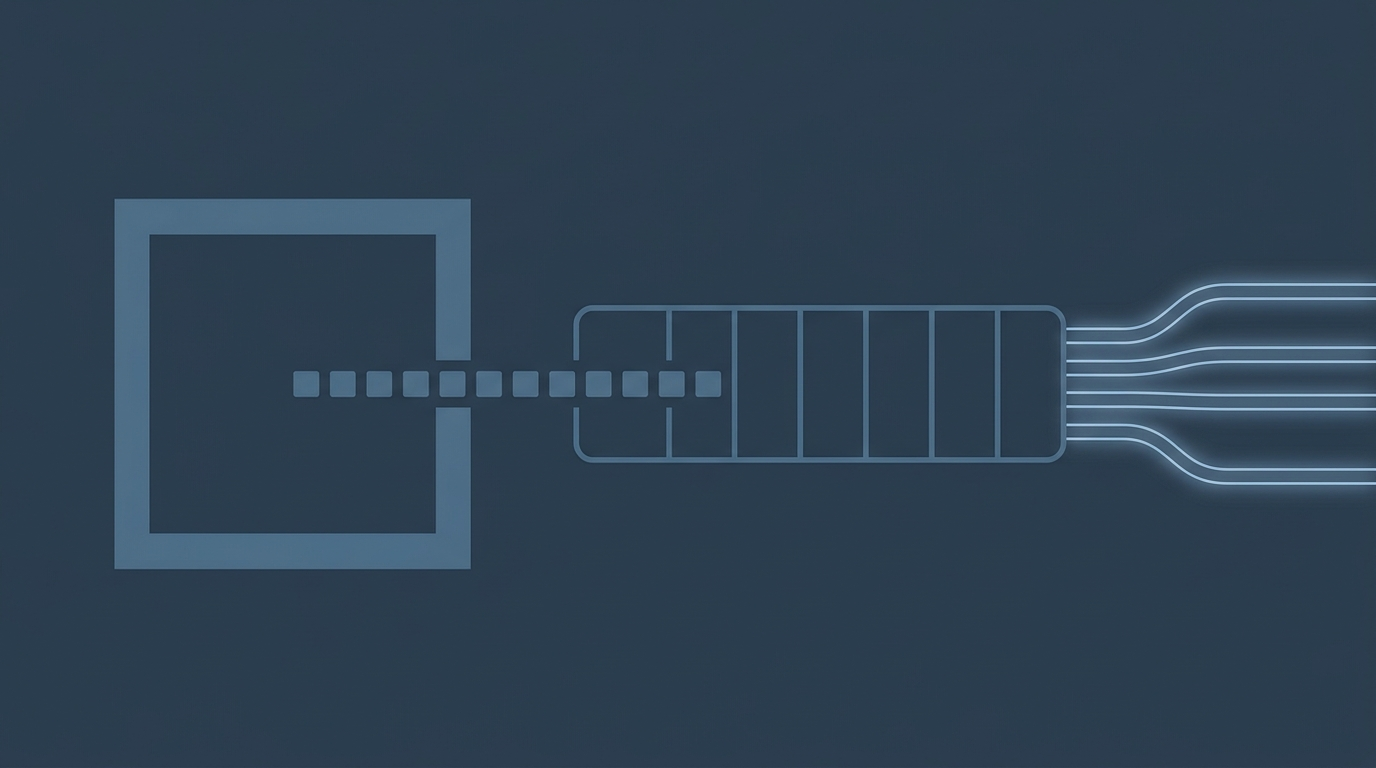
为了解决这个问题,Tailscale 修改包处理逻辑,让数据包留在原地。他们在大读取操作里直接标记每个包的起止位置,让众多小包在内存里共享同一次分配,并用内部的分隔符切分。这种减免内存复制的底层改造,在多种硬件配置下带来约 5% 吞吐提速。在底层网络栈优化中,解决内存碎片与过度分配问题,收益往往比死磕加密算法更直接。
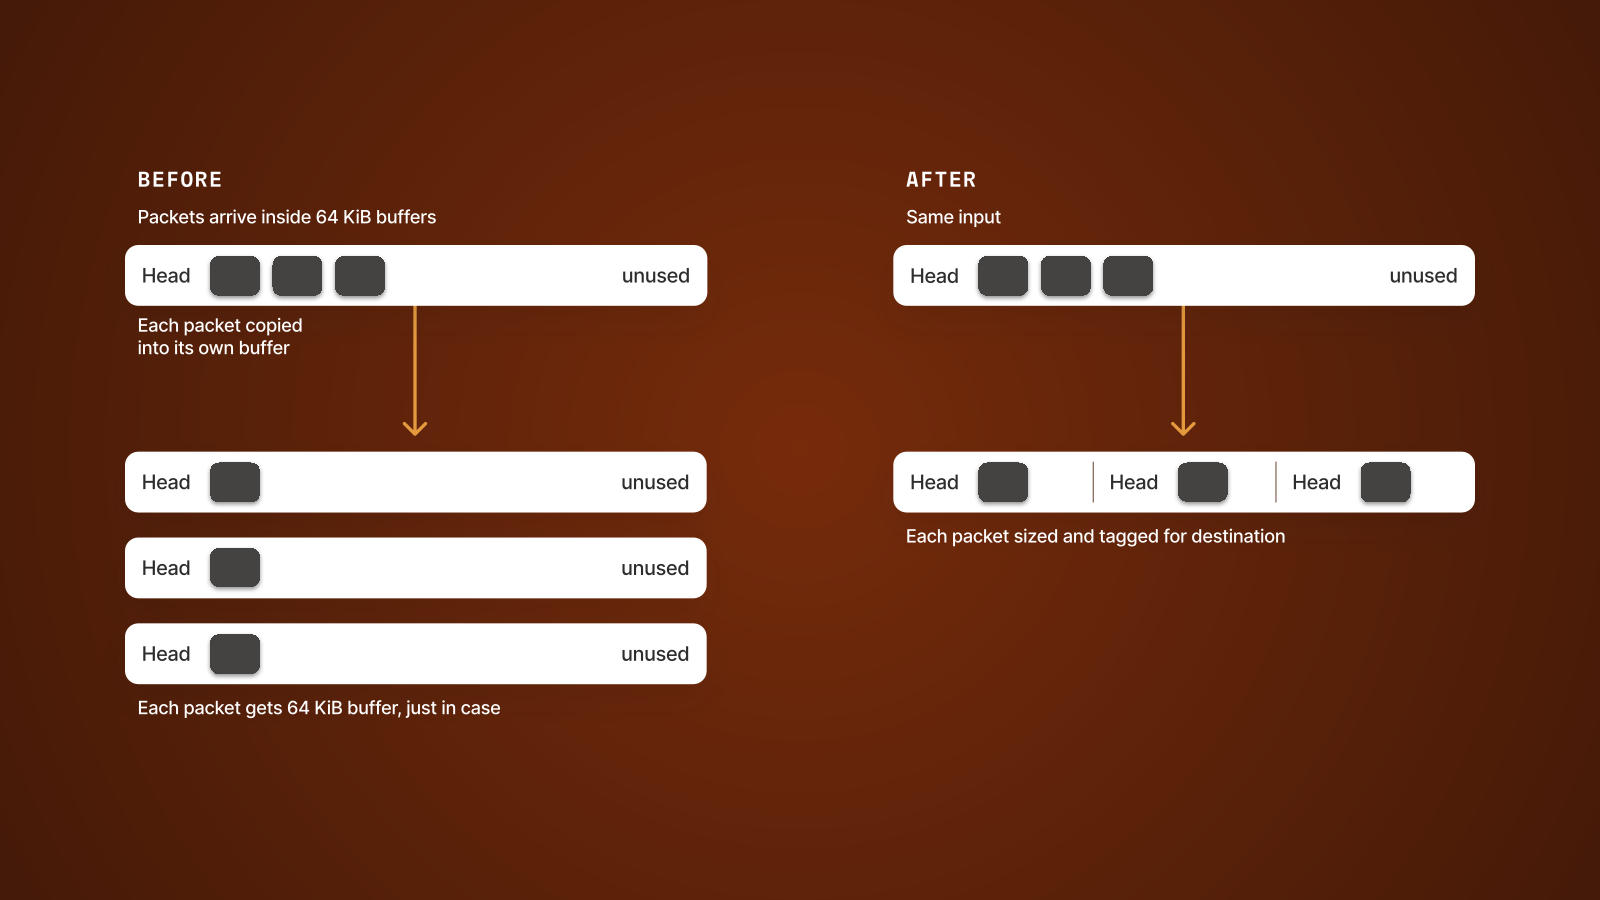 图:三个包各复制进独立 64 KiB 缓冲,改为按目的地标记后并入单一缓冲并用分隔符切分。来源:Tailscale 博客
修掉内存浪费换来多队列本钱
这 5% 提速并不是优化的终极目标。修掉 1 KiB 小包独占 64 KiB 的浪费后,系统省下了规模庞大的内存空间。这笔被释放的内存,转手变成 subnet router、app connector 和 exit node 开启多核并行的本钱。硬件资源的有效释放,为架构级别的重构铺平了道路。
过去 subnet router 和 exit node 走的是单条有序单线程流水线。应用层通常不能容忍发出的数据包乱序。旧设计为了维持状态的一致与稳定,把多核 CPU 按在单线程瓶颈上运转。现在,Tailscale 把传统单流水线改成了多队列架构,划分出多条并行的 lane。新架构按机器真实资源扩展处理能力,绕开了 peer 数量的限制。
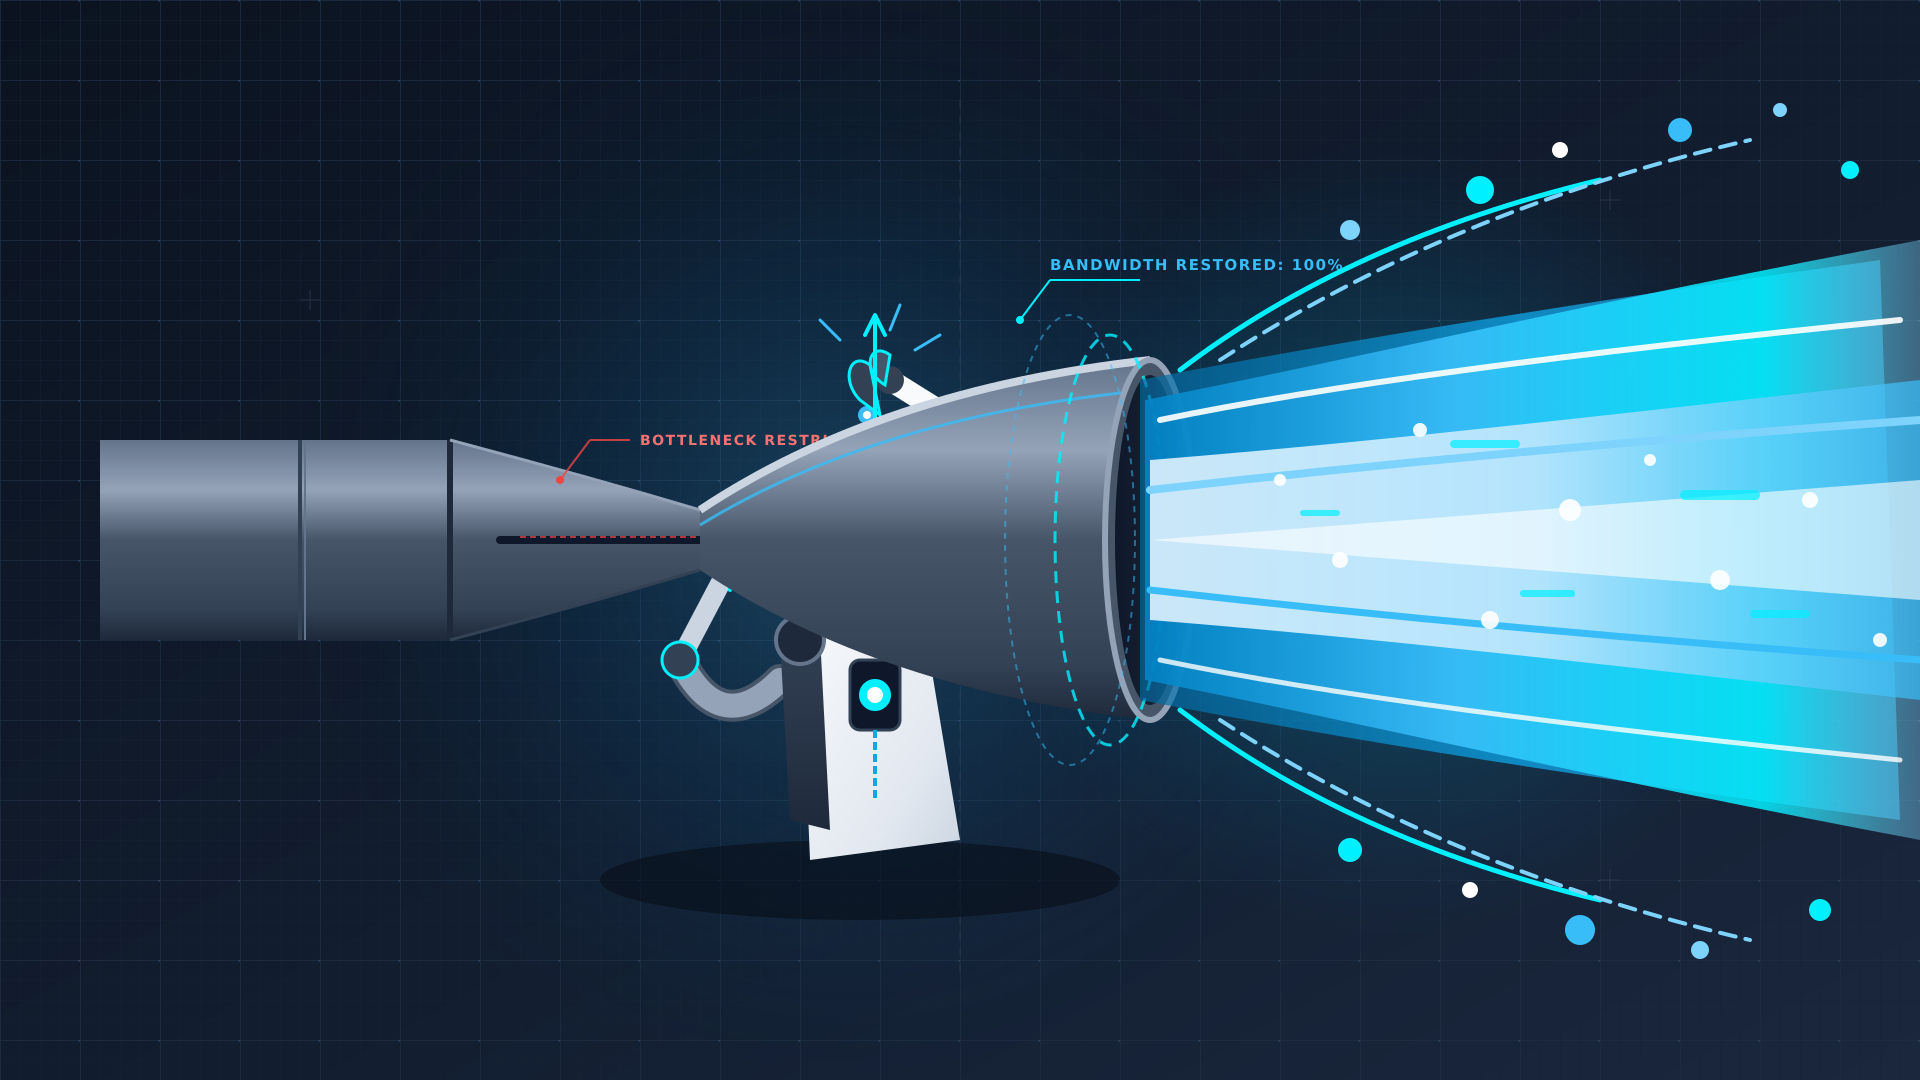
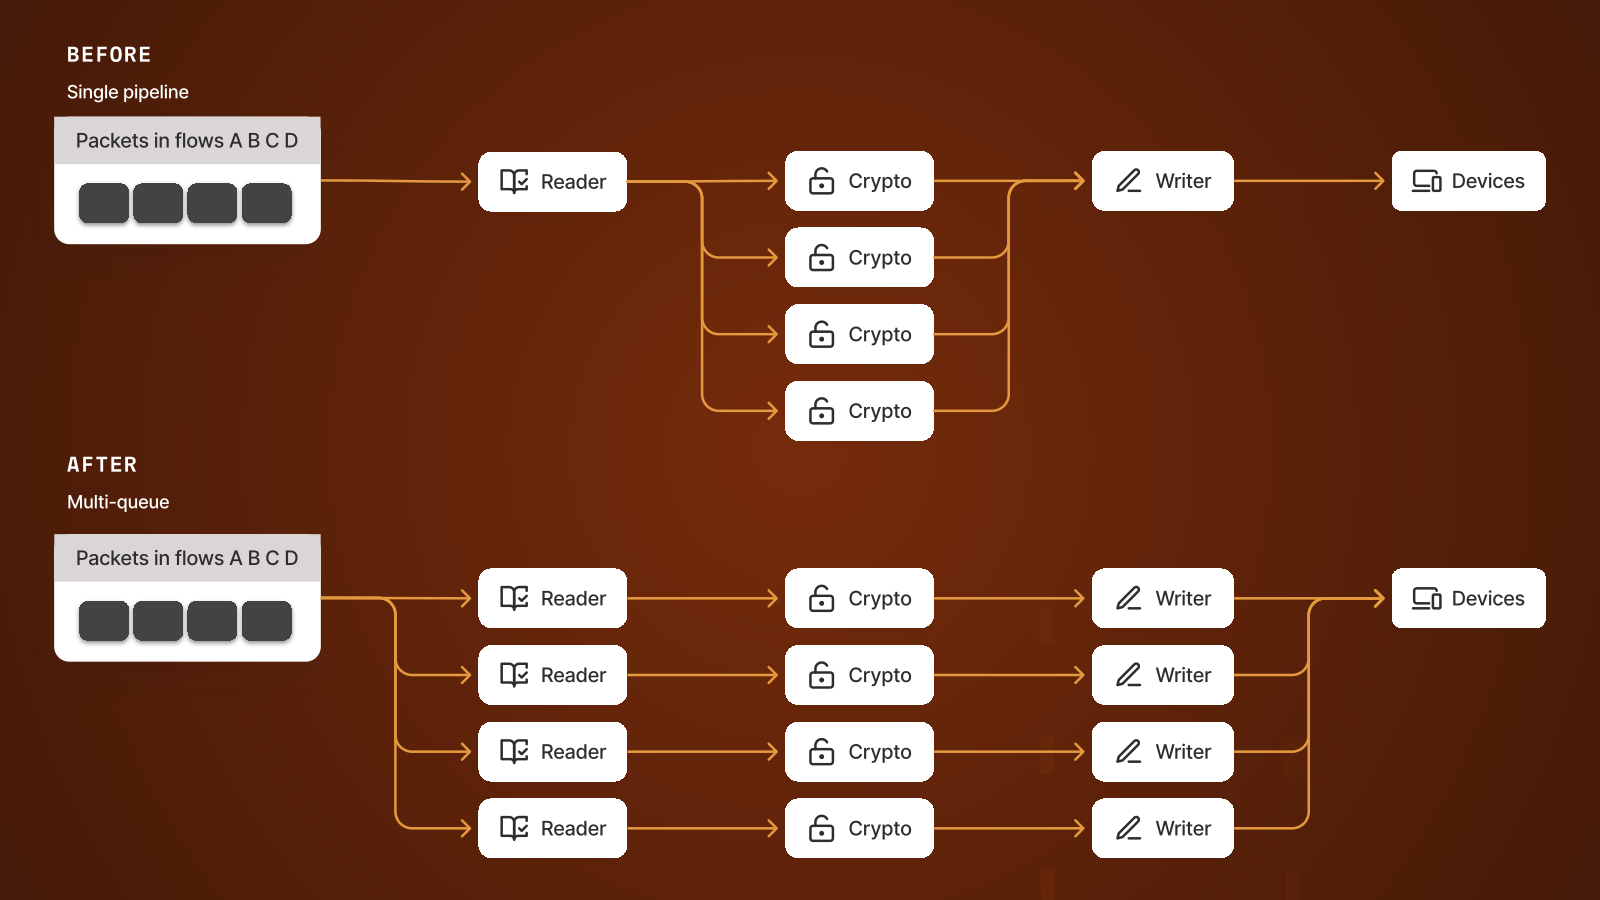 图:单流水线与多队列架构对比,每条流固定一条 lane。来源:Tailscale 博客
新设计里每条数据流固定走一条 lane,多条 lane 保持并行运作,工作负载均匀摊给多核处理器。对于大量处理短连接的端点节点来说,这种并发设计带来的收益非常明显。Tailscale 工程师 Alex Valiushko 证实,从读包到交还操作系统的全流程明显变快,端到端延迟显著降低。并发改造的前提,是先在底层榨出足够支撑线程开销的内存余量。
缩短队列深度让 writev 接管搬运
除了并发架构,流水线内部的队列长度也是此次优化的关键靶点。研发团队动手大幅缩短了流水线各处理阶段之间的数据包队列。在生产级别的压力测试中,他们发现大部分预设的超长队列深度根本没被用到。缩短队列不仅减少无谓的内存开销,还直接削减了数据包在系统内部的排队时间。工程链路上的默认参数,在生产环境实际压力下往往显得臃肿多余。
向操作系统交付出站数据时,Tailscale 启用了 Linux 系统的 writev 调用。传统做法是先在用户态把多段零散包数据拷贝合并,再统一交付给内核。现在利用 writev 的 vector 机制,程序只需向内核描述搬运片段的具体内存位置。这种机制允许把多段包数据一次性批量交给内核处理,省去了实际搬动过程。
大幅减少内存拷贝和写系统调用次数,让数据出站流程变得轻盈。将内存拼接工作直接下放给系统底层,是高性能网络编程领域标准的提效做法。凡是内核能用指针解决的搬运工作,用户态程序就不应该主动去分配内存。
| 优化项 | 改动 | 收益 | 时间 |
|---|---|---|---|
| 小包内存布局 | 包留在原地标记起止,共享一次分配 | 多配置下约 5% 提速 | v1.104(Linux/Android) |
| 队列深度 | 缩短流水线阶段之间的队列 | 减少排队时间与内存开销 | v1.104 前后 |
writev 出站 | 多段数据一次交给内核 | 减少拷贝与写调用 | 2026 春季起部分落地 |
| 多队列 | 单流水线改为多 lane 并行 | 按机器资源而非 peer 数扩展 | v1.104 之后的版本 |
| netmap 缓存 | netmap 写入本地磁盘,启动先用缓存建连 | warm start 快 1–2 个数量级 | v1.104 默认开启(移动端更晚) |
磁盘存下 netmap 对抗弱网环境
机器首次连接 Tailscale 网络时,通常要先与远端控制面通信,获取描述所有可达路径的 netmap。在典型城市网络下,这个协商与拉取过程仅需约 100 毫秒。但在万米高空的飞机 Wi-Fi 或设有激进过滤规则的酒店网络中,建连可能需要耗费很久。即便只有 100 毫秒的起步延迟,对于某些高度延迟敏感的负载也显得过于漫长。
为了应对复杂弱网环境,Tailscale 引入了全新的 netmap 缓存机制。开启该功能后,本地设备会将拉取到的 netmap 持久化保存到磁盘上。下次系统启动时,设备优先使用本地缓存副本与目标节点建立直连,直到能顺利联系上控制面。在这段脱机时间里,设备间的直连协商在本地直接进行,官方看不到流量细节。在控制面可达性极差的 tailnet 中,warm cache 机制让启动速度比冷启动快了 1 到 2 个数量级。
这种精巧机制同样存在不可忽视的物理边界。设备必须成功连接过一次网络才能建立初版缓存,且设备本身需要具备持久化磁盘。如果 tailnet 规模超大且内部节点更新频繁,高频更新缓存势必会带来大量磁盘写入操作。官方为此明确建议,在 SD 卡等磨损敏感的存储介质上不要开启此功能。应对网络不确定性的有效策略,就是把强依赖强制转化为本地的磁盘缓存。
协议演进面对真实平台限制
在 Hacker News 社区热议中,有用户直接质问为何不使用内核版的 WireGuard 以获取极限性能。Tailscale 联合创始人亲自下场回应,指出工程现实远非纸面推理那般简单。在过去某段时期内,由于用户态优化做得更好,wireguard-go 的运行速度曾一度反超内核版。内核版随后也大举吸收了这些优秀改进,目前两条技术路线正在互相促进。
关于后量子加密的学术性讨论同样异常热烈。有安全人士提出给 WireGuard 增加抗量子支持会导致密钥膨胀和握手逻辑复杂化,不如直接使用古老的 IPsec 方案。联合创始人的看法是,WireGuard 迟早需要演进到 v2 版本来应对新挑战,只要坚持无在线协商原则并继续走 UDP,它就会比 IPsec 简单得多。协议的长久生命力在于守住架构的极简底线。
在海量终端设备上,应用层性能同样会受操作系统底层机制的硬性制约。当用户不解地询问 Apple TV 作为 exit node 带宽异常低下的原因时,官方给出的最终答案指向了 tvOS 的进程管理策略:系统会随机杀掉后台活动过多的应用,这超出了 Tailscale 软件层的控制范围。现有的性能测试工具同样面临局限,不少知名工具不支持 QUIC 协议,也无法感知连接走的是 DERP 还是直连。平台限制和工具滞后,构成了当今网络工程师每天都要面对的真实物理边界。
参考链接:
- Tailscale 官方博客:We’re making Tailscale faster
- Hacker News 关于 Tailscale 提速的讨论